3.4 堆与优先队列:完全二叉树的数组修炼
3.4 堆与优先队列:完全二叉树的数组修炼
本节摘要:堆只维护一条松散纪律——每个节点不大于(最小堆)或不小于(最大堆)自己的孩子,父子之间无序、兄弟之间无序。这条"半序"刚好够支撑两件事:堆顶永远是全局最值,取出 O(log n);插入新元素 O(log n)。完全二叉树的形状让堆可以住进数组,无指针、缓存友好。本节实现上浮与下沉,数清交换次数,并给出去重、TopK 等优先队列的工程用法。
只保证爹压过孩子,够用吗
BST 要求"左全小于根、右全大于根",维护起来要旋转、要平衡。堆问了一个反向问题:如果只要求每个爹不大于自己的孩子(最小堆),能换到什么?答案:堆顶必是全局最小值——因为从任意节点往上看,父总不大于子,一路传到根。取最值从"查找"变成"伸手",O(1)。
代价是半序换掉了全序:堆里除堆顶外的任何位置都无信息,第二小的元素可能在根的左右孩子任一处。所以堆不擅长"按序遍历全部"(那是 BST 的主场),专精"反复取最值"——这个需求场景有个正式名字:优先队列,出队顺序按优先级而非先来后到(呼应 2.4 节的预告)。
堆住在数组里:下标就是亲子关系
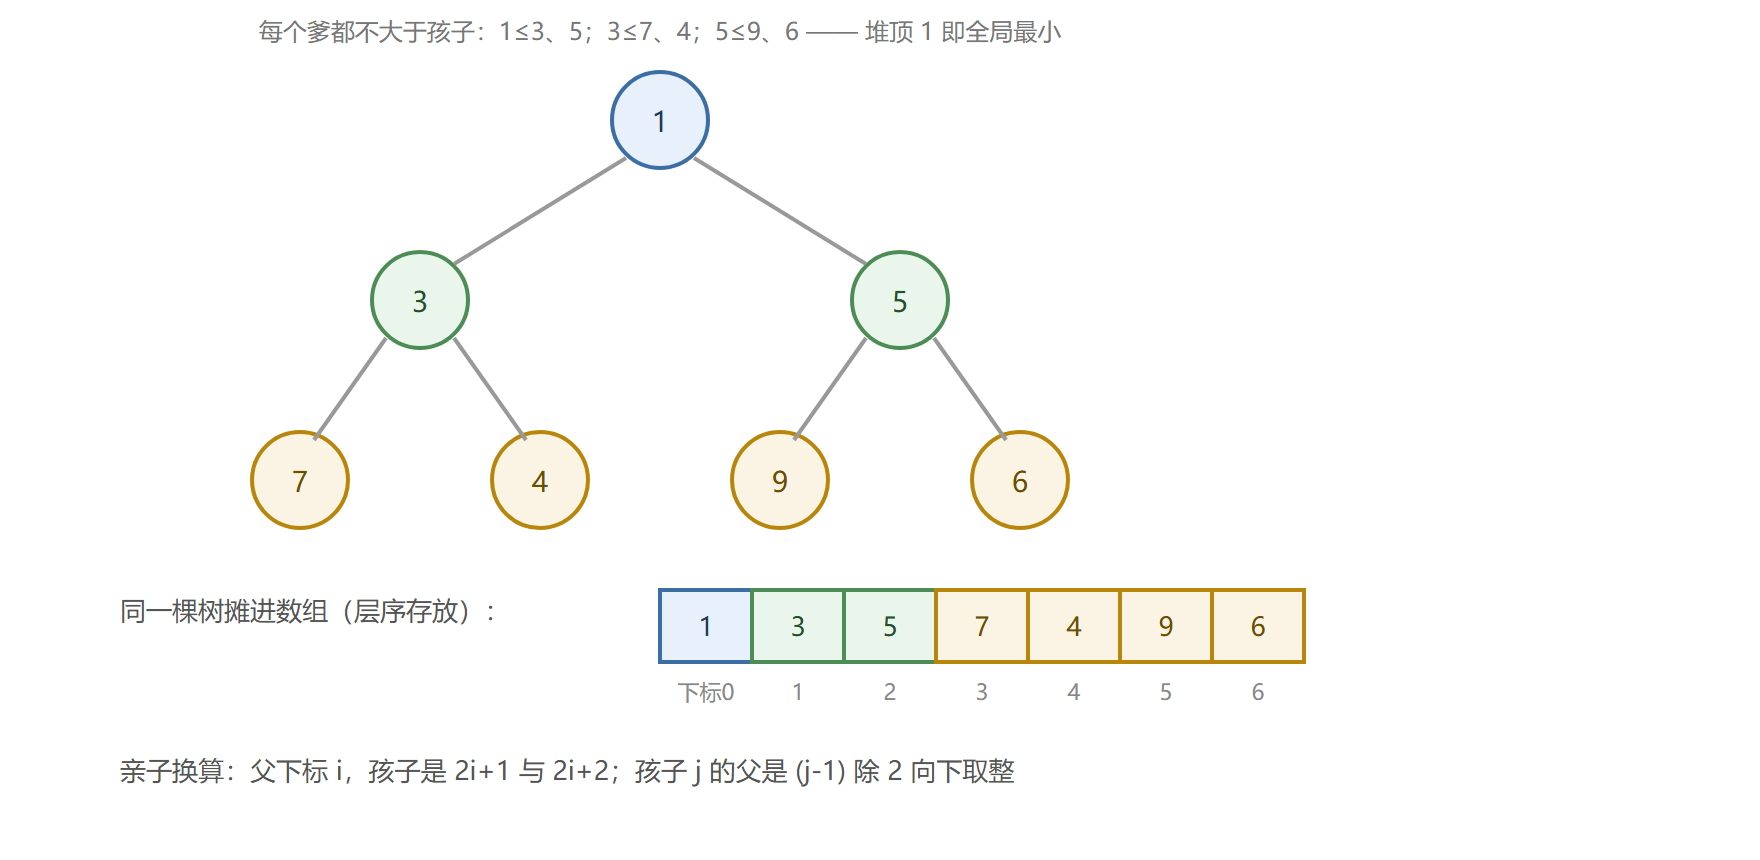
堆的形状被限定为完全二叉树(只许末层靠左缺,见 3.1 节),于是层序存放进数组后,亲子关系退化成下标算术:父 i 的孩子在 2i+1 与 2i+2,孩子 j 的父在 (j-1) 取半。没有指针、没有旋转、没有额外内存——数组堆是"形状换存储"的最划算交易。
两式内功:上浮与下沉
堆的全部动态行为由两式构成:
- 上浮(sift up):新元素先接在数组尾部(保持完全二叉树形状),只要它比父小就和父交换,一路向上;
- 下沉(sift down):堆顶被取走后,把末尾元素补到堆顶,选两个孩子中较小者交换,一路向下。
# 最小堆:push 走上浮,pop 走下沉,交换次数全程计数 class MinHeap: def __init__(self): self.a, self.swaps = [], 0 def push(self, x): self.a.append(x) # 先放到末位保形状 i = len(self.a) - 1 while i > 0: # 上浮:比父小就换 p = (i - 1) // 2 if self.a[i] < self.a[p]: self.a[i], self.a[p] = self.a[p], self.a[i] self.swaps += 1 i = p else: break def pop(self): top = self.a[0] last = self.a.pop() # 末尾元素 if self.a: self.a[0] = last # 顶替堆顶,再下沉 i, n = 0, len(self.a) while True: l, r, m = 2*i + 1, 2*i + 2, i if l < n and self.a[l] < self.a[m]: m = l # 选较小的孩子 if r < n and self.a[r] < self.a[m]: m = r if m == i: break self.a[i], self.a[m] = self.a[m], self.a[i] self.swaps += 1 i = m return top h = MinHeap() for x in (5, 3, 8, 1, 9): before = h.swaps h.push(x) print(f"push {x}:交换 {h.swaps - before} 次,当前堆数组 = {h.a}") # 输出: # push 5:交换 0 次,当前堆数组 = [5] # push 3:交换 1 次,当前堆数组 = [3, 5] # push 8:交换 0 次,当前堆数组 = [3, 5, 8] # push 1:交换 2 次,当前堆数组 = [1, 3, 8, 5] # push 9:交换 0 次,当前堆数组 = [1, 3, 8, 5, 9] order = [] while h.a: order.append(h.pop()) print("依次弹出:", order) # 输出:依次弹出: [1, 3, 5, 8, 9](全部按升序出队——每次都取全局最小)
上浮与下沉每层至多一次交换,路径长度等于树高,完全二叉树高为 log₂n,故 push 与 pop 都是 O(log n);看堆顶 O(1)。弹 n 次得到升序序列,这正是第五章堆排序的雏形。
建堆:从乱数组原地起一座堆
把乱序数组原地整理成堆,不必逐个 push(那是 O(n log n))。更快的方法:从最后一个非叶节点倒着到根,逐个下沉。直觉账:一半的节点是叶子(下沉零层)、四分之一的节点至多下沉一层……总交换次数是 Σ 各层节点数乘该层高度,收敛到 n,建堆是 O(n)。
# heapq:标准库的堆(同样算法的工业实现) import heapq nums = [7, 2, 9, 4, 1] heapq.heapify(nums) # 原地建堆,O(n) print("建堆后数组:", nums) # 输出:建堆后数组: [1, 2, 9, 4, 7] # 注意:数组并非完全有序,只保证每个爹不大于孩子 heapq.heappush(nums, 0) print("推入 0 后堆顶:", nums[0]) # O(log n) # 输出:推入 0 后堆顶: 0 print("弹出前三个最小值:", heapq.heappop(nums), heapq.heappop(nums), heapq.heappop(nums)) # 输出:弹出前三个最小值: 0 1 2
Python 的 heapq 是最小堆;要最大堆,常见做法是存负数或把键包一层取反的包装。Java 的 PriorityQueue、C++ 的 priority_queue 同族,默认比较方向各有约定,使用前查清。
优先队列的工程战场
- 任务调度:操作系统与线程池按优先级取任务执行,任务随时到来(push)、执行器总取最高优先级(pop);
- 定时器:把到期时间做键的最小堆,堆顶就是最近的闹钟;
- Dijkstra 算法:第四章 4.3 的核心引擎——"当前离源点最近的未定型节点"由堆顶供给;
- TopK 与流式统计:海量数据找最大的 k 个,维护一个 k 容量的小堆,新元素比堆顶大就替换;总代价 n·log k,远优于全量排序的 n·log n;
- 合并 k 路有序序列:每路头部进堆,反复取堆顶补后继,是外部归并与日志合并的标准件。
⚠️ 常见坑:把堆数组当有序数组用。建堆后直接顺序遍历不等于升序——半序结构只有堆顶有位置信息。要全序就得反复 pop(第五章堆排序的做法),或干脆用别的结构。
💡 关键直觉:TopK 用"小堆装最大 k 个"看似别扭,实则是关键一步:堆顶是这 k 个里最小的,正好充当"入场门槛",新元素只需要和门槛比一次,败者连堆都不用进。
走火入魔:两起堆类事故
**事故一:改了堆里元素的优先级字段而不做修复。**堆的纪律建立在"元素间比较结果不变"上,业务对象入堆后修改其权重字段,堆序即刻作废,pop 出的顺序不可信。正确做法:不入堆可变对象,或改完后重新建堆;进阶做法(索引堆、延迟删除)在算法竞赛与网络模拟器里常见。
事故二:TopK 方向选反。找"最大 k 个"要建小堆、拿堆顶当门槛;建大堆的话门槛是当前最大值,新元素几乎全部进不了堆——除非你只想要一个最大值。方向口诀:要什么,堆顶就是什么的反义词当门槛。
本节要点回顾
- 堆的心法是半序:每个爹不大于孩子(最小堆);堆顶即全局最值,但其余位置无序,堆不替代排序;
- 完全二叉树住进数组:父 i 孩子 2i+1 与 2i+2,下标算术取代指针,形状天然成立;
- 两式内功:push 尾插后上浮、pop 末位补顶后下沉,每层至多一次交换,均 O(log n);
- 建堆 O(n):从最后一个非叶节点倒着下沉,总交换次数收敛于 n,优于逐个 push 的 n log n;
- 优先队列四战场:调度、定时器、Dijkstra、TopK 与 k 路归并;TopK 的方向口诀别用反。
至此 BST 与堆两条线都通了一个词:"有序"。下一节把"有序"搬到字符串上——按字符逐层定位的 Trie。