3.5 Trie 前缀树:字符串的逐层定位术
3.5 Trie 前缀树:字符串的逐层定位术
本节摘要:Trie 把一堆字符串按"逐字符分叉"摊成一棵树,公共前缀共享同一条链。查找一个长度为 L 的词只需沿树走 L 步,与词库总量无关。它专治前缀类问题:自动补全、拼写检查、敏感词过滤、路由前缀匹配。本节实现 Trie 三招(插入、精确查找、前缀查找),算清它的时间账与空间账。
把字典摊成一棵树
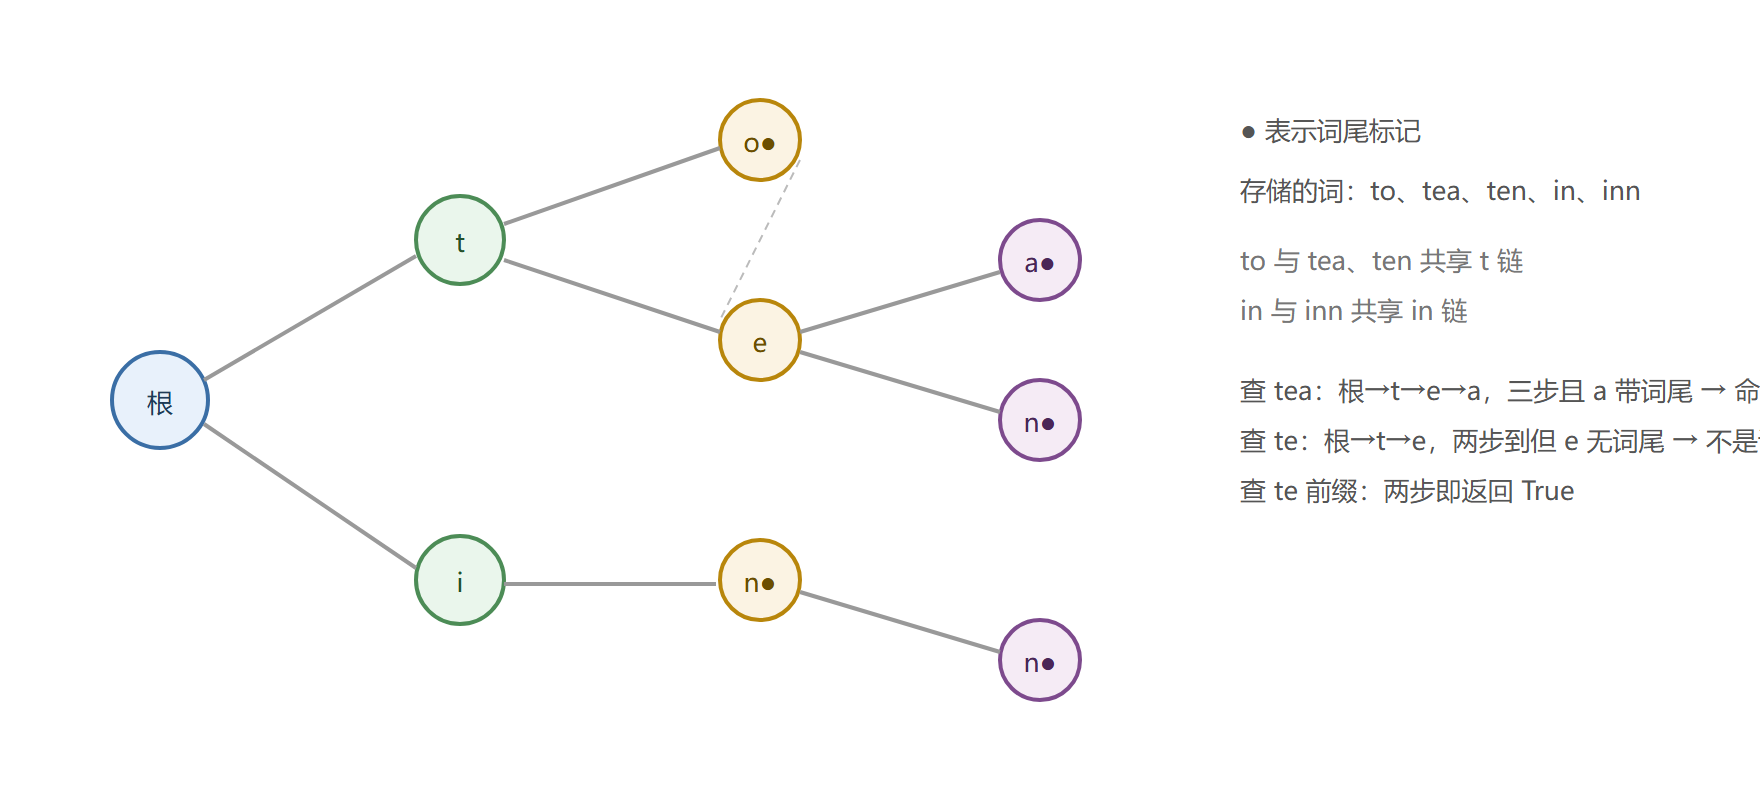
哈希表回答"这个词在不在"很快,但答不了"以这几个字符开头的词有哪些"。要按前缀组织,就得把每个词沿字符拆开、一层层挂到树上:第一层是首字符,第二层是第二个字符……公共前缀共享路径,分叉发生在第一个不同字符处。词的结束用"结束标记"注明——否则"ca"会误判为单词"cat"的一部分。
一棵装着五个词的 Trie
# Trie 三招:插入、精确查找、前缀查找 class TrieNode: def __init__(self): self.children = {} # 字符 → 子节点 self.is_end = False # 词尾标记 class Trie: def __init__(self): self.root = TrieNode() self.nodes = 1 # 顺便记账:节点总数 def insert(self, word): node = self.root for ch in word: # 沿字符逐层走,缺则建 if ch not in node.children: node.children[ch] = TrieNode() self.nodes += 1 node = node.children[ch] node.is_end = True # 末字符打词尾标记 def _walk(self, s): node, steps = self.root, 0 for ch in s: if ch not in node.children: return None, steps # 链断:前缀都不存在 node = node.children[ch] steps += 1 return node, steps def search(self, word): # 精确查找:走到且带词尾 node, steps = self._walk(word) return (node is not None and node.is_end), steps def starts_with(self, prefix): # 前缀查找:走到即可 node, steps = self._walk(prefix) return node is not None, steps t = Trie() words = ["to", "tea", "ten", "in", "inn"] for w in words: t.insert(w) for q in ("tea", "te", "ten", "inn", "tx"): hit, steps = t.search(q) print(f"search({q!r}) = {hit}(走了 {steps} 步)") # 输出: # search('tea') = True(走了 3 步) # search('te') = False(走了 2 步) # search('ten') = True(走了 3 步) # search('inn') = True(走了 3 步) # search('tx') = False(走了 1 步) for q in ("te", "in", "i"): hit, steps = t.starts_with(q) print(f"starts_with({q!r}) = {hit}(走了 {steps} 步)") # 输出: # starts_with('te') = True(走了 2 步) # starts_with('in') = True(走了 2 步) # starts_with('i') = True(走了 1 步)
步数与查询串长度严格相等,与词库存了多少词无关——这就是 Trie 的时间账:插入与查找都是 O(L),L 为串长。对比哈希表:两者查找都近常数,但"前缀查询"哈希表无能为力,只能全量扫描一遍键。
空间账:共享前缀是租金抵扣
Trie 的节点数取决于前缀共享程度。上面五个词共十三个字符,实际只建了九个节点:t、e、in 三条链被共享。算一笔可见的账:
# 空间账:节点数 vs 字符总数 total_chars = sum(len(w) for w in words) print("词表:", words) print("字符总数 =", total_chars, ";Trie 实际节点数 =", t.nodes, "(不含根则为", t.nodes - 1, ")") # 输出:字符总数 = 13 ;Trie 实际节点数 = 9 (不含根则为 8 ) # to/tea/ten 共享 t,tea/ten 共享 te,in/inn 共享 in——共享越多,省得越多 worst = ["a", "b", "c", "d"] t2 = Trie() for w in worst: t2.insert(w) print("无共享的四个单词:字符数 =", sum(len(w) for w in worst), ",节点数 =", t2.nodes - 1) # 输出:无共享的四个单词:字符数 = 4 ,节点数 = 4 # 完全无共享时节点数等于字符总数,Trie 白付指针开销
两个极端摆在一起,结论清楚:前缀密集(域名、路由表、代码补全词库)时 Trie 大赚;键之间毫无共享时 Trie 只是带指针的哈希表,还要每个节点背一份字典开销。
工程战场与变体
- 输入法与 IDE 自动补全:用户敲前缀,沿 Trie 走到末节点,其子树展开就是全部候选;常在节点里再挂"词频排序的候选列表"加速;
- 拼写检查:Trie 上做受限编辑距离的深度优先(只在允许的编辑步数内下探);
- 敏感词过滤:把违禁词建 Trie,扫描文本时每个位置沿树匹配,命中即替换;AC 自动机(Trie 加失配指针)是其工业化版本,与第七章 KMP 的失配思想同宗;
- 路由前缀匹配:网络路由表按前缀聚合 IP 段,Trie(按比特分叉的变体)是标准数据结构;
- 词频统计与排序输出:在节点上计数,一次深度优先即可按字典序遍历全部词。
⚠️ 常见坑:把 search 与 starts_with 混为一谈。少查一个 is_end 标记,"te" 就会被当成词返回——插入时忘记置词尾、查找时忘记验词尾,是 Trie 习题里出错率最高的一对孪生 bug。
💡 关键直觉:哈希表是"整键定位",Trie 是"逐字符定位"。逐层定位牺牲一点常数,买到了前缀结构——先想清楚问题要不要前缀,再决定用哪个。
走火入魔:超长键与字符爆炸
**事故一:拿 Trie 存超长且彼此雷同度低的键。**键长百万级、彼此几乎无共享(比如随机串、哈希值串),Trie 会生成又深又瘦的链,空间与建树时间都被字符数放大。这类场景哈希表直接按整键定位,效率高得多。
**事故二:每节点开足字符表。**用数组给孩子留满每个可能字符的位置(比如 ASCII 一百二十八格),节点瞬间膨胀。稀疏情况改用字典(如本节实现)或有序数组;仅在字符集极小且查询极热的场景(如基因序列的 ACGT 四字符)才值得定长数组换速度。
本节要点回顾
- Trie 心法:字符串按字符摊成树,公共前缀共享路径,词尾标记区分"词"与"前缀";
- 时间账:插入与查找均 O(L)、与词库规模无关;前缀查询是哈希表做不到的独门本事;
- 空间账:节点数等于"不同前缀的个数",共享密集大赚、无共享时白付指针开销;
- 四大战场:自动补全、拼写检查、敏感词过滤(AC 自动机为其工业化版本)、路由前缀匹配;
- 两起事故:超长无共享键撑爆空间、每节点开满字符表——都源于没先算空间账。
树形五门心法至此练完。下一章把树松绑到极致——任何节点都可以与任何节点相连,图登场。