5.1 冒泡、选择、插入:入门三式
5.1 冒泡、选择、插入:入门三式
本节摘要:入门三式都是平方级比较排序,但各有脾气:冒泡相邻交换、可提前收手;选择排序交换最少但天生不稳;插入排序对"基本有序"的数据近线性,是工业级排序的小区间引擎。本节实现三式并数出各自的比较与搬移次数,讲清稳定性这一关键属性。承接第一章的操作计数与第二章的数组搬移账。
三式同门,路数各异
先立一个共同背景:三式都直接在数组上工作(原地),都靠"比较 + 搬移"逐步建立有序区。差别在有序区从哪头建、靠什么扩张:
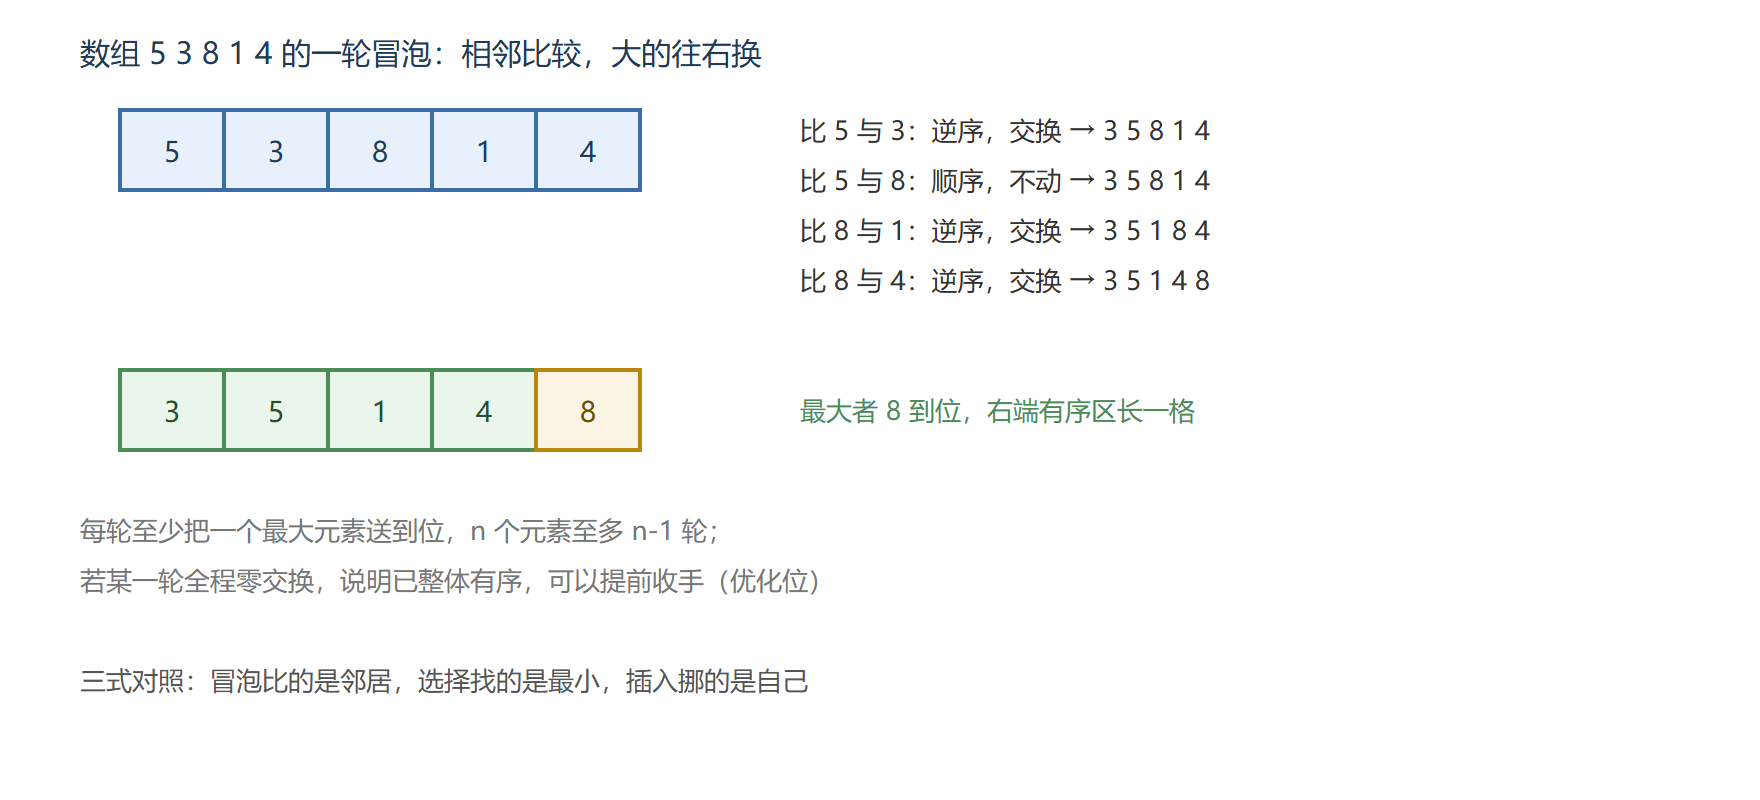
- 冒泡:多轮扫描,每轮比较相邻两元素,逆序就交换——最大的元素像气泡逐轮浮到末尾,有序区从右端生长;
- 选择:每轮从未排序区挑出最小者,与未排序区头部交换——有序区从左端生长,每轮恰好一次交换;
- 插入:把下一个元素拿到手里,在已排序区从右向左找位置,边找边挪——像整理扑克牌,有序区从左端生长。
冒泡排序一轮的现场
# 三式实现:比较与搬移全程计数 def bubble(a): a = a[:]; cmp = swap = 0 n = len(a) for i in range(n - 1): exchanged = False for j in range(n - 1 - i): # 右端 i 格已有序 cmp += 1 if a[j] > a[j + 1]: a[j], a[j + 1] = a[j + 1], a[j] swap += 1 exchanged = True if not exchanged: # 零交换:提前收手 break return a, cmp, swap def selection(a): a = a[:]; cmp = swap = 0 n = len(a) for i in range(n - 1): m = i for j in range(i + 1, n): # 在未排序区找最小 cmp += 1 if a[j] < a[m]: m = j if m != i: a[i], a[m] = a[m], a[i] # 每轮至多一次交换 swap += 1 return a, cmp, swap def insertion(a): a = a[:]; cmp = move = 0 for i in range(1, len(a)): key = a[i]; j = i - 1 # 手里拿着下一张牌 while j >= 0: cmp += 1 if a[j] > key: a[j + 1] = a[j] # 大牌右挪一格 move += 1 j -= 1 else: break a[j + 1] = key # 落座 return a, cmp, move data = [5, 3, 8, 1, 4] for name, fn in [("冒泡", bubble), ("选择", selection), ("插入", insertion)]: out, c, m = fn(data) print(f"{name}:结果 {out},比较 {c} 次,搬移/交换 {m} 次") # 输出: # 冒泡:结果 [1, 3, 4, 5, 8],比较 10 次,搬移/交换 6 次 # 选择:结果 [1, 3, 4, 5, 8],比较 10 次,搬移/交换 2 次 # 插入:结果 [1, 3, 4, 5, 8],比较 8 次,搬移/交换 6 次
同一输入,比较次数几乎打平(五元素近满额十次上下),但选择排序的交换只有三次——数据搬移极贵(比如超大记录、闪存写放大)的场景,这是它的独门价值。三式时间都是 O(n²) 量级:比较满额约 n(n-1)/2 次。
稳定性:相等元素的座次保卫战
排序的稳定性指:键相等的两个元素,排序后是否保持原先的先后。冒泡(相等不交换)与插入(遇相等即停)稳定;选择排序不稳——最小者与头部交换时,可能一跃越过若干相等元素。演示:
# 稳定性演示:元组按第一关键字排序,第二关键字记录原序 pairs = [(2, "甲"), (2, "乙"), (1, "丙")] def sel_key(pairs): # 选择排序按第一关键字 pairs = pairs[:] for i in range(len(pairs) - 1): m = i for j in range(i + 1, len(pairs)): if pairs[j][0] < pairs[m][0]: m = j pairs[i], pairs[m] = pairs[m], pairs[i] return pairs print("选择排序结果:", sel_key(pairs)) # 输出:选择排序结果: [(1, '丙'), (2, '乙'), (2, '甲')] # 第一轮 (1,'丙') 与队首交换,一跃越过了 (2,'乙')——两个 2 的原序被翻转,不稳定 def ins_key(pairs): # 插入排序按第一关键字 pairs = pairs[:] for i in range(1, len(pairs)): key = pairs[i]; j = i - 1 while j >= 0 and pairs[j][0] > key[0]: # 严格大于:相等即停 pairs[j + 1] = pairs[j] j -= 1 pairs[j + 1] = key return pairs print("插入排序结果:", ins_key(pairs)) # 输出:插入排序结果: [(1, '丙'), (2, '甲'), (2, '乙')] # 同键原序保持——先按次要键排、再按主要键排,稳定排序能让次要序存活
稳定性真正的用武之地是多关键字排序:想按"部门再按工龄"排序,先按工龄排一遍、再按部门稳定地排一遍,工龄序就在各部门内部存活。数据库排序、电子表格多级排序都依赖这条性质。
插入排序的隐藏身价:近有序即近线性
插入排序的 while 循环在"新牌比已排好的尾部还大"时立即结束。输入越接近有序,提前结束越多,比较次数从平方级滑向线性:
# 近有序实验:同一规模的乱序与近有序输入 import random n = 2000 random.seed(9) chaos = list(range(n)); random.shuffle(chaos) nearly = list(range(n)) for _ in range(20): # 只打乱二十处,其余有序 i, j = random.randrange(n), random.randrange(n) nearly[i], nearly[j] = nearly[j], nearly[i] _, c_chaos, _ = insertion(chaos) _, c_nearly, _ = insertion(nearly) print(f"乱序 {n} 个元素:比较 {c_chaos} 次") print(f"近有序 {n} 个元素:比较 {c_nearly} 次") # 输出: # 乱序 2000 个元素:比较 1002879 次(平方量级,约为 n²/4) # 近有序 2000 个元素:比较 27069 次——每处打乱平均带来约千次挪移, # 与乱序的一百万次相比差近四十倍;打乱处越少,越贴近线性
正因如此,工业级排序(TimSort、内省排序)无一例外在小区间或近有序段切换到插入排序——5.2 节见分晓。
| 排序 | 最好 | 最坏 | 稳定 | 空间 | 一句话定位 |
|---|---|---|---|---|---|
| 冒泡 | O(n)(提前收手) | O(n²) | 稳定 | O(1) | 教学价值大于工程价值 |
| 选择 | O(n²) | O(n²) | 不稳 | O(1) | 交换次数最少(至多 n-1 次) |
| 插入 | O(n)(近有序) | O(n²) | 稳定 | O(1) | 小区间与近有序段的王者 |
⚠️ 常见坑:把"最好 O(n)"当成三式的日常。冒泡的提前收手、插入的立即停都依赖输入近有序;随机输入下它们就是平方级。评估排序要同时报最好、平均、最坏三格。
💡 关键直觉:逆序对(前面的数比后面大)是衡量"乱度"的硬指标。插入排序的比较搬移次数恰与逆序对个数同阶——乱度低它就快,这不是巧合,是它的计价方式。
走火入魔:误用三式的两个场景
**场景一:大数组上用三式扛性能。**十万数据平方级要做上十亿次比较,任何现代场景都不可接受。三式的合法地盘:几十到上百元素的小区间、基本有序的增量更新、教学演示。
**场景二:以为选择排序"每轮只交换一次所以最快"。**交换少是它的优点,但比较次数仍是满额平方级,且不稳定的代价常被忽略。记录搬运极贵且不在乎稳定性时才轮到它。
本节要点回顾
- 三式的生长方向与扩张手段不同:冒泡从右端浮、选择从左端选、插入从左端挪;
- 操作计数可复算:五元素实例中三式比较十次上下、选择仅三次交换;
- 稳定性:相等键保持原序;冒泡与插入稳定、选择不稳;多关键字排序依赖稳定;
- 插入排序按逆序对计价,近有序输入下近线性,是工业排序的小区间引擎;
- 三式定位:小区间与教学,不是大数据的兵器。
平方级的天花板压顶。下一节请出分治双雄——快速排序与归并排序,看对数级怎么来的。