5.2 快速排序与归并排序:分治双雄
5.2 快速排序与归并排序:分治双雄
本节摘要:快排与归并都用分治把排序压到平均 O(n log n),但刀法相反——快排先"切"(分区定轴点)再递归两侧,归并先"递归"再合(合并两个有序段)。快排原地、缓存友好、常数小,但有 O(n²) 最坏与递归深度风险;归并稳定、最坏仍 O(n log n),代价是 O(n) 辅助数组。本节逐步跟踪分区与合并,复现快排的最坏退化。
先切后合:两条相反的刀路
分治的骨架都是"分解、解决、合并"(第六章 6.1 系统展开),排序领域的两门绝学把顺序用反了:
- 快速排序:先干重活——选一个轴值做分区,比它小的全挪到左边、大的全挪到右边,轴值就此永远归位;然后左右两段各自递归。分解是主戏,合并不存在(拼接免费);
- 归并排序:先递归——把数组对半切到单个元素(天然有序),再两两合并有序段。分解是免费的(对半砍),合并是主戏。
两者都把问题规模每层减半,递归树高 log n,每层工作量 O(n),总量 O(n log n)。差异全在常数、稳定性与最坏情形。
Lomuto 分区:轴值的一次归位之旅
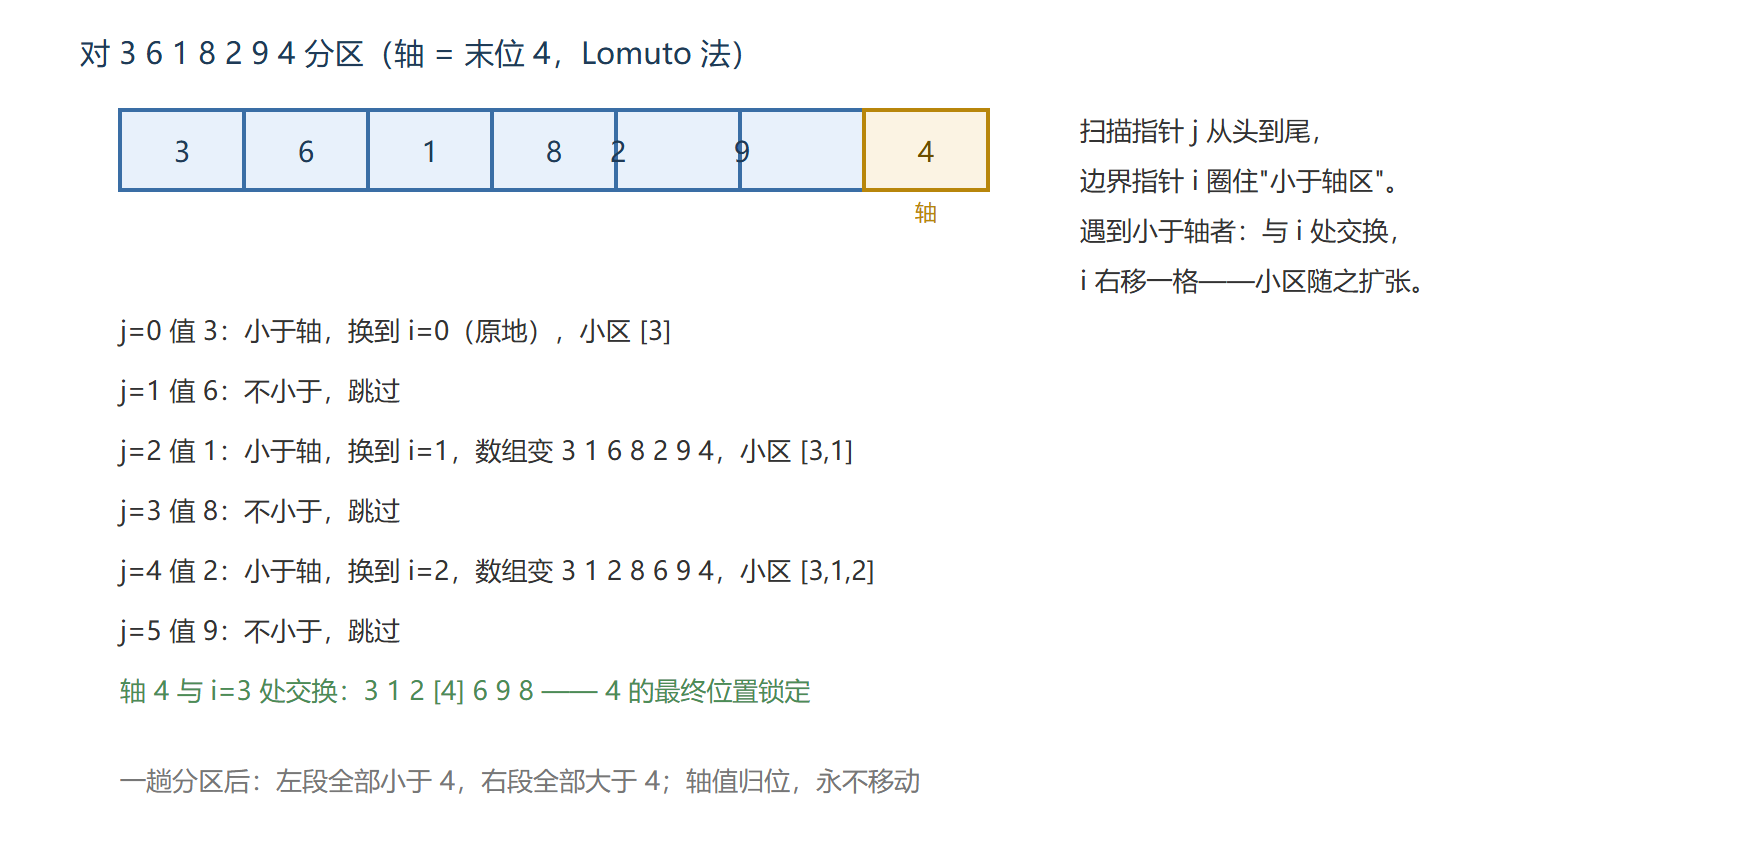
# 快速排序:Lomuto 分区 + 比较计数 def quicksort(a, lo=0, hi=None): if hi is None: hi = len(a) - 1 cmp = [0] # 用列表做可变计数器 def partition(a, lo, hi): pivot = a[hi] # 轴:取末位元素 i = lo # 小于轴区的右边界 for j in range(lo, hi): cmp[0] += 1 if a[j] < pivot: a[i], a[j] = a[j], a[i] i += 1 a[i], a[hi] = a[hi], a[i] # 轴归位到 i return i def rec(lo, hi): if lo >= hi: return p = partition(a, lo, hi) # 分解:轴归位 rec(lo, p - 1) # 解决:左右各自递归 rec(p + 1, hi) # 合并:无需动作 rec(lo, hi) return cmp[0] data = [3, 6, 1, 8, 2, 9, 4] total = quicksort(data) print("排序结果:", data, ",共比较", total, "次") # 输出:排序结果: [1, 2, 3, 4, 6, 8, 9] ,共比较 10 次 # 账目:首轮分区 6 次比较,左段 [3,1,2] 再 2 次,右段 [6,9,8] 再 2 次 # 首轮分区即上图过程:轴 4 归位下标 3,左右两段再各递归
再看它最著名的软肋——轴选歪时的退化:
# 退化实验:有序输入 vs 乱序输入(轴固定取末位) ordered = list(range(1, 9)) # 1..8 升序 c_ordered = quicksort(ordered[:]) import random random.seed(11) shuffled = list(range(1, 9)); random.shuffle(shuffled) c_shuffled = quicksort(shuffled[:]) print(f"有序输入 {ordered}:比较 {c_ordered} 次,恰为 8×7÷2 = 28") print(f"乱序输入 {shuffled}:比较 {c_shuffled} 次") # 输出: # 有序输入 [1, 2, 3, 4, 5, 6, 7, 8]:比较 28 次,恰为 8×7÷2 = 28 # 乱序输入 [2, 1, 3, 6, 4, 5, 7, 8]:比较 24 次
退化机理清楚可见:有序输入配"取末位做轴",每轮分区轴都是当前段最大值,切成 n-1 与 0 两段——分治白干,比较次数退回冒泡量级 n(n-1)/2。八元素只是 28 对 24,规模放到十万,就是五十亿次对一百六十万次的碾压差距。修复招式是随机取轴或三数取中:轴随机化后期望回到 O(n log n),刻意构造的最坏输入也难以瞄准。
归并排序:合并的艺术
归并的心脏是"把两段已有序的数组合成一段":双指针各指两段头部,反复取较小者。等号取左段(left[i] <= right[j])保证稳定性——相等时左段先出,而左段元素原本就在前面。
# 归并排序:合并过程跟踪 + 比较计数 def merge_count(a): a = list(a) cmp = [0] def msort(seg): if len(seg) <= 1: return seg # 单元素天然有序 mid = len(seg) // 2 left, right = msort(seg[:mid]), msort(seg[mid:]) out, i, j = [], 0, 0 while i < len(left) and j < len(right): cmp[0] += 1 if left[i] <= right[j]: # 等号取左:稳定的来源 out.append(left[i]); i += 1 else: out.append(right[j]); j += 1 out.extend(left[i:]) # 残段整段接走(已有序) out.extend(right[j:]) return out return msort(a), cmp[0] def merge_two(L, R): # 单次合并的显微镜版本 out, i, j, log = [], 0, 0, [] while i < len(L) and j < len(R): if L[i] <= R[j]: log.append(f"取左 {L[i]}"); out.append(L[i]); i += 1 else: log.append(f"取右 {R[j]}"); out.append(R[j]); j += 1 out.extend(L[i:]); out.extend(R[j:]) log.append("剩余整段接走") return out, log out, log = merge_two([2, 5, 8], [1, 3, 9]) print("合并 [2,5,8] 与 [1,3,9] →", out) print("动作序列:", " → ".join(log)) # 输出: # 合并 [2,5,8] 与 [1,3,9] → [1, 2, 3, 5, 8, 9] # 动作序列:取右 1 → 取左 2 → 取右 3 → 取左 5 → 取左 8 → 剩余整段接走 shuffled = [2, 1, 3, 6, 4, 5, 7, 8] _, c1 = merge_count(shuffled) _, c2 = merge_count(list(range(1, 9))) print(f"乱序输入比较 {c1} 次;有序输入比较 {c2} 次") # 输出:乱序输入比较 14 次;有序输入比较 12 次 # 无论输入如何,递归树形状固定:树高 log n、每层合并共约 n 次比较——最坏也是 n log n
注意两件事:其一,归并对有序输入只快一点点(12 对 14),不像插入排序那样"近有序近线性"——它的递归树形状与输入无关;其二,这也是它最坏情形仍有保障的原因。
| 维度 | 快速排序 | 归并排序 |
|---|---|---|
| 平均时间 | O(n log n),常数小 | O(n log n) |
| 最坏时间 | O(n²)(轴选歪) | O(n log n) |
| 空间 | O(log n) 递归栈(原地分区) | O(n) 辅助数组 |
| 稳定性 | 不稳定(分区远距离交换) | 稳定(等号取左) |
| 缓存友好 | 好(顺序扫描) | 一般(来回复制) |
| 工程身影 | C 系标准库常客、内省排序骨架 | 外部排序、TimSort 的骨架之一 |
⚠️ 常见坑:拿固定首/末位做轴跑生产数据。真实业务数据常有"基本有序"段(时间序列、自增主键、增量追加),正是快排最坏输入的富矿。语言内置排序早已内置防御(随机化、三数取中、退化时切换堆排的内省排序),自己手写快排时务必带上。
💡 关键直觉:快排的轴每次分区都"永久归位",所以分解即收获;归并的收获在后半程,两段有序才能合。理解了"先难后易还是先易后难",两者的脾气就都通了。
走火入魔:两起分治事故
**事故一:递归深度失控。**快排最坏递归深 O(n),十万元素有序输入会直接打穿 Python 默认千层递归限制(呼应 1.3 与 4.2)。工程做法:对更小的一侧先递归、更大的一侧改循环(尾递归消除),深度压到 O(log n);或直接限定递归深度、超限切换堆排(内省排序策略)。
**事故二:稳定性要求下选了快排。**多关键字排序场景(先按次要键排、再按主要键稳定排)需要稳定排序,快排分区的远距离交换会打乱相等键的原序。此时归并(或语言内置的稳定排序,如 Python 的 sorted、Java 的 TimSort)才是正解。
本节要点回顾
- 快排先切后递归:Lomuto 分区让轴值一趟归位,平均 O(n log n)、原地、常数小;最坏 O(n²) 来自轴持续选歪(有序输入配固定轴,八元素 28 次比较可复算),随机化/三数取中是标准防御;
- 归并先递归后合:双指针合并、等号取左保稳定,最坏仍 O(n log n),代价是 O(n) 辅助空间;
- 两者的递归树形状对输入的敏感度相反:快排看轴的脸色,归并我行我素;
- 工程防御三件套:随机轴、小区间切插入排序、退化切堆排(内省排序),语言内置排序均在此列;
- 稳定性是选型的隐形指标:需要保序就归并/TimSort,不在乎就快排。
比较排序的对数级还能不能突破?下一节看堆排序收尾比较流派,再看计数与基数如何绕开"比较"二字打出线性。