1.1 基本概念与定义
1.1 基本概念与定义
本节摘要:SOURCE 1.1 将文本分类定义为将文本分配到预定义类别的监督学习任务;情感分析(意见挖掘)则量化主观态度,输出积极/消极/中立或更细情绪。本节用任务类型表与 ABSA 示例把边界讲清。
学习目标
- 写出文本分类与情感分析的输入/输出形式
- 区分二分类、多类、多标签三类设定
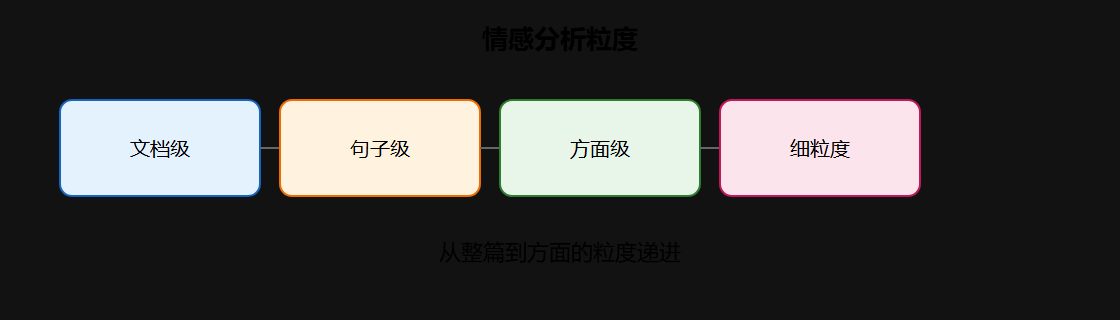
- 说明文档级、句子级、方面级情感的区别
一、文本分类:把非结构化文本变成标签
SOURCE 1.1.1:文本分类核心目标是自动化识别文本所属类别。输入是原始字符串,输出是一个或多个预定义标签。
| 任务类型 | 标签约束 | 典型例子 |
|---|---|---|
| 二分类 | 恰好 2 类 | 垃圾邮件 / 非垃圾 |
| 多分类 | 恰好 1 类,≥3 类 | 新闻:体育/财经/娱乐 |
| 多标签 | 可同时多类 | 文章同时属「科技+商业」 |
二、情感分析:分类的「主观性」分支
SOURCE 1.1.2:情感分析关注作者态度、情绪、评价,常见输出:
- 极性标签:积极 / 消极 / 中立
- 得分:连续值如 -1 到 1
- 细粒度情绪:高兴、愤怒、悲伤等
产品评论场景:「屏幕很亮,但电池一天都撑不住」——文档级可能是「混合」,方面级 ABSA 需分别判断「屏幕→积极」「电池→消极」。
分类 vs 情感 对照
| 维度 | 文本分类 | 情感分析 |
|---|---|---|
| 标签语义 | 任意主题/意图 | 态度与情绪 |
| 典型数据 | 新闻、工单类型 | 评论、推文 |
| 粒度扩展 | 多标签主题 | ABSA 方面×极性 |
三、系统五阶段流水线(SOURCE 1.1.4)
- 数据收集与预处理 — 清洗、分词、停用词、词干/词形还原
- 特征提取 — BoW、TF-IDF、词向量、上下文向量
- 模型构建与训练 — NB、SVM、RNN/CNN、Transformer
- 模型评估 — Accuracy、Precision、Recall、F1
- 部署与应用 — 对新文本推断
# 概念:最小推断接口 def predict(text: str, pipeline) -> str: features = pipeline["preprocess"](text) return pipeline["model"].predict([features])[0]
四、核心术语速查(SOURCE 1.1.5)
| 术语 | 含义 |
|---|---|
| Token / 词语 | 分词后的最小单元 |
| Corpus 语料库 | 训练/测试文本集合 |
| Feature 特征 | 文本的数值表示 |
| Inference 推断 | 用训练模型预测新文本 |
⚠️ 常见坑:把「三分类情感」当成多标签——每篇评论只能有一个整体极性时,应使用多类单标签。
💡 关键直觉:情感分析可复用分类算法,但标注规范必须处理否定、转折与讽刺。
要点速记
- 文本分类输出预定义类别;情感分析输出态度/情绪
- 任务设定先定清:二分类 / 多类 / 多标签
- ABSA 在方面维度做极性,适合电商细粒度洞察
- 五阶段流水线贯穿本教程后续各章
下一节看这些任务在垃圾过滤、舆情、客服等场景的落地形态。
补强:任务设定的工程决策
前面把三类设定(二分类、多类、多标签)摆在了桌面上,这里补两个经常被忽略的工程决策。第一,类别要「互斥、完备、可执行」——互斥指单标签任务里一篇文本只能落一个类,完备指任何输入都能映射到某一类,可执行指标注员能在有限时间内判断。很多项目把「一般」和「中性」同时设成类别,标注员无所适从,这就是标签体系没设计好。第二,多标签与多类的取舍要看业务动作:一篇文章推给一个频道还是推给多个频道?前者用多类,后者用多标签,二者评估方式完全不同,多标签需要算 Hamming Loss 或每类单独看精确率召回率。
ABSA(方面级情感)值得单独强调。它不是把整句判成积极或消极,而是先抽「方面」——屏幕、电池、物流——再对每个方面判极性。实现上常拆成两个子任务:方面抽取与极性判定,也可以用一个联合模型一步完成。这决定了标注规范的设计:每条样本要标出「哪几个方面、各自什么极性」,比单纯标整句极性贵得多,但产出可直接驱动供应链与产品改进。
# 概念:类别体系自检清单(示例) def check_schema(labels, task_type): checks = { "互斥": len(set(labels)) == len(labels), "完备": "其他" in labels or task_type == "多标签", "可执行": len(labels) <= 12, } return checks # 情感三分类 → 单标签多类;主题+情感 → 多标签
| 决策点 | 二分类 | 多类 | 多标签 |
|---|---|---|---|
| 输出数量 | 1 个 | 1 个 | 1 个以上 |
| 评估重点 | Precision/Recall | Macro-F1 | 每类 P/R + Hamming Loss |
| 典型任务 | 垃圾邮件 | 新闻主题 | 文章打多主题标签 |
一句话收束:标签体系定错了,后面的模型、评估、标注全是错的方向,本章是整条流水线的「地基设计图」。
一个完整的任务卡片示例
定义任务时建议按固定格式写任务卡片:任务名、输入样例、输出标签、粒度、评估指标、上线口径。下面给出一张电商评论情感分类的任务卡片,可当作模板使用。
| 字段 | 示例 |
|---|---|
| 任务名 | 电商评论情感三分类 |
| 输入 | 一条商品评价文本 |
| 输出 | 积极 / 消极 / 中立 |
| 粒度 | 整条评论(后续可升级 ABSA) |
| 评估 | Macro-F1 + 混淆矩阵 |
| 上线口径 | 高置信度直接入库,低置信度人工复审 |
任务卡片写清楚后,第 2 章的标注规范、第 4 章的训练脚本、第 5 章的监控指标都能以此为锚点对齐,避免各部门各写各的。