- 文集信息
- 目录大纲
- 最新文档
- 知识宇宙
文集详情
文集导读
教程导读:文本分类与情感分析实战
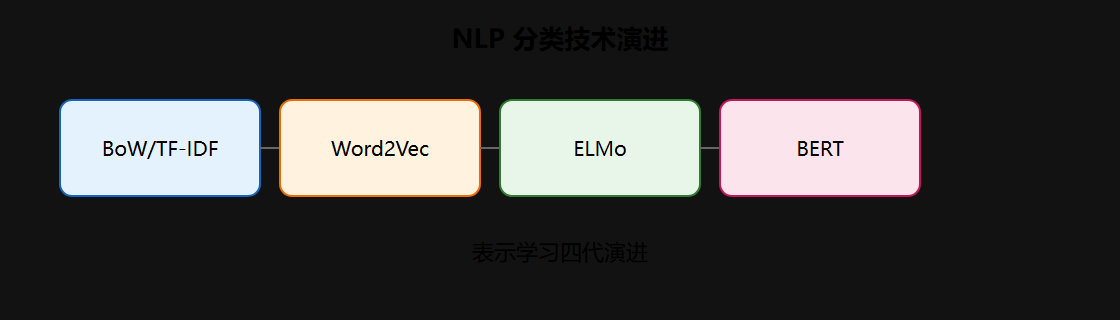
一句话定位:从垃圾邮件到舆情监控,文本分类是 NLP 落地最快的任务之一。本教程演化历史:从词袋 BoW、TF-IDF、Word2Vec 到 BERT 微调,按时间线理解「表示学习」如何一次次抬高性能天花板。
这门课解决什么问题
电商评论里「物流慢但商品好」该算好评还是差评?新闻稿同时涉及「科技」与「财经」该打几个标签?SOURCE 1.1 指出:文本分类是把文档映射到预定义类别,情感分析则是把文本映射到态度/情绪类别——二者共享同一套流水线(采集→预处理→特征→模型→评估→部署),但情感任务对讽刺、emoji、方面级 ABSA 更敏感。本教程按技术代际组织章节:先看清 2010 年代 TF-IDF+SVM 基线为何仍有用,再理解 2018 年后 BERT 微调为何成为默认选项。
适合谁读
- 需要上线评论分类、意图识别、垃圾过滤的产品/算法工程师
- 从传统 ML 转向预训练模型,想建立「该何时上 BERT」判断标准的学习者
- 负责标注规范与质检的数据同学
学习路线(演化视角)
| 代际 | 表示 | 典型模型 | 数据规模 | 本节锚点 |
|---|---|---|---|---|
| 统计时代 | BoW / TF-IDF | 朴素贝叶斯、SVM | 万级文档 | 3.1、4.1 |
| 静态嵌入 | Word2Vec / GloVe | CNN、LSTM + 嵌入 | 十万级 | 3.2、4.2 |
| 上下文嵌入 | BERT / RoBERTa | Transformer 微调 | 千级标注亦可 | 3.3、4.2 |
NLP 分类技术演进
怎么用本教程
每节开头给出该代际的典型故障(如 TF-IDF 维度过高、BERT 推理超时),再落到 SOURCE 中的具体工具名:CountVectorizer、jieba、FastAPI 部署、Label Studio 标注等。与 498 目标检测 不同,文本任务的核心瓶颈往往在标注质量与类别不均衡,而非算力。
⚠️ 常见误区:小数据集(<500 条)直接全量微调 12 层 BERT——往往不如 TF-IDF+线性模型 + 数据增强。
💡 关键直觉:表示能力越强,对标注噪声越敏感;演化史也是「对数据质量要求升级史」。
前置知识
- Python 基础与
scikit-learn使用经验 - 了解监督学习中的训练/验证/测试划分
- 无需事先读过 Transformer 论文
章节概览
- 文本分类概述 — 分类 vs 情感、多标签 vs 多类、ABSA 粒度
- 数据与预处理 — 采集、清洗、分词、标注规范与一致性
- 文本特征表示 — BoW→TF-IDF→词嵌入→BERT 的演化与选型
- 经典模型与训练 — 传统 ML 基线到深度学习与微调策略
- 评估分析与部署 — 指标、错误分析、API 部署与漂移监控
阅读前提
动手跑通本教程,建议先具备三样东西:一是 Python 基础,至少能读懂 scikit-learn 的 fit 与 predict 调用;二是一份可标注的小语料,几百条就够启动;三是对「训练集 / 验证集 / 测试集」的直觉,知道测试集只能碰一次。不需要事先读过 Transformer 论文,第 3 章会从演化史角度把 BERT 讲明白。命令行、虚拟环境这类工程习惯会有帮助,但不是硬门槛。
常见疑问解答
Q:小团队只有几百条标注,能直接上 BERT 吗?
A:不建议。标注少于 500 条时,TF-IDF 加线性模型往往更稳,第 4 章会给选型表;强行微调大模型容易过拟合,效果未必超过朴素基线。
Q:情感分析就是文本分类吗?
A:是子集关系。情感分析把类别限定为态度与情绪,且常见「方面级」粒度——同一句话里的「屏幕」和「电池」极性可能相反,这一点会在 1.1 详细展开。
Q:评测报告里该优先看哪个指标?
A:看业务代价。垃圾邮件场景误杀代价高,看精确率;风控与疾病筛查漏报代价高,看召回率;不均衡的多类任务看 Macro-F1。第 5 章专门讲指标选型。
章节地图
| 章节 | 核心产出 | 演化史位置 |
|---|---|---|
| 第1章 概述 | 任务与类别体系定义 | 起点:任务边界 |
| 第2章 数据预处理 | 可复用的清洗与标注流水线 | 燃料:数据质量 |
| 第3章 特征表示 | BoW 到 BERT 选型表 | 引擎:表示演进 |
| 第4章 模型与训练 | 基线到微调的完整训练脚本 | 动力:模型演进 |
| 第5章 评估与部署 | 指标、错误分析、API 与监控 | 终点:生产闭环 |
目录大纲
最新文档
知识宇宙
正在加载知识图谱...