1.3 挑战与发展趋势
1.3 挑战与发展趋势
本节摘要:SOURCE 1.3 梳理了中文分词歧义、讽刺、领域迁移、类别不均衡、可解释性与偏见等挑战,并指出预训练语言模型与少样本学习是主流趋势。本节从「演化史」视角解释:每一代新技术解决了上一代的部分痛点,也引入新的工程要求。
你能学到什么
- 列举六项以上文本分类/情感分析常见挑战
- 解释领域适应(Domain Adaptation)为何会导致性能骤降
- 说明预训练+微调如何改变数据规模门槛
一、语言与语义挑战
| 挑战 | 表现 | 演化史上的应对 |
|---|---|---|
| 中文分词 | 「结婚的和尚未结婚的」 | jieba + 领域词典 |
| 讽刺/反语 | 「真是太『好』用了」 | 上下文模型 BERT |
| 多义词 | 「苹果」水果 vs 公司 | 动态词向量 |
| 网络用语/emoji | 「绝绝子」「:)」 | 保留 emoji、子词 FastText |
二、数据与评估挑战
SOURCE 1.3 与 6.x 节交叉强调:
- 类别不均衡 — 差评仅占 2% 时 Accuracy 虚高
- 标注噪声 — 低质量标注直接封顶模型上限
- 领域漂移 — 新闻语料训练的模型在口语评论上 F1 大跌
- 多标签相关性 — 类别间非独立,Binary Relevance 忽略共现
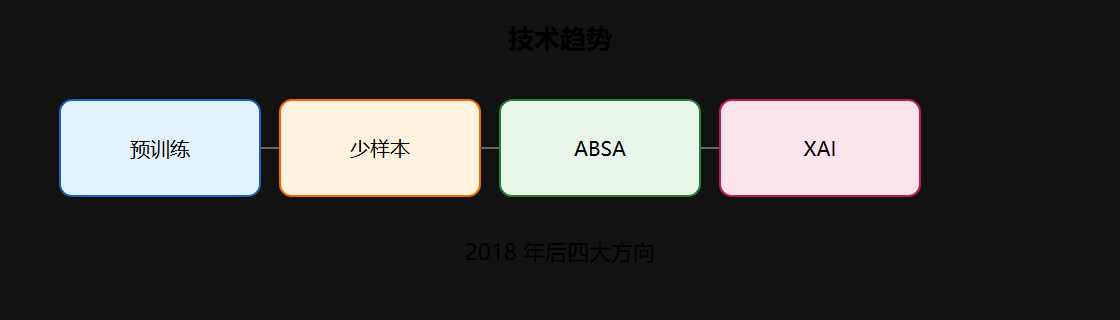
三、发展趋势(SOURCE 1.3 + 8.x)
- 预训练语言模型 — BERT、RoBERTa、中文 MacBERT;下游微调
- 少样本/零样本 — Prompt、对比学习,缓解标注成本
- 细粒度情感 — ABSA、方面抽取+极性联合建模
- 可解释性 — LIME、SHAP、注意力可视化(金融/医疗合规)
- 公平与伦理 — 检测性别/种族偏见,避免歧视性排序
四、选型建议:别跳过演化阶梯
| 数据量 | 建议路线 | 原因 |
|---|---|---|
| <1k 标注 | TF-IDF + 线性/SVM 基线 | 快速验证标签体系 |
| 1k–10k | 静态嵌入 + TextCNN/LSTM | 平衡效果与成本 |
| >10k 或要求 SOTA | 预训练模型微调 | 上下文语义 |
⚠️ 常见坑:在标注体系未稳定前上大模型——迭代标注规范的成本被放大。
💡 关键直觉:趋势是「更强表示 + 更高标注要求」;演化史不是废掉旧方法,而是明确各自适用区。
核心回顾
- 中文 NLP 难点:分词、讽刺、新词、emoji
- 数据侧:不均衡、噪声、漂移、多标签相关
- 趋势:预训练、少样本、ABSA、可解释、公平
- 小数据先基线,大数据/高要求再 BERT
第 2 章进入数据收集、清洗与标注规范——演化史的「燃料库」。
纵深:挑战背后的工程应对
挑战表格只列了现象,这里补充每个挑战在工程上的典型应对与代价。中文分词歧义「结婚的和尚未结婚的」,处理手段是维护领域词典并配合词频统计,但词典要持续更新,这就是运营成本;讽刺检测没有银弹,比较有效的手段是引入上下文模型并用含讽刺标注的领域数据微调,代价是标注成本高;多义词靠上下文向量解决,但推理成本上升,单条延迟从毫秒级升到几十毫秒级。
数据侧挑战更常见也更容易被低估。类别不均衡时 Accuracy 会虚高,应对是先看混淆矩阵再用 class_weight 或过采样,同时换 Macro-F1 汇报;标注噪声会直接封顶模型上限,应对是抽检、仲裁与定期修复金标准;领域漂移是「换一个语体就大跌」的元凶,应对是上线前先做领域适配测试,上线后监控分布偏移。多标签相关性则提示我们别把标签当成独立二分类任务硬拆。
发展趋势中的少样本与零样本值得展开:Prompt 与对比学习把「标注不足」的问题部分转移成「提示设计」的问题,对冷启动很有用,但评估时要注意提示的脆弱性——换一种说法效果可能大跌,所以仍要保留一小块金标准做回归测试。
还有一个常被忽略的挑战是「评估与部署的缝隙」:离线指标漂亮,线上体验却差。原因通常是测试集与线上输入分布不一致,或预处理不一致(线上忘了做同样的清洗与分词)。解决方法是把线上采样回流进测试集做周期性比对,这属于第 5 章部署监控的范畴,但问题意识从第 1 章就该建立。
# 概念:不均衡处理与监控的简化示意 from collections import Counter def diagnose_imbalance(labels): dist = Counter(labels) minor_ratio = min(dist.values()) / sum(dist.values()) print("少数类占比:", round(minor_ratio, 4)) return "需加权" if minor_ratio < 0.1 else "可接受"
| 挑战 | 典型应对 | 代价 |
|---|---|---|
| 分词歧义 | 领域词典 | 词典维护 |
| 讽刺反语 | 上下文模型微调 | 标注成本 |
| 类别不均衡 | class_weight / 过采样 | 训练调参 |
| 领域漂移 | 适配测试 + 漂移监控 | 监控工程 |