2.2 分词与标准化
2.2 分词与标准化
本节摘要:SOURCE 2.2–2.3 与 3.1.1 预处理:中文需 jieba/LTP/HanLP 分词;英文常 lowercasing、停用词、Stemming/Lemmatization。本节对照中英文流水线,并说明情感任务对 emoji 的特殊处理。
核心问题
- 为中文项目选择分词工具与自定义词典策略
- 解释停用词表的任务相关性(不能盲删)
- 区分 Stemming 与 Lemmatization 的取舍
一、分词 Tokenization
| 语言 | 工具 | 注意点 |
|---|---|---|
| 中文 | jieba、LTP、HanLP | 歧义切分、领域词 |
| 英文 | spaCy、NLTK | 缩写、连字符 |
| 多语 | SentencePiece | BERT 子词单元 |
import jieba text = "自然语言处理很有趣" tokens = list(jieba.cut(text)) # ['自然语言', '处理', '很', '有趣'] # 取决于词典
SOURCE 示例语料:「我 喜欢 自然语言处理」——分词质量直接影响 BoW 与 TF-IDF。
二、标准化步骤
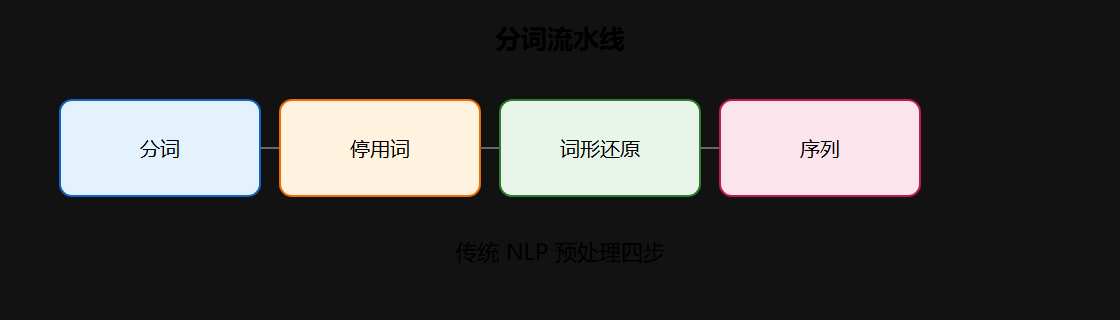
- 小写化 — 英文统一 case,减少特征稀疏
- 停用词 — 「的、是、the、a」;情感任务中「不、没」不能删
- 词干/词形 — Porter Stemmer vs WordNet Lemmatizer
- 数字 — 替换为
<NUM>或保留(产品型号)
三、情感任务特殊处理
SOURCE 2.3:emoji 与颜文字常承载极性,如 :)→positive,可映射为文本 token 或保留 UTF-8 原样。网络用语「绝绝子」需更新词典或依赖子词模型。
⚠️ 常见坑:用通用中文停用词表删掉「不」「没有」——否定翻转语义被毁。
💡 关键直觉:预处理与特征时代绑定;BERT 时代可简化部分步骤但中文仍建议基础清洗。
本章回顾
- 中文必须分词;工具与领域词典影响全局
- 停用词表应任务定制;否定词慎删
- Stemming 快但不准;Lemmatization 准但慢
- 情感任务保留 emoji/网络用语信息
下一节聚焦标注规范与一致性检验。
深化:分词与标准化的踩坑细节
分词不是越准越好,而是「与后续任务匹配」。对 BoW 与 TF-IDF 而言,分词结果直接决定特征粒度:词切得细,特征维度高、稀疏;切得粗,语义可能丢失。jieba 支持自定义词典与用户词,领域词如「防水」「快充」要提前加进词典,否则会被切成两个词,削弱特征表达。也要注意分词工具版本差异——jieba、LTP、HanLP 对同一句子的切分可能不同,线上与训练必须用同一版本同一配置,否则特征分布会悄悄偏移。
停用词表必须任务定制。通用表里的「不」「没有」「别」在情感任务里是强烈的极性词,删掉它们等于拆掉模型的信号源。反过来,语气词、结构助词大量出现却无信息量,可以过滤。更稳妥的做法是把停用词过滤做成「白名单 + 黑名单」:先按词频与信息增益挑特征,再由人工复核误删的极性词。
英文文本的标准步骤是小写化、缩写展开、词形还原。Stemming(如 Porter)速度快但可能产出非词片段,Lemmatization 依赖词典与词性标注、结果更规整。中文没有形态变化,词形还原这一步省略,但繁体简体转换与标点归一化值得做。
还有一个经常被忽略的点:分词与模型时代的匹配。BERT 时代用子词分词器(WordPiece/BBPE),不需要也不可能用 jieba 词表;但中文 BERT 仍建议在预处理阶段做基础清洗与文本归一化,例如统一全半角、折叠空白。不要在两套分词方案之间混用——用 jieba 分词后的 token 序列再喂给 WordPiece,会造成冗余或错位。团队内应该把「预处理规范」固化成一份共享文档,训练脚本与线上服务引用同一份配置,这也是第 5 章部署一致性的前置要求。
实操建议:先准备 100 条代表性样本,人工写出期望的分词与 token 序列作为验收基准,再跑工具对比,工具输出与基准不一致的逐条排查。这一步虽然繁琐,但能避免「上线后发现分词行为漂移」这种最难查的线上事故。
import jieba # 领域词典:把「快充」绑成一个词 jieba.add_word("快充") jieba.add_word("防水") # 情感任务慎删否定词 NEGATION = {"不", "没有", "别", "没", "无"} stopwords = load_common_stopwords() - NEGATION # 从黑名单里拿回极性词
| 决策点 | 选择 | 适用场景 |
|---|---|---|
| 分词工具 | jieba 带词典 | 中文通用 |
| 子词 | SentencePiece | BERT 输入 |
| 停用词 | 定制白黑名单 | 情感任务 |
| 词形 | Lemmatization | 英文规范 |
分词质量的量化验收
分词的验收不能靠感觉,建议按下面的量化口径做对比测试。
| 指标 | 计算方式 | 说明 |
|---|---|---|
| 词典命中率 | 领域词被整体切出的比例 | 词典质量 |
| 人工一致率 | 与人工分词基准的完全一致比例 | 整体质量 |
| OOV 率 | 未登录词占比 | 覆盖率 |
先在 100 条样本上人工切出基准,再对比 jieba、LTP、HanLP 三家的输出,选一致率最高且速度可接受的那家固定下来;领域词不断补充进词典,并定期重测一次一致率。把验收脚本与基准样本纳入版本管理,工具升级或词典改动时都能自动回归。