5.3 模型部署与监控
5.3 模型部署与监控
本节摘要:SOURCE 7.1–7.3 描述 Flask/FastAPI REST 服务、批处理、容器化,以及数据漂移 Data Drift 与概念漂移 Concept Drift 监控。本节给出最小 API 与再训练触发条件。
上手前先明确
- 用 FastAPI 封装推断接口
- 区分数据漂移与概念漂移
- 设计模型版本管理与回滚
一、部署形态(SOURCE 7.2)
| 方式 | 适用 | 框架 |
|---|---|---|
| REST API | 在线实时 | FastAPI、Flask |
| 批处理 | T+1 报表 | Spark、Airflow |
| 边缘 | 离线/低延迟 | TFLite、ONNX |
from fastapi import FastAPI from pydantic import BaseModel app = FastAPI() class TextIn(BaseModel): text: str @app.post("/predict") def predict(body: TextIn): label = pipeline(body.text) # 封装预处理+模型 return {"label": label}
二、监控(SOURCE 7.3)
- 数据漂移 — 输入词分布、长度分布变化
- 概念漂移 — 同一特征与标签关系变化(如「绝绝子」从褒变讽)
- 业务指标 — 客诉率、人工复审率
三、演化史收尾
| 时代 | 部署特点 |
|---|---|
| TF-IDF+SVM | 单文件 pickle,毫秒级 |
| BERT | GPU/量化,需批处理优化 |
⚠️ 常见坑:上线后不监控输入分布——静默退化数月才发现。
💡 关键直觉:部署不是终点;漂移监控决定模型寿命。
核心回顾
- FastAPI 是在线服务常用选择
- 数据漂移 vs 概念漂移要分清
- 版本化模型 + 可回滚
- 演化史终点:持续学习的生产系统
深化:部署形态、版本管理与漂移监控
部署形态的选择要看流量与延迟要求。REST API 适合在线实时场景,FastAPI 天然支持请求校验、自动文档与并发,是轻量上线的常用选择;但要注意在线推理的吞吐设计——BERT 类模型单条推理几十毫秒,并发高时要考虑批处理聚合,把多条请求合并成一次前向。批处理适合 T+1 报表类任务,用 Airflow 或 Spark 定时跑;边缘部署适合离线或隐私敏感场景,模型要量化或转 ONNX 以压缩体积与提速。
版本管理是生产质量的保障。每个模型要有唯一版本号,记录训练数据版本、特征版本、训练脚本与指标;发布时同时保存「推理代码」与「预处理代码」的版本——线上最常见的翻车是「训练时的预处理和线上的不一致」,例如训练时去掉了 HTML 标签,线上忘了做。回滚要快:当监控告警时,能在分钟级切回上一版本,而不是重新训练。
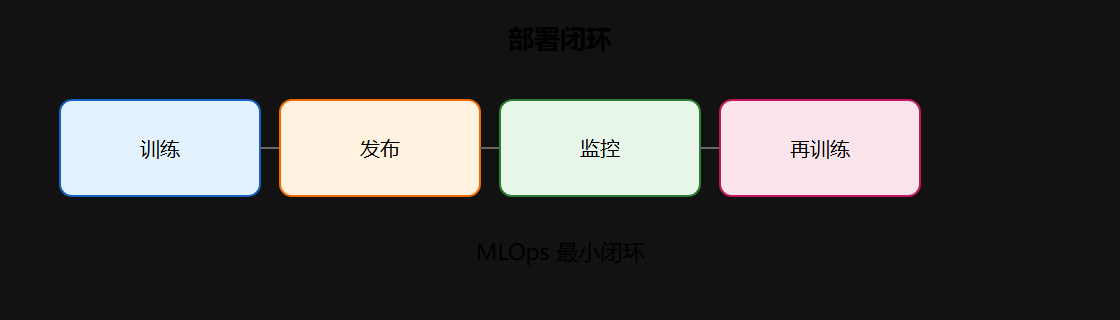
漂移监控分两类:数据漂移指输入分布变化(词频、文本长度、领域词汇占比),概念漂移指「输入与标签的关系」变化——例如「绝绝子」从褒义变成讽刺。检测数据漂移常用 KL 散度、PSI 对比线上与训练分布;概念漂移通常靠线上业务指标(客诉率、复审率)与抽样标注间接判断。监控触发后进入再训练流程:重采数据、重训、离线评估、灰度发布、观察指标。
监控要避免两个极端:一是上线后什么都不看,静默退化数月才被发现,用户早就流失;二是过度告警,把团队拖进告警疲劳,最后反而忽略真信号。建议分三层:基础设施层(服务可用性、延迟)、分布层(数据漂移)、业务层(客诉、复审率),各层设阈值与处理责任人。告警之后要能追溯——请求日志至少要保留采样,否则告警了也不知道为什么漂移。
最后回到演化史:从 TF-IDF 加 SVM 的「单文件 pickle、毫秒级推理」到 BERT 的「GPU 推理、需要批处理与量化」,部署形态是被模型特性塑造的。理解这条线,你在做架构决策时就不会只盯着算法精度,而是把「算力成本、延迟预算、监控能力」一起纳入模型选型。这也是本教程把评估与部署放在最后一章的原因——好模型的定义里永远包含「能不能稳定服务」。
# 概念:请求日志 + 漂移检测的简化示意 import hashlib def log_prediction(text, label, prob): record = { "text": text, "label": label, "prob": prob, "len": len(text), "hash": hashlib.md5(text.encode()).hexdigest()[:8], } # append(record) → 定时统计词频/长度分布 vs 训练分布
| 环节 | 手段 | 关键指标 |
|---|---|---|
| 在线推理 | FastAPI + dynamic batching | 延迟 P95、吞吐 |
| 版本管理 | 模型注册表 | 回滚时间 |
| 数据漂移 | PSI/KL | 分布偏移告警 |
| 概念漂移 | 业务指标+抽样 | 客诉率 |
| 再训练 | 自动触发 | 发布周期 |
灰度发布与回滚演练
上线不是「一把梭」,灰度与回滚演练要提前做。
| 阶段 | 动作 | 通过标准 |
|---|---|---|
| 金丝雀 | 小流量试跑 | 监控无异常 |
| 渐进 | 按比例放量 | 指标平稳 |
| 回滚演练 | 主动切换旧版 | 分钟级完成 |
| 观察 | 全量后观察期 | 业务指标稳定 |
回滚演练必须定期做——「回滚脚本写好了但从来没跑过」等于没有。演练时记录从告警到切换完成的实际耗时,超过预算就优化流程。第 5.3 节的监控信号在这里就是触发源:告警响起,按演练好的剧本走,而不是现场商量。