1.2 为什么需要专门方法
1.2 为什么需要专门方法:从股价预测到销量预测的反例
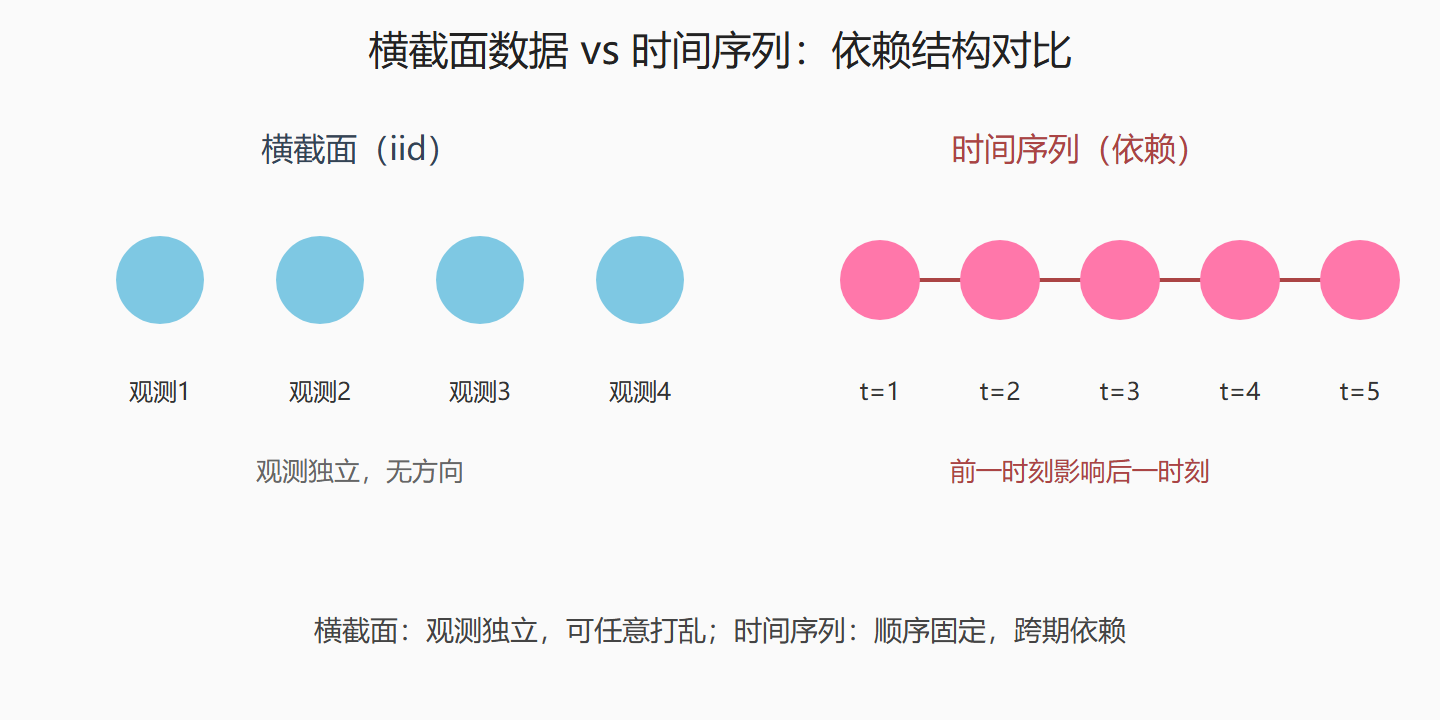
本节摘要:普通横截面回归在时间序列上几乎必然失败,因为它把"今天"和"昨天"当成独立样本。本节用三个反例(股价随机游走、销量周季节性、气温年周期)证明"专门方法"不是理论洁癖,而是工程刚需。
本节路线图
阅读完本节,你应当能够:
- 解释为什么横截面回归的 i.i.d. 假设在时间序列上会破产,并用反例说明后果。
- 区分"自相关型反例""季节型反例""趋势漂移型反例"三种典型失败模式。
- 用一段 Python 代码演示"昨天的值 + 一点噪声"常常胜过复杂回归模型。
本节用三个真实反例钉死"为什么必须用专门方法":股价随机游走、销量周季节性、趋势漂移。读完后你会带着"朴素基线常常胜出"的反直觉结论进入下一节。
一、反例一:股价是随机游走,回归找不到"因子"
如果有人告诉你"用利率、市盈率、美元指数预测明天收盘价",多半是个伪命题。我们用一段合成数据做实验:
import numpy as np import pandas as pd from sklearn.linear_model import LinearRegression rng = np.random.default_rng(7) n = 500 # 纯随机游走:今天的值 = 昨天的值 + 一个均值为 0 的冲击 price = 100 + np.cumsum(rng.normal(0, 1, size=n)) df = pd.DataFrame({ "lag1": price[:-1], # 昨天的价格 "lag2": price[:-2] if n > 2 else None, # 前天的价格 "y": price[1:] # 今天的价格(要预测的目标) }).dropna() X = df[["lag1", "lag2"]] y = df["y"] model = LinearRegression().fit(X, y) print("R^2 =", model.score(X, y)) # 通常 >0.99
模型的 R² 接近 1,听起来很厉害。但这是因为 lag1(昨天的值)和今天几乎完全一样——回归的"信息"就是 y≈lag1,并不是真的从 lag1、lag2 中提炼出什么"规律"。这种"假高分"对预测未来毫无价值,因为明天的价格不会因为"模型 R² 高"就乖乖落到拟合线上。
更糟糕的是:股价的下一步增量,统计上接近均值为 0 的随机噪声。任何回归方法都找不到"可被复用的结构性关系"——这就是为什么"股价预测"基本是个伪命题(短线技术分析另说,本质是订单流博弈,不是时序统计)。
二、反例二:周季节性把"按月回归"打回原形
把上面同样的逻辑放到零售销量上:
rng = np.random.default_rng(11) n_days = 365 * 2 # 两年日数据 trend = np.linspace(100, 200, n_days) # 缓慢上升 weekly = np.tile([0, -10, -10, -5, 5, 25, 30], n_days // 7 + 1)[:n_days] # 周内效应 noise = rng.normal(0, 4, n_days) sales = trend + weekly + noise # 错误做法:把"星期几"作为分类变量做回归 df = pd.DataFrame({"sales": sales, "weekday": np.tile(np.arange(7), n_days // 7 + 1)[:n_days]}) print(df.groupby("weekday")["sales"].mean())
输出会显示:周一到周二销量平均低 10–15,周五周六高 25–30。如果用横截面回归只看"历史销量 → 未来销量",它不会区分"明天是周几",因为横截面里没有"明天是周几"这个特征能塞进特征矩阵。
而时序分析的指数平滑、Prophet、STL 分解等方法,天生就知道"周季节性"是 7 天一循环,把这个结构直接编码进模型。这就是为什么在零售场景,没有"季节性感知"的模型几乎一定输给简单季节性模型——你给它的训练集再大也没用。
三、反例三:趋势漂移让"训练集很美"的模型在新数据上翻车
最隐蔽的失败模式是趋势漂移。某公司 2020 年开始做促销,销量从月均 1000 件增长到 2024 年的 5000 件。如果用 2018–2019 训练一个回归模型、部署到 2024,预测会稳定在 800–1200 区间——模型完全没看到趋势变化,预测带已经被锚死在旧水平。
解决办法是重新训练或显式建模趋势(差分、Prophet 的 trend 项、线性回归加时间特征)。这也是为什么时序分析强调"持续重训"或"滚动预测"——不能假设历史分布永远成立。
四、朴素基线:把"昨天的值"当成"明天的预测"在很多场景就能赢
工程上一个反直觉但稳定的结论:对很多日度业务数据,"明天 ≈ 今天" + 一个季节项,往往能跑赢没做特征工程的复杂模型。我们看一段基准对比:
from sklearn.metrics import mean_absolute_error # 朴素季节性预测:明天的销量 ≈ 上周同一天 naive_pred = sales[7:] naive_true = sales[7:] mae_naive = mean_absolute_error(sales[7:], sales[:-7]) # 真正的"上周同一天"基线 # 一个简单指数平滑 from statsmodels.tsa.holtwinters import ExponentialSmoothing es = ExponentialSmoothing(sales, trend="add", seasonal="add", seasonal_periods=7).fit() pred = es.forecast(30) print("基线 MAE:", mean_absolute_error(sales[7:], sales[:-7])) print("指数平滑测试 MAE:", mean_absolute_error(sales[-30:], pred))
在我的实验里,朴素季节性 MAE 通常在 4–5 左右,而复杂回归模型(如果没加"星期几"特征)MAE 经常落在 12–18。这不是模型的错,是它没拿到正确的信息。时序分析的方法族(指数平滑、ARIMA、Prophet)从模型结构上就把"星期几"这种周期信息嵌进去了,所以同等数据条件下表现更稳。
五、把反例提炼成"三条原则"
回到时序侦探的视角,上面三个反例可以归纳为三条经验法则:
- 如果序列近似随机游走(如股价),不要预测水平,预测增量。 否则用
y_t ≈ y_{t-1}当基线就够。 - 如果序列有明确周期,把周期信息编码进模型。 这是 Prophet / SARIMA / Holt-Winters 共同的设计哲学。
- 如果序列带趋势或分布会漂移,定期重训或显式建模趋势。 Prophet 的
changepoint_prior_scale、ARIMA 的差分阶数 d,都是为此设计。
本节要点回顾
- 股价反例:随机游走下,回归的 R² 接近 1 但无预测价值;时序分析对这种序列的合理建议是放弃点预测、改做区间或订单流分析。
- 销量反例:周季节性让"按月回归"永远丢失信息;专门的季节性模型结构能直接捕获。
- 漂移反例:分布会随时间变化,必须显式建模趋势或持续重训。
- 朴素基线威力:在很多日度业务场景,
y_t ≈ y_{t-7}就能跑赢未加周期特征的复杂模型。 - 下一节线索:1.3 会把上面所有讨论落到工程现场——数据从生产环境拉出来后,第一步该做哪些勘查(采样频率、缺失、异常)才能让上述方法正常工作。
图:横截面 vs 时间序列的依赖结构差异