1.3 数据类型与预处理
1.3 数据类型与预处理:缺失、异常、采样频率的现场勘查
本节摘要:原始时间序列几乎一定有缺失、重复、异常值和采样频率漂移四类"现场污染"。本节给出一份"勘查清单"——三步走确认频率、补齐缺失、识别异常——并配一段可跑的 pandas 代码,让读者在动手建模前先把数据整理干净。
本节路线图
阅读完本节,你应当能够:
- 识别时间序列中常见的四类污染:缺失、重复、异常、采样频率漂移。
- 写出"重采样到统一频率 + 插值补缺失 + IQR / Z-score 识别异常"三步走的 pandas 代码。
- 解释为什么"先聚合再插值"通常比"先插值再聚合"更稳。
本节是 1.1 / 1.2 的工程落地:从理论到一份"现场勘查清单"——三步走确认频率、补齐缺失、识别异常,最后强调可视化自检永远不可省。
一、四类现场污染
经验上看,原始时序数据有四类典型污染,每一类都会让后续建模走偏:
- 缺失值:采集系统故障、节假日不营业、客户端埋点漏报,都会在时间线上挖出"洞"。
- 重复时间戳:数据库主键设计不当、日志重发,会让某个时间点出现两条记录甚至更多。
- 异常值:传感器漂移、大促当天的极端值、汇率/股价的"乌龙指",会让模型学到不该学的模式。
- 采样频率漂移:业务从"每 5 分钟一次"改成"每 10 分钟一次"、从"按事件"切成"按小时",数据看起来连续但实际频率变了。
⚠️ 常见坑:别一上来就
fillna(0)。销量在某天是 0(真没卖)和"那天的数据丢了"在业务含义上完全不同;粗暴填 0 会让模型以为"零销量是常态"。
二、勘查清单:三步走
下面是一段可直接改造的工程代码骨架。它把"现场勘查"拆成可复用的三步:
import pandas as pd import numpy as np # 假设 df 至少包含 ["ts", "value"] 两列 df = pd.DataFrame({ "ts": pd.to_datetime([ "2024-01-01 00:00", "2024-01-01 00:05", "2024-01-01 00:10", "2024-01-01 00:15", "2024-01-01 00:25", # 00:20 缺失 "2024-01-01 00:30", "2024-01-01 00:30", # 重复 "2024-01-01 00:35" ]), "value":[10, 12, 11, 13, 200, 14, 13, 12] # 200 是异常 }) df = df.drop_duplicates(subset="ts").set_index("ts").sort_index() # Step 1:探测并固定采样频率 freq = pd.infer_freq(df.index) print("推断频率:", freq) # 可能是 '5min',也可能是 None df = df.asfreq("5min") # 强制重采样到 5 分钟频率,会把缺失的 00:20 暴露成 NaN # Step 2:补齐缺失 df["value"] = df["value"].interpolate(method="time") # 按时间线性插值,比纯线性更适合业务数据 # Step 3:异常识别(IQR 方法,对小样本稳健) q1, q3 = df["value"].quantile([0.25, 0.75]) iqr = q3 - q1 lo, hi = q1 - 1.5 * iqr, q3 + 1.5 * iqr outliers = df[(df["value"] < lo) | (df["value"] > hi)] print("异常点:\n", outliers) # 把异常替换为 NaN,再用 Step 2 同样的方法重插 df.loc[outliers.index, "value"] = np.nan df["value"] = df["value"].interpolate(method="time")
这段代码里值得停下来看的地方:
pd.infer_freq推断的是"均匀间隔",如果你的数据不是严格等距,它会返回None。这时不要直接用asfreq,先用resample显式声明频率。asfreq之后才用interpolate——这是"先暴露缺失、再补齐"的标准做法,比直接对原始value列做插值要可靠,因为你已经显式知道哪些是 NaN、哪些是真实值。- 异常识别用了 IQR 方法。对极端值不敏感的业务数据,IQR 够用;对金融价格等"波动本身就是信息"的数据,IQR 太激进,应该用基于滚动中位数的 MAD(median absolute deviation)方法。
三、采样频率到底怎么定:先聚合还是先插值
一个常见困惑:把 5 分钟数据降采样到小时,是直接 resample("1h").mean()(先聚合)还是 asfreq("1h").interpolate()(先插值)?答案几乎总是先聚合:
| 操作 | 适用场景 | 风险 |
|---|---|---|
resample("1h").mean() |
高频数据 → 低频汇总 | 丢失高频细节,但保留统计意义 |
resample("1h").sum() |
流量、销量、计数类指标 | 业务上"小时总销量"本身就是真实量 |
asfreq("1h").interpolate() |
物理量(温度、压力)做平滑 | 插值出来的"中间值"在业务上可能没意义 |
💡 关键直觉:插值是在"数据本来就该是连续"的假设下做的。温度、压力这种物理量适合插值;销量、点击量这种"事件计数"插值出来的中间值是假的。
四、采样频率漂移的处理
第四类污染最容易漏检。例如下面这段代码展示一个常见问题:某接口的返回频率从 5 秒变到 10 秒,原始数据看起来连续,但实际采样间隔变了。
ts = pd.to_datetime([ "2024-01-01 00:00:00", "2024-01-01 00:00:05", "2024-01-01 00:00:10", "2024-01-01 00:00:20", "2024-01-01 00:00:30" # 间隔从 5s 变 10s ]) s = pd.Series(range(len(ts)), index=ts) deltas = s.index.to_series().diff().dt.total_seconds() print("采样间隔:\n", deltas) # 输出会有 5.0 / 10.0 两种值 → 说明存在频率漂移
处理办法是先对齐到目标频率:s.resample("10s").mean(),让所有间隔统一为 10 秒;中间缺的 15 秒位置会自动填 NaN,再走 Step 2 的插值。别假定上游给你的是均匀的——尤其在跨系统、跨团队的接口里,频率漂移几乎一定会发生。
五、可视化自检
最后一步是肉眼检查。把整理后的序列画出来,确认:
- 趋势方向是否符合业务直觉(销量在促销后应该上升,不能是下降)。
- 季节性形状是否符合预期(周季节性应该有 7 个峰谷循环)。
- 异常点是不是真的在异常位置(疫情、双 11、系统故障日)。
如果图看起来"不对劲",先回去查数据,不要硬塞进模型——模型不会比数据更好。
本节要点回顾
- 四类污染:缺失、重复、异常、频率漂移。
- 三步勘查:
asfreq暴露缺失 →interpolate补齐 → IQR/MAD 识别异常。 - 先聚合后插值:对事件计数类指标,
resample比asfreq更稳。 - 可视化自检永远不可省:肉眼能发现模型发现不了的问题。
- 下一节线索:第二章开始,我们进入"案件拆解"——把这条整理干净的序列拆成趋势、季节、周期、残差四个嫌疑犯。
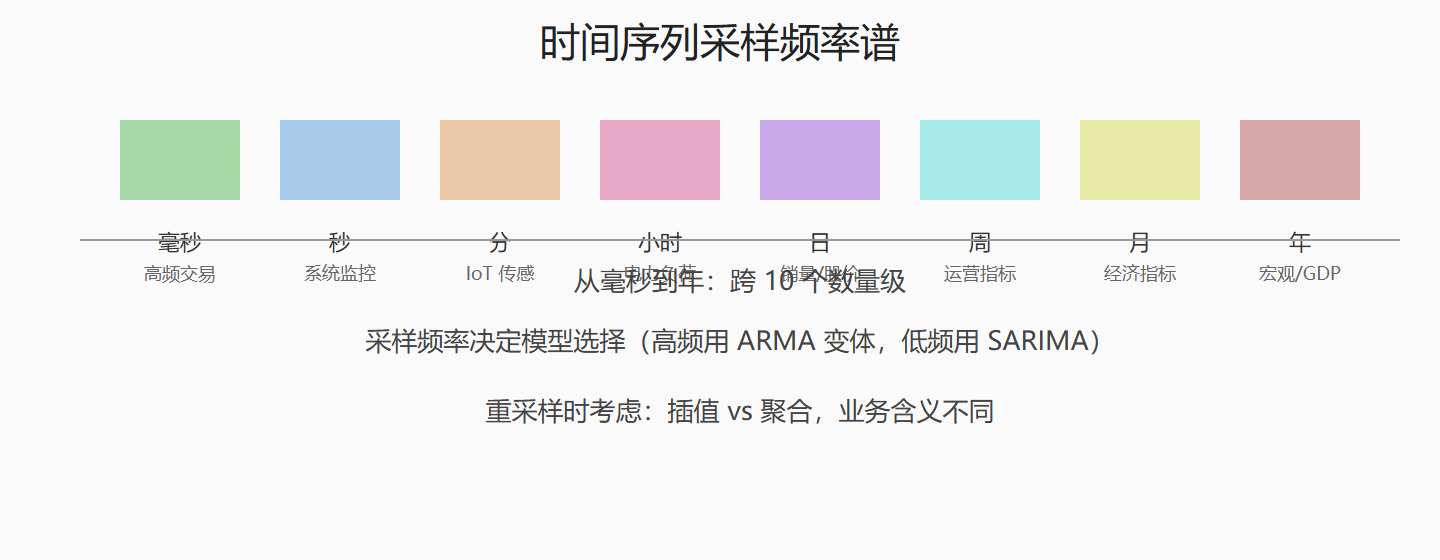
图:常见采样频率与典型应用