3.2 趋势的识别方法
3.2 趋势的识别方法:移动平均、LOESS、回归
本节摘要:识别趋势有三种主流工具——简单移动平均(SMA)、LOESS 局部加权回归、参数回归(线性/多项式)。本节对比三种工具的稳健性、对异常值的容忍度、对窗口的敏感性,并用一段合成数据演示差异。
学习目标速览
阅读完本节,你应当能够:
- 用 SMA、LOESS、参数回归三种方法各自估计一段含噪声数据的趋势。
- 解释三种方法在"窗口/带宽/多项式阶数"超参选择上的工程取舍。
- 在含异常值的真实场景里选对工具(LOESS > 移动平均 > 普通回归)。
本节进入"识别"环节:用一段含异常点的合成数据对比三种工具的稳健性,并教你用 Ljung-Box 检验帮选窗口/带宽。
一、三种工具的定位
| 工具 | 数学含义 | 关键超参 | 优点 | 缺点 |
|---|---|---|---|---|
| 简单移动平均 (SMA) | 窗口内取平均 | 窗口大小 | 简单、快、可解释 | 滞后、矩形窗有边界效应 |
| 加权移动平均 (WMA) | 中心点权重大 | 权重函数 | 比 SMA 滞后小 | 仍对异常值敏感 |
| 指数加权 (EWMA) | 权重按指数衰减 | 衰减系数 α | 对最新值敏感 | 仍对异常值敏感 |
| LOESS | 局部加权回归 | 带宽(bandwidth) | 局部拟合,非参数 | 计算慢、带宽需调 |
| 参数回归 | 整段拟合一个函数 | 函数族 + 阶数 | 解释性强 | 对异常值敏感、对函数族敏感 |
二、用一段合成数据演示三种方法
下面这段代码用 statsmodels 和 scipy 演示同一段含噪数据在三种方法下的趋势估计:
import numpy as np import pandas as pd import matplotlib.pyplot as plt from statsmodels.nonparametric.smoothers_lowess import lowess # 合成:S 形趋势 + 高斯噪声 + 2 个异常点 rng = np.random.default_rng(7) n = 200 t = np.arange(n) trend_true = 1000 / (1 + np.exp(-0.05 * (t - 100))) y = trend_true + rng.normal(0, 15, n) y[40] = 2000 # 注入异常 y[150] = -500 # 注入异常 s = pd.Series(y, index=pd.date_range("2024-01-01", periods=n)) # 方法 1:简单移动平均(中心化,窗口 15) s_sma = s.rolling(window=15, center=True, min_periods=1).mean() # 方法 2:LOESS 局部加权回归(带宽 0.2 = 用 20% 的局部数据) loess_fit = lowess(s.values, np.arange(n), frac=0.2, it=3, return_sorted=False) s_loess = pd.Series(loess_fit, index=s.index) # 方法 3:参数回归(三阶多项式) coef = np.polyfit(t, y, deg=3) s_poly = pd.Series(np.polyval(coef, t), index=s.index) fig, ax = plt.subplots(figsize=(10, 4)) ax.plot(s.index, s.values, ".", alpha=0.4, label="原始") ax.plot(s.index, trend_true, "k--", label="真实趋势") ax.plot(s.index, s_sma, label="SMA(15)") ax.plot(s.index, s_loess, label="LOESS") ax.plot(s.index, s_poly, label="多项式(deg=3)") ax.legend() plt.tight_layout()
从图上可以看到三种方法对异常值的反应:
- SMA(15):异常值被窗口平均"压扁"了 1/15,影响有限但整体趋势被异常点拉偏。
- LOESS:局部加权的方式对异常值最鲁棒——异常点只影响它的局部窗口,不会污染远端。
- 多项式回归:被异常点强烈干扰,拟合曲线在异常值附近明显偏出。
💡 关键直觉:异常值多时优先 LOESS,异常值少且解释性优先时选参数回归。在工业界 LOESS 是 STL 分解的核心组件,被 statsmodels 的
seasonal_decompose(..., model="additive")默认采用。
三、窗口与带宽的工程取舍
三种方法都涉及"看多远的过去"——SMA 的窗口、LOESS 的带宽、参数回归的多项式阶数。这个超参没有银弹,但有经验法则:
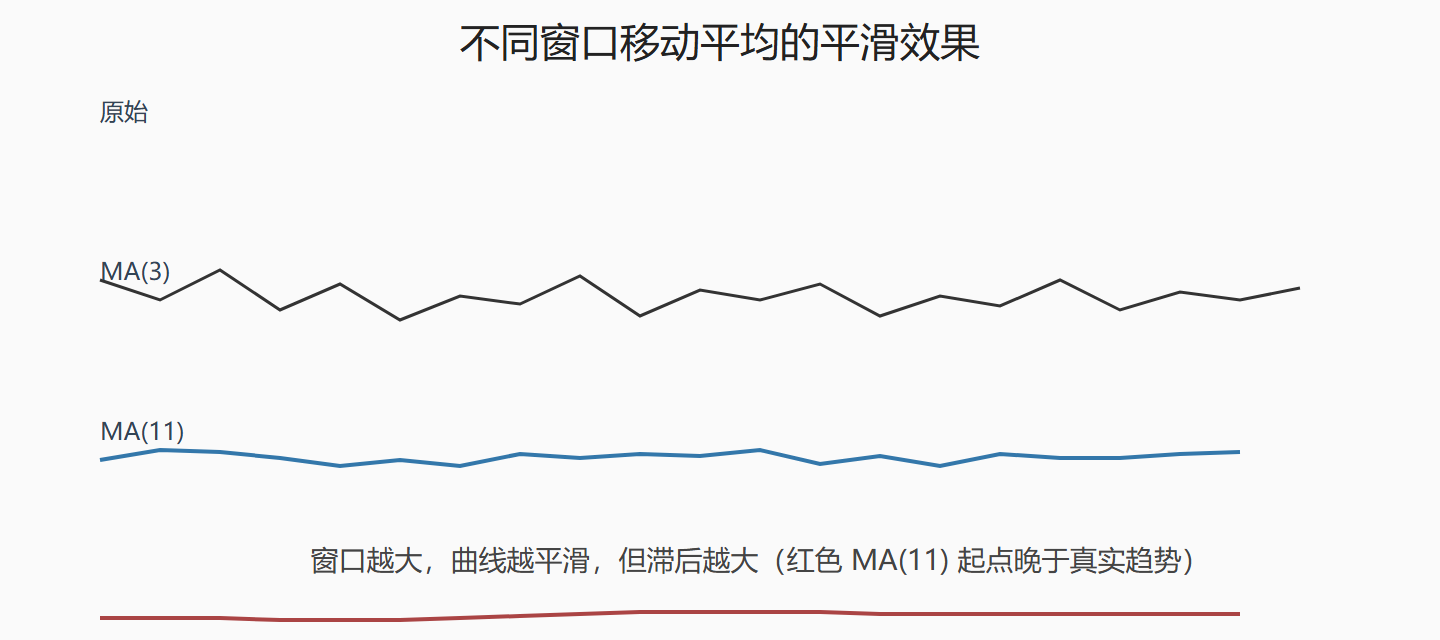
- 窗口 / 带宽太小:趋势估计有噪声,跟原始序列几乎一样。
- 窗口 / 带宽太大:趋势估计过于平滑,对突变反应迟钝。
- 经验起点:日数据从 7 或 14 开始;月度数据从 6 或 12 开始;分钟级数据从 60 或 120 开始。然后看残差:如果残差还有"低频结构"在 ACF 上显著,说明窗口/带宽该加大。
# 用 Ljung-Box 检验帮窗口选择 from statsmodels.stats.diagnostic import acorr_ljungbox from statsmodels.tsa.seasonal import seasonal_decompose for window in [7, 14, 30, 60]: decomp = seasonal_decompose(s, model="additive", period=window, extrapolate_trend="freq") resid = decomp.resid.dropna() p = acorr_ljungbox(resid, lags=[10], return_df=True)["lb_pvalue"].iloc[0] print(f"period={window}, lag=10 的残差 Ljung-Box p 值 = {p:.3f}") # 选 p 值最大的那个 period:残差最白,窗口最合适
四、一个工程小坑:边界的 LOESS
LOESS 在序列两端的"边界"会变窄——因为窗口往左或往右没有足够邻居。statsmodels 的 lowess 默认会用 return_sorted=True 返回的拟合在外侧偏短,业务上需要的话可以加 it=3(迭代 3 次稳健拟合)来减少异常值对边界的影响。
五、把趋势估计和业务对齐
最后一条容易忽略的原则:趋势估计的"窗口/带宽"应当与业务关注周期对齐。
- 你做"季度销售预测" → 趋势估计用 3–6 个月窗口。
- 你做"下一年采购计划" → 趋势估计用 12–24 个月窗口。
- 你做"小时级运维" → 趋势估计用 1–3 小时窗口。
不是技术问题,是问题对齐问题。
本节要点回顾
- 三种工具:SMA、LOESS、参数回归,依次对异常值的鲁棒性更好、对解释性更弱。
- 窗口/带宽经验:日数据从 7/14 开始,月度从 6/12 开始;用 Ljung-Box 检验残差帮选。
- 工程默认:STL 分解(基于 LOESS)对业务数据最稳。
- 业务对齐:窗口大小要跟业务关注周期匹配,不是越大越好。
- 下一节线索:3.3 把识别出的趋势"剥掉"——差分与去趋势的工程实现,给 ARIMA 等下游方法铺路。
图:移动平均的平滑效果对比
评论区
(0)
U