2.2 数据预处理技术
2.2 数据预处理技术
本节摘要:洗干净的数据还要变成数值可用、量纲一致、分布友好的形态。本节讲解标准化与归一化的区别、偏斜变换、类别特征的编码方式,以及它们对梯度型模型与树模型的差异化影响。
学习目标
阅读完本节,你应当能够:
- 区分标准化(Z-score)与归一化(Min-Max),并在对应场景选用。
- 识别需要做偏斜(对数)变换的长尾特征。
- 正确编码类别变量,理解独热与序数编码各自的代价。
- 说清为什么树模型可以不缩放、而神经网络和 SVM 必须缩放。
一、为什么要"管住量纲"
接着上一节的干净数据,新问题出现了:特征里既有"用户年龄 0-100",又有"用户收入 0-10万"。如果一个模型把距离解释为欧氏空间,那收入一列天然就碾压年龄——调参再卖力,也只是在给它想要的尺度做背景板。预处理的目的不是好看,而是让模型对每一维特征的感知是"公平"的。
二、标准化 vs 归一化,别混用
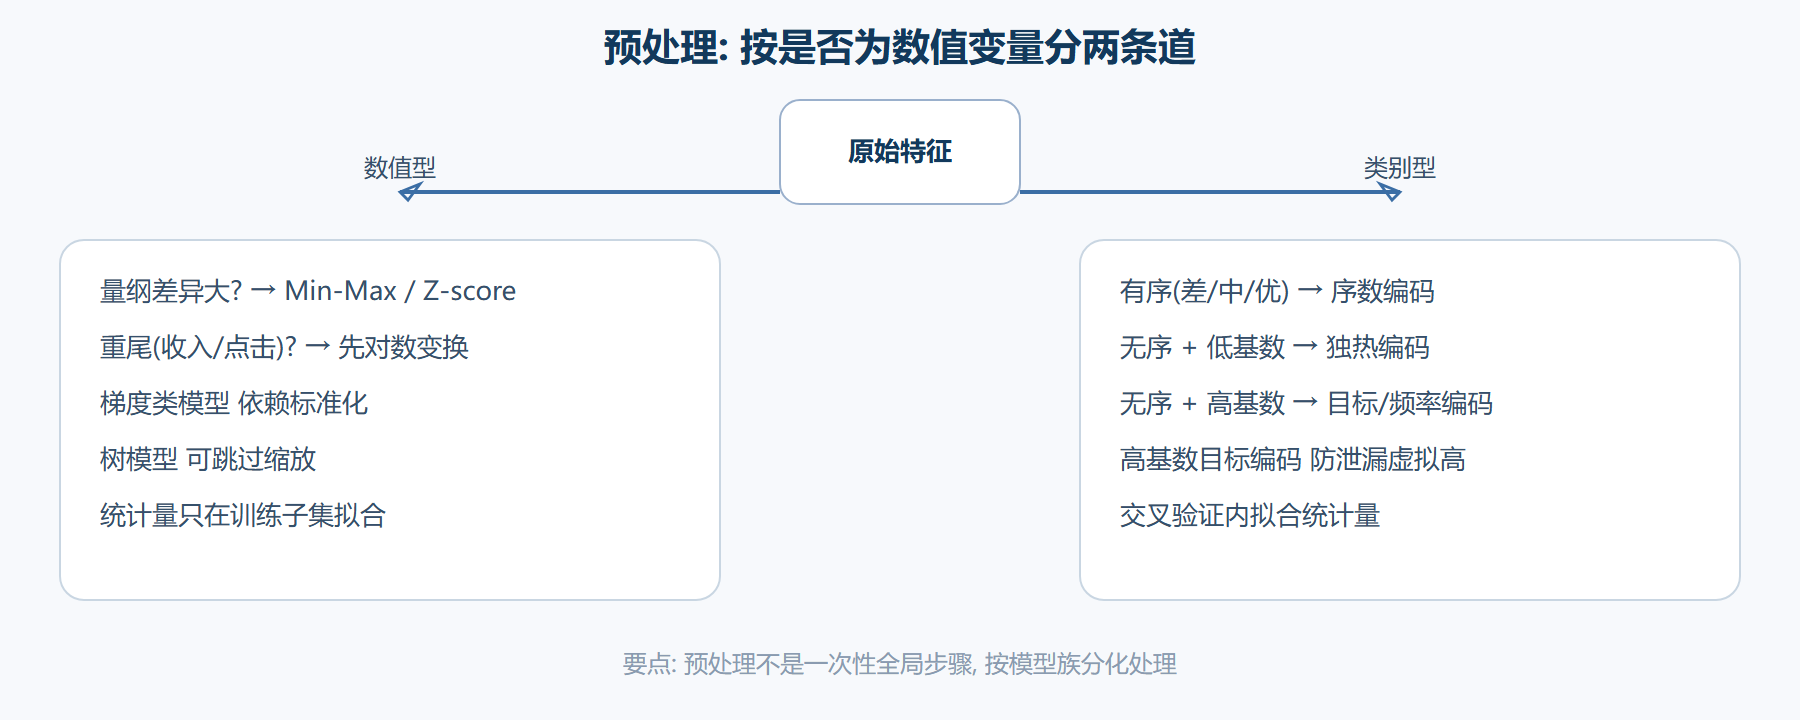
- Min-Max 归一化把值压到 [0,1] 区间,保留原始分布形态,适合距离型方法(KNN)、像素、以及需要固定下界的场景。
- Z-score 标准化用均值与标准差把分布拉成"零均值、单位方差",对离群值更稳健,适合大多数梯度型模型(神经网络、SVM、线性回归的正则项)。
选哪个,拼的不是谁更"标准",而是你的下游算法对尺度敏感与否、分布是否含重尾。重尾明显的用 Z-score 往往仍不够,还要加一层对数变换。
另外用一个分岔图把"数值型与类别型"两条预处理道并列看,更清晰:
数值型 / 类别型变量的预处理分岔
三、偏斜变换:对付重尾
收入、点击数这类特征长尾极重,"大多数人挤在低值、少数人爆高"。此时无论 Min-Max 还是 Z-score 都把主流挤成一团。一个划算的动作是先取对数让长尾收敛,再做标准化。判断要不要做的办法:画直方图,看是不是一边垮塌、拖一条老长的尾巴;或者用偏度系数粗看,明显偏斜就动手。
代价是解释性下降——你不再能直说"特征值等于收入",而是等于收入的对数是某种尺度。多数模型不介意,但你在写特征说明时要讲清楚。
四、类别特征编码:独热还是序数
类别变量是个坑。给"红、绿、蓝"编成 0/1/2 的序数/标签编码,模型会误以为"蓝色比红色更大"——只有类别本身有序(如 差<中<优)时才该这么用。否则用独热编码拉开成多个布尔列,代价是维度和稀疏度上升。
主流的经验法则:
| 情况 | 推荐 | 理由 |
|---|---|---|
| 类别有序(差/中/优) | 序数编码 | 保留顺序信息 |
| 类别无序且基数低 | 独热编码 | 消除虚假大小关系 |
| 类别无序且基数高(上万个 ID) | 目标/频率编码或嵌入 | 独热维度爆炸 |
| 树模型 + 高基数 | 可直接用标签编码 | 树不care大小,只care切分 |
⚠️ 常见坑:目标编码(用类别目标均值做特征)极易走漏信号——每个类别的均值里包含了本类样本的目标信息。一定要交叉验证内拟合,否则验证分数虚高得离谱。
五、对模型族的分化认识
预处理要不要做、做到哪,和模型强相关:
- 神经网络 / SVM / 线性 / KNN:强烈建议 Z-score 或归一化,否则收敛慢、且个别维度主导距离。
- 树模型(随机森林、GBDT):天然不care单调缩放,左右节点上的切分对 scale 不变,通常会省掉标准化这步。
- 特征间相关性高的:考虑去相关(后续特征工程章节提)。
这就是为什么"同一份数据,不同模型走不同的预处理"是常态,而不是把预处理当一次性全局步骤。
把这一节落到工程里,推荐搭一条最小预处理流水线并固定下来:先做分裂(数值/类别两路分支),数值路按"是否重尾 → 是否需要对数变换 → 是否 Z-score",类别路按"是否有序 → 是否高基数"走对应编码。每一步都写成一个可复现的函数,输入切换只靠一个配置开关。这样换模型族时,你只需把对应 pipeline 打开/关掉,而不会每次重写一遍预处理逻辑——也避免了"换了个模型却忘了换预处理"这种低级的坑。
这里再提醒一个相当常见的误解:预处理不是"无脑标准化就完事"。标准化只在模型对尺度敏感时才有意义,对树模型做与不做常无差别;而把标准化错误地套在有稀疏高基数整数特征(如点击 ID 类)上,反而可能把它压成假的重尾形态。所以每个预处理动作都要能回答"我为什么对这个模型做这一步",而不是沿用一个"标准动作模板"。这和你判断要不要做特征工程、要不要做增强是同一种"带着为什么去动手"的心态。
💡 关键直觉:把"标准化统计量只在训练子集上算"这条记牢——它和第一章防泄漏纪律是同一件事的两面,在预处理阶段一样成立。
如果非要用一句话概括这节最该带走的东西,那就是:预处理是"按模型族 + 按分布"的动态决策,而不是一条死记的固定工序。动手前先问两个问题——"这个模型对尺度敏不敏感"(决定要不要缩放)、"这个特征的重尾/稀疏形态值得不值得变换"(决定要不要取对数或换编码)。把这两个问题答对,你就已经绕开了预处理阶段八成常见的错误。剩下的,就是把它固化进一条可复现的流水线、单一因子地验证每一步,让每一次"做了变换 vs 没做"都有验证信号给你判据。
本节要点回顾
- 要点一:Min-Max 保留形态、Z-score 更稳健,按下游算法与分布选,别混用。
- 要点二:重尾特征先做对数变换再标准化,改善梯度模型的收敛。
- 要点三:有序类别用序数编码、无序且低基数用独热、高基数走目标/频率编码。
- 要点四:目标编码必须在交叉验证内拟合,否则信号走漏虚高。
- 要点五:树模型可省缩放,梯度类模型依赖标准化,按模型族分化处理。
预处理定好数值形态后,下一步做特征工程,让特征更具表达力。