2.1 数据收集与清洗实战
2.1 数据收集与清洗实战
本节摘要:数据准备的第一步是让数据"干净"。本节走一遍真实清洗流程——来源核验、去重、缺失值处理、异常值检测,给整个实验舱打下不掺水的底座,并给出每项操作的判据与代价。
学习目标
阅读完本节,你应当能够:
- 判断数据来源是否可靠、口径是否统一,识别"脏"的几种典型形态。
- 用可解释的规则做去重,而不是无脑去掉所有重复行。
- 为缺失值选择合适的策略(删除/填充/标记缺失)并说清取舍。
- 用统计与可视化定位异常值,区分"真异常"与"正常长尾"。
一、拿起原始数据,先别急着建模
顺着上一节的清单往下走:数据到了手,绝大多数工程师的第一反应是直接塞进模型。我把这称为"舍本逐末十次里有九次"的做法——脏数据进,脏结论出。清洗不是洁癖,是为后续所有实验保住地基。
先做"会前核对",把原料看一遍:来源是谁、采样时段、口径单位(是美元还是元、是天还是小时)、每列缺失与类型。很多看不见的坑都在这里埋伏着——比如标签字段里有几行的时间戳比特征还晚(未来信息),或者标注工具抽风给一小撮样本打了反标签。
核验口径尤其要花时间,因为它最不起眼却最致命。同一列"金额"可能在不同的历史版本里混用了美元和人民币、同一个"周"可能有些用自然周、有些用滚动周。这类错几乎不报错,却能悄悄毁掉你的基线。做法是抽几行原始记录对照业务同学核对含义、把两套口径是否真正一致写进记录,再决定是全量统一还是附带"口径标记"列。宁可多花一个下午在这,也远好过等模型上线后才发现"原来它的输入单位从来没对过"。
二、缺失值:先问"为什么缺",再决定怎么填
缺不全是坏事,缺失本身就是信息。处理前先判断缺失机制:是完全随机缺失、随机缺失(能由其他列推测)还是与缺失本身相关(例如收入越高的人越不愿意填收入)——最后一种,直接删行会留下系统性偏差。
给出一个务实的决策谱:
| 情景 | 推荐做法 | 备注 |
|---|---|---|
| 缺失比例极低 | 直接丢弃对应记录 | 最省事,信息损失可忽略 |
| 缺失随机且列重要 | 用均值/中位数/众数填充 | 快,但会低估方差 |
| 缺失能用他列预测 | 用模型的预测值填充 | 效果好,贵 |
| 缺失可能蕴含含义 | 新增"是否缺失"标志列 | 常有杠杆作用 |
| 缺失集中在某列且比例高 | 考虑整列拆分或删除 | 别硬填出一个假列 |
💡 关键直觉:填缺失用"训练子集上算出来"的统计量,别在全量上算——这和第一章的防泄漏纪律一脉相承。
三、去重:重复不总该删
两条记录"看起来一样",未必就是重复。真正要删的,是同一实体被录了两次(同一个人用了两个手机号、同一笔订单因重试写了两遍)。别写一句 drop_duplicates() 了事:得先明确以哪几列做主键,再决定保留哪一条(比如保留时间最早的一条)。
有一类"半重复"更要小心:特征几乎相同,但标签有分歧——这通常不是冗余,而是标注噪声,是数据质量报告里最该亮红灯的信号。
四、异常值:是真异常,还是长尾正例
异常检测最容易翻车的地方,是把数据的长尾当成脏。真实业务里收入、点击这些量常常是重尾分布,峰值极高掩人耳目。我的做法永远是先可视化(箱线图/直方图)再说话,而不是套一个固定倍数 IQR 一刀切。
数据清洗的四类操作判据
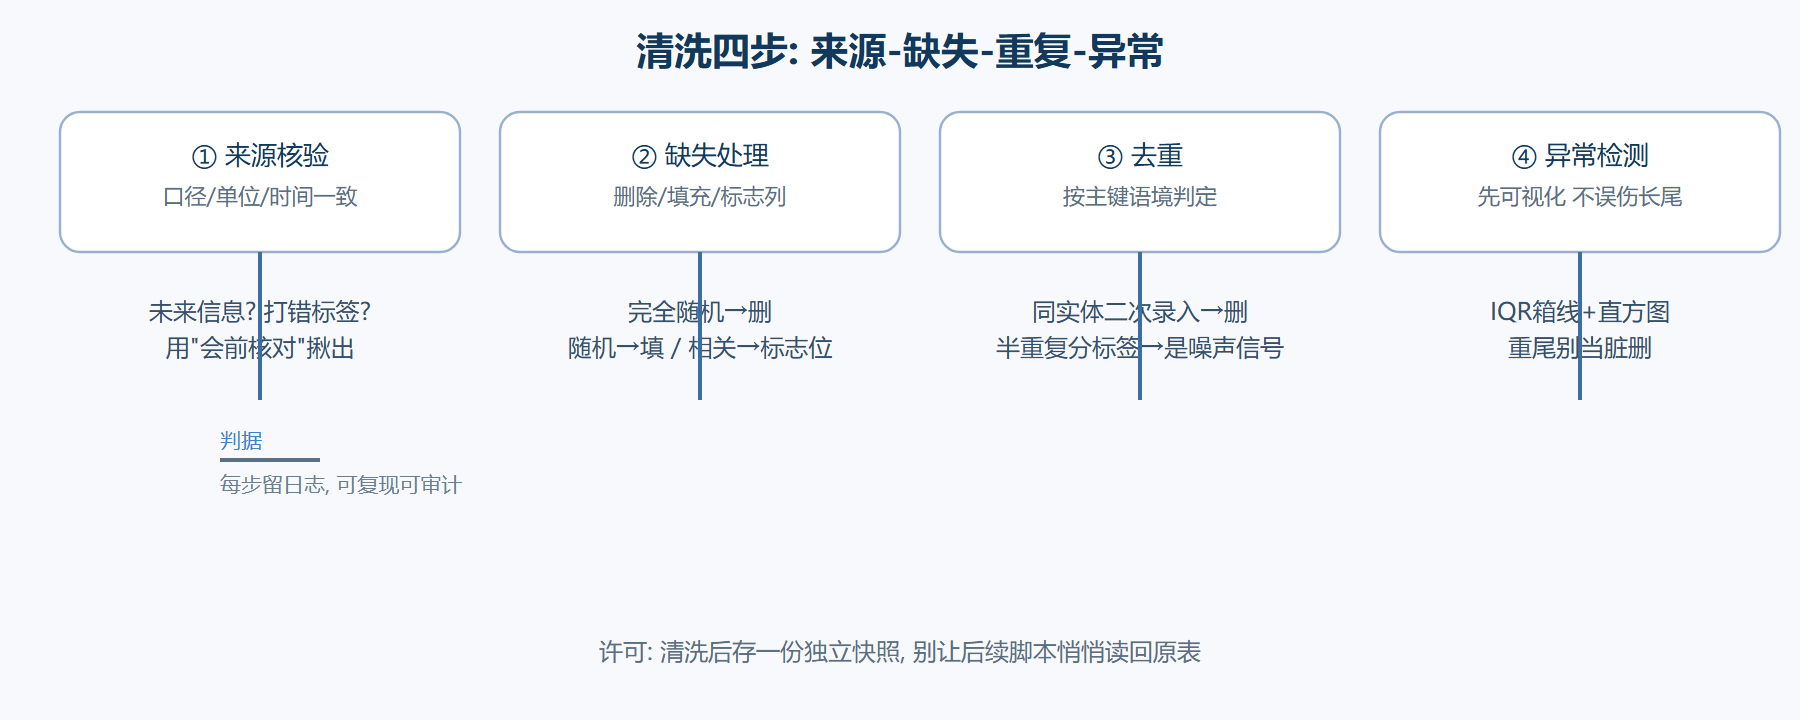
异常值处理后仍要保留判据痕迹:哪些值因为什么规则被调整或删除,全部记录在日志里。这样后续如果模型行为诡异,你能回溯,而不是靠记忆猜。
五、把清洗固化成一条可复跑流程
手工在表格里点,回头没法复现。更稳的做法是把清洗逻辑写成一段确定性流程(同样的输入永远给同样的输出),每次实验从它开始:
# 风格示意:清洗流程不动原数据,输出一份可复现的快照 import pandas as pd def clean_frame(raw): df = raw.copy() # 1. 统一列名与类型 df.columns = [c.strip().lower() for c in df.columns] # 2. 主键去重:明确主键列,保留最早一条 df = df.sort_values("ts").drop_duplicates(subset=["user_id", "order_id"], keep="first") # 3. 缺失:低比例直接删;收入列做标志位 df = df.dropna(subset=["label"]) df["income_missing"] = df["income"].isna().astype(int) df["income"] = df["income"].fillna(df.groupby("region")["income"].transform("median")) # 4. 异常:仅对明显录入错误兜底(如负数价格/超界年龄),长尾保留 df = df[df["price"] >= 0] return df.reset_index(drop=True)
上面这段只是示意,实际项目要按第 2、4 节的判据细化。要点是:可复现、可追踪、只在训练子集上拟合统计量,三者缺一不可。日志里记下每一步删了多少行、改了什么,报告里能讲得清,团队里才迈得过审计。
⚠️ 常见坑:清完了数据,结果在之后某次脚本里又悄悄读回未经清洗的原表,把前面所有清洗全部作废。给"清洗后快照"一个独立文件名,从它往下走。
再补一个关于"清洗的边界"的提醒:清洗不是万能药,别把脏数据的锅甩给它。当模型表现荒唐时,先分清是"值本身脏"还是"口径/结构错了"——口径错往往比个别脏值更致命,也更能解释系统性偏差。所以清洗阶段留好"改了多少行、依据哪条规则"的记录,未来排错时才知道该从数据层排查还是从特征层排查。数据这一环的价值,最终都靠"讲得清、可复现"兑现。
本节要点回顾
- 要点一:清洗前先问"缺失为何发生",缺失机制不同,处理方式完全不同。
- 要点二:去重要按主键语境判断,别无脑去重,半重复行常是标注噪声信号。
- 要点三:异常值先可视化再下结论,别把重尾正例当脏值删。
- 要点四:清洗写成确定性、可复现的流程,统计量只在训练子集上拟合。
- 要点五:每一步清洗都留日志与判据,让实验可回溯、可审计。
下一步把干净的数据进一步预处理成数值可用的形态。