3.1 常见模型类型图谱
3.1 常见模型类型图谱
本节摘要:调参之前先知道手里是什么模型。本节铺开常见模型族的全景——线性模型、决策树与集成、SVM、神经网络——对比它们的表达力、可解释性、数据与算力需求,并点出各族主要调用的旋钮,为后文超参数调优埋下索引。
学习目标
阅读完本节,你应当能够:
- 说出线性、树、SVM、神经网络四种族的适用任务与表达边界。
- 对应出各族最要紧的几个超参数(这些是后面调参的重点)。
- 判断什么样的数据结构更能让某个族发挥。
一、先记住一句话:模型族决定"可调的旋钮集"
顺着上一章的结论,我们手里有了清洗好的数据和可靠的验证协议。现在的问题是:拿什么模型去跑第一版基线。这里的洞口很深:不同模型族"能表达的假设空间"完全不同,而你后面能调的旋钮,也是由模型族决定的。本节的目的是在你动手前先搭一张"模型族 → 适用 → 要调什么"的地图。
二、四大族速览
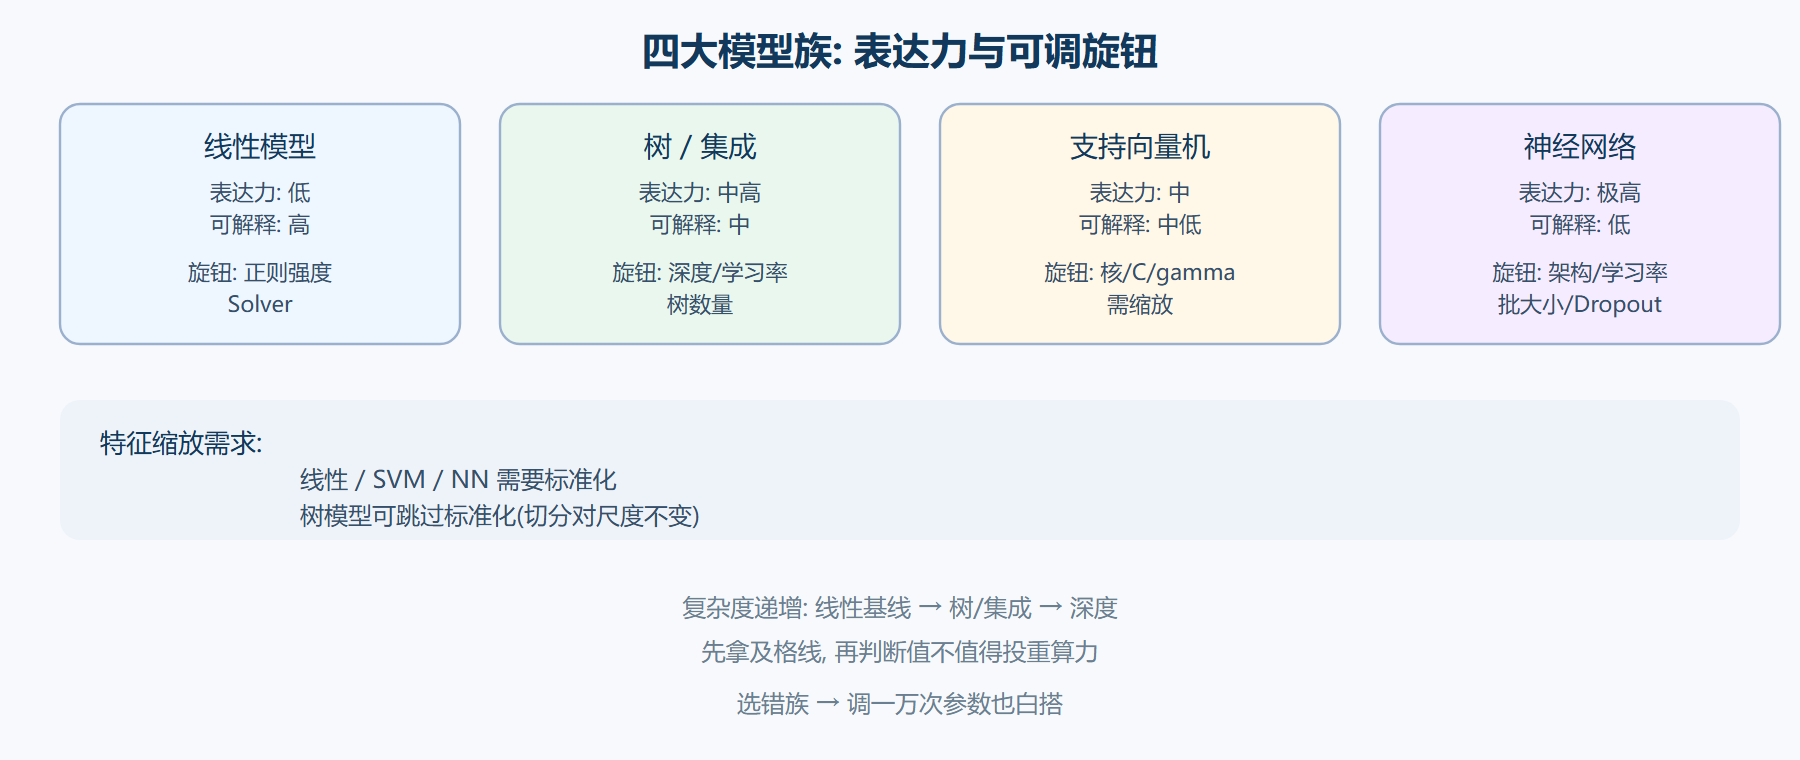
常见模型族的适用范围与调参旋钮
线性模型:便宜、可解释、边界有限
线性回归、逻辑回归、岭回归。表达的是特征的线性加权,学不了非线性交互(要非线性得靠特征工程硬造)。好处是训练快、系数可解释、对高维稀疏数据稳。核心旋钮:正则强度、是否特征缩放、Solver 选择。
决策树与集成:非线性强、几乎不用缩放
单棵树可解释但容易过拟合;集成(随机森林、GBDT、XGBoost、LightGBM)牺牲一点可解释换强泛化。树的可爱之处是它天然 care 单调缩放,你可以跳过特征标准化。核心旋钮:树深度、每片叶子最小样本、学习率(对 GBDT)、树数量。
支持向量机:核技巧的非线性
SVM 用核函数把输入映射到高维去拉分界,适合中低维、样本量不大的场景,尤其文本与信号类。核心旋钮:核函数、正则参数 C、核参数(如 RBF 的 gamma)。对缩放敏感,预处理那节的知识在此派上用场。
神经网络:最强表达、最大调参面
全连接网络、CNN、RNN/Transformer。假设空间大得惊人,能拟合任何连续映射,代价是超参数面极宽:层数、每层宽度、激活、优化器、学习率、批大小、Dropout……这也是本册后面大量篇幅回到它的原因。对数据量和算力要求高,起步要小心欠拟合。
三、各族怎么配合:基线先行
成熟的路线不是一上来就挑最强的,而是按复杂度递增建基线:
先跑一个最便宜的线性基线拿到"可达到的及格线",再用树或集成测非线性收益,最后才把重投入砸到深度模型。这样既给调参留了参照,也避免一开始就在最贵的旋钮面上抓瞎。每一层的基线分数,都是后面判断"这一族到底值得不值得继续投算力"的依据。
💡 关键直觉:很多调参翻车,源于在"模型族就不对"的前提下猛调参数。一个线性拟合不出的模式,调一万次逻辑回归正则也白搭——先检查族,再调参。
初学时常有一种困惑:"既然神经网络表达力这么强,为什么不一律都用它?"原因是表达力强不等于划算。神经网络的强假设空间只在你数据够多、算力够用、且你肯投入调参时间时才兑现;数据只有几百行时,它的容量常常成了弊而非利——容易过拟合、难调。反过来,树/集成在中小数据上往往"又稳又好调",系数还能讲给人听。所以"选族"不是"挑最强",而是"在数据规模、可解释性、算力三者之间找那个平衡点"。这也是为什么经验里常常"树先打底、不够再上深度"而不是反着来。
再补一句关于"换族"的时机:当你发现当前模型在验证集上已经"瓶颈很久、怎么调都上不去",先别急着加容量或猛调,而是问一句"这个族是不是本身就到了表达上限"。一个低成本的做法是拿一个与你问题边界差异较大的族(比如从线性换到浅层树、或从深度网换到线性+SVM 核)跑个基线对比——如果差一个族就明显不同,说明你之前卡住的往往是"族的选择",而非"旋钮的取值"。这种"先换族看差异"的试探,往往比在同一族里苦寻更好的超参性价比高得多。
还有个对外行也适用的判断,能帮你快速圈定族的选择范围:看你的问题吃不吃"非线性 + 交互"。如果你和业务聊下来发现"两个特征合起来才有意义、单看都是噪声",那线性模型几乎注定不够用,直接往树/集成或加特征工程的方向走;反之如果问题大体是线性的、可解释性又摆在那,就不必为一个几乎不存在的非线性收益去背复杂模型的成本和黑箱。把"问题里有没有强交互"当成选族的第一盏绿灯,许多纠结会在动手前就消掉一大半。
再把"族"和"任务类型"对上:同样是"分类",稀疏高维文本数据(词袋/词向量)往往先试逻辑回归或 SVM,因为它们对高维稀疏各有天然处理;而图像、序列这类自带强结构的数据,则直接往 CNN/RNN/Transformer 的方向起步,因为它们的架构本身就在编码这种结构。换句话说,选族不只要看"数据多少、要不要交互",还要看**"数据的结构和你手上的族是否天然对路"**。这一条把第一节的"模型族 → 适用"和"任务类型"两本账叠在了一起,也是你练习"先对号入座、再细看族内"的好入口。
四、一张速查表
| 模型族 | 表达力 | 可解释性 | 缩放需求 | 主要调参旋钮 |
|---|---|---|---|---|
| 线性 | 低 | 高 | 需要 | 正则强度、Solver |
| 树/集成 | 中高 | 中 | 不需要 | 深度、学习率、树数 |
| SVM | 中 | 中低 | 需要 | 核、C、gamma |
| 神经网络 | 极高 | 低 | 需要 | 架构、学习率、批大小、Dropout |
⚠️ 常见坑:在可解释性要求极高的合规场景强行上神经网络,训完面对审计拿不出一个能解释的系数——选型时把可解释性当硬约束而非软偏好。
本节要点回顾
- 要点一:模型族决定可调旋钮集,选错族则调参无意义。
- 要点二:树的可爱在于可跳过特征缩放,神经网络与 SVM 必须缩放。
- 要点三:按"线性→树/集成→深度"的复杂度递增建基线,拿参照判断投入。
- 要点四:神经网络表达最强但调参面最宽,最考验实验纪律。
下一节把选型从"用哪个族"落到"在约束下敲定哪个具体模型"。