3.2 模型选择的原则与考量
3.2 模型选择的原则与考量
本节摘要:模型族定了,还要在约束下敲定具体模型。本节把"选型"拆成可判定的三方权衡——数据量与形态、可解释性、算力与延迟——外加问题类型与时序性的硬约束,给你一张能照着走的选型决策图,并讲清第一基线的意义。
学习目标
阅读完本节,你应当能够:
- 用"数据量、可解释性、算力"三角做初步选型,并说出各自的硬约束。
- 把问题类型映射到候选模型(分类/回归/聚类/排序/时序)。
- 解释为什么"先选一个稳的基线、再迭代"在调参里是省时策略。
一、选型没标准答案,但有可判定的约束
上一节铺了模型族,但"族内选谁"仍让人挠头。我见过的误区是拿"性能最好"当唯一标准——可现实中性能最好往往是最贵的那个,上线还得被可解释性与延迟反咬。本节把选型变成一套在约束下做取舍的流程,而不是一场"谁最强"的比拼。
二、三根约束杆
① 数据量与数据形态:数据少,先想浅层模型;数据多且关系非线性,才轮到深度模型发挥。特征维度高且稀疏,线性与树模型更稳;图像/文本/序列天生偏神经网络与特殊架构。
② 可解释性:能做特征重要性排序(树)还是只能给黑箱概率(深网),取决于是否对着监管或会客。合规场景先把可解释性当硬约束写进人选。
③ 算力与延迟:训练时间与在线推理延迟决定了你是否玩得起某个模型。预算紧,别在深度模型上耗,回头用树/集成先过关。
三、问题类型:先对号入座
把"三根约束杆 + 问题类型"合到一张选型决策图,动手时照着走:
选型决策图的读法
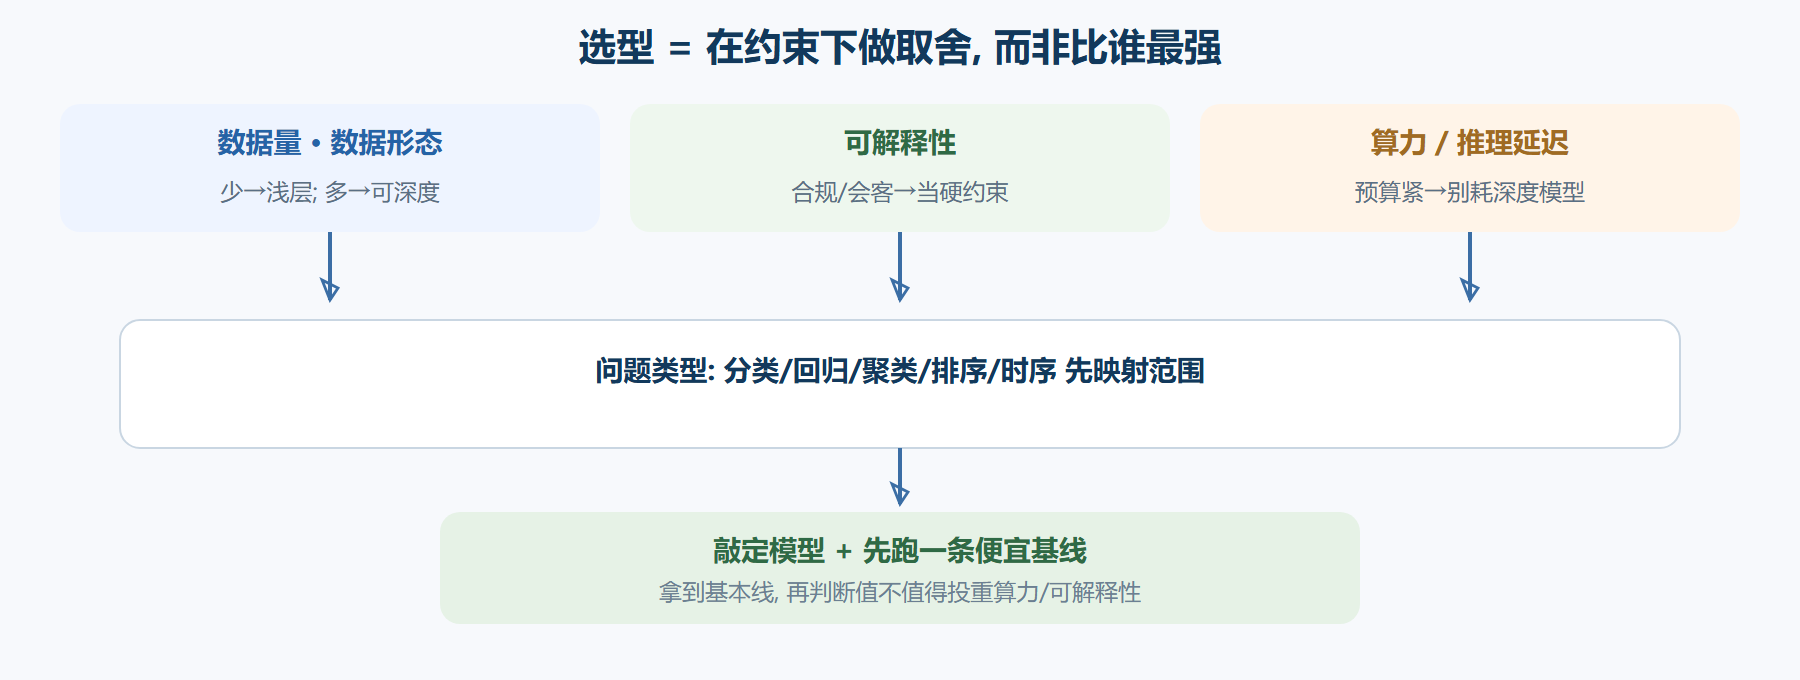
选型的第一份映射表由问题类型给出:
| 问题类型 | 参考模型范围 | 关键考量 |
|---|---|---|
| 二/多分类 | 逻辑回归、树集成、SVM、NN | 类别不均衡时先走采样/加权 |
| 回归 | 回归树、支持向量回归、NN | 重尾目标先变换 |
| 聚类(无监督) | KMeans、层次、DBSCAN | 依赖距离定义,必须缩放 |
| 排序/推荐 | 排序树、NCF、双塔 | 负样本与位置偏置是重点 |
| 时序预测 | ARIMA、Prophet、LSTM/Transformer | 时序泄漏规矩直接适用 |
四、第一基线:先把"及格线"拿到手
选型不是一次到位的豪赌,而是先按复杂度最低的做法拿到一条及格线。这条线的作用有三:一是确认数据与特征串得上(更早暴露泄漏问题);二是给后续复杂模型的每次提升提供对照;三是你在"值得不值得升级"上有了客观依据,而不是凭感觉换到重模型。
我把这个习惯称作"够用原则":先让最便宜的模型把流程跑通并给出底线分数,只有流动方向和利益都明确后,再投更贵的位置去争取收益。这一习惯在本册第八站的实战案例里会再次验证。
⚠️ 常见坑:跳到最强模型后,把它的成败错判为"调参问题"——其实可能只是选型超了预算或数据支撑不起复杂度。把基线分数钉在墙上,回头看每个决定是否站得住。
💡 关键直觉:选型决策可以记成一行实验假设:"如果换成更复杂模型,预期提升 XX、但要多花 XX 算力、牺牲 XX 可解释性"。把每个选型都写成可验证假设,后面才能否认、能复盘。
五、一个走到底的选型实例
纸上谈兵不如跟着一个具体例子走一遍,把前面四节拧成一根绳。假设你要做一个二手房价预测(回归问题),手头有两万条带"面积、房龄、楼层、商圈、挂牌次数"的样本,业务方要求能解释"为什么给这套房估这个价",并且线上推理要控制在几十毫秒内。你对照那三根约束杆:数据量中等(两万行)、可解释性明确是高要求、算力不富裕。问题类型是回归,目标"房价"重尾明显。这样一轮下来,深度模型基本可以先出局——它既要为可解释性额外准备解释器、数据量又不足以压榨出那点表达力优势,属于"投得多、回得慢"。
于是你先按"够用原则"把最便宜的稳住:上一节图谱里的线性回归或回归树。你给房龄、面积做标准化,给房价做对数变换(呼应预处理那节的重尾处理),跑出一个基线分。这个分不是终点,而是坐标系——接下来你想试"树集成能否带来实质提升",它每提升一档,都要拿基线对照、并问"多赚的这块值得多花的时间和不可解释性吗"。假设 GBDT 真的在验证上比线性好了一截,但业务方坚持要可解释性,你的答案不一定是"换回线性",而是在树模型上叠加 SHAP 这类事后解释——既保住了准头上的收益,又补上了可解释性的硬约束。这一步就是"在约束内找折中",而不是"谁强娶谁"。
还有一个别忽略的时间维:选型对算力的约束也会随"数据量"一起变化。刚才两万行时深度模型不划算,但如果半年后数据涨到了几百万行、且你手里多了一台带 GPU 的机器,同样的取舍可能要重算一遍——这时神经网络那点被数据量压住的优势才开始兑现。所以选型不是一次性的决定,而是一份会随数据、算力、业务要求而修订的活文档。这也是为什么前面反复强调"把每个选型写成可验证假设":当假设的运行条件(比如数据量)变了,你才有依据去判断"是该升级,还是继续保持"。选型跟着证据走,而不是脾气走。
再往深看一步:如果你当时不管三七二十一直接上了一个多层神经网络,很可能最后发现"验证涨得不多、解释又做不清、推理还超了预算",然后在排错时误以为是自己调参没到位。这就是选型决策没写清的代价——它会把问题伪装成调参问题。而这里你因为先立了基线和假设,就能明确地写下:"换 NN 的预期提升 ≤ x,但要多花 z 算力、牺牲可解释性,不值"—于是干脆利落地拒绝了一个陷阱。选型的价值,恰恰是帮你主动放弃那些"看起来厉害、实际上亏"的选择,把有限时间留在收益最确定的方向上。
本节要点回顾
- 要点一:数据量、可解释性、算力三根杆共同约束选型,性能不是唯一标准。
- 要点二:问题类型先映射候选范围,再在约束内收敛。
- 要点三:先做最便宜基线的意义是早暴露泄漏、提供对照、判断投入。
- 要点四:把每个选型写成可验证假设,便于事后复盘。
模型定下来,再往深处走一步:参数与权重从什么数值起步,决定第一轮训练是欠拟合还是健康收敛。