4.3 梯度下降及其变种
4.3 梯度下降及其变种
本节摘要:梯度下降是训练怎么往下走的内核。本节把全批量、随机 SGD、迷你批三档讲清,再展开动量与自适应学习率如何应对"慢、震荡、卡"三个典型问题,配一张不同学习率下同一损失的轨迹示意。
学习目标
阅读完本节,你应当能够:
- 区分全批量、随机、迷你批三种梯度下降的噪声与算力代价。
- 解释动量为什么能压震荡、跨洼地。
- 通过学习率太大会震荡、太慢不收敛的直觉,学会选学习率的起手范围。
一、一个"下坡"问题
如果说损失是山地形,训练就是在山上找最低点,梯度下降就是"顺着当前点的最陡下坡走一步,再重复"。这个朴素算法有一堆变种,区别只在"你拿多少样本来估方向"和"这一步走得有没有技巧"。
二、三种"样本口径"
- 全批量梯度下降:每次更新都用整个训练集估梯度——方向准,但每走一步都要全量计算一遍,大数据集下慢得没法用。
- 随机梯度下降 SGD:每次只用一个样本估梯度——足够便宜,但方向噪声大、曲线抖。
- 迷你批梯度下降:取中间的迷你批——现代实质默认,兼顾效率与稳定。上一节的批大小其实就在定这档。
三者在本质上是同一条思路的三个采样口径,只是噪声与算力的天平不同。
三、"走"得不好有两种病:震荡与卡住
单纯依梯度下坡会碰上两个病。一是震荡:在狭长谷地,梯度在垂直轴上来回抖、前进缓慢。二是局部洼地/平原:梯度变平的地方,看似走到了"底",其实是洼地或鞍点,困住了。
解法之一是用动量:把过去几步的移动方向当成"惯量"叠加到本步上。想象一个滚下坡的球——它带着历史速度,能弹过零散的小波动,不太容易被小洼地拦住,还能在谷地沿主方向越走越稳。第二个解法是自适应学习率(RMSProp 的思想):对每个参数,按它历史梯度的平方来缩放步长——梯度一直很大的维度步子收小,一直平缓的维度步子放大,于是对每个旋钮的尺度不再一刀切。
四、学习率:一个旋钮左右成败
学习率决定了"这一步迈多大",是整册超参里最要紧的旋钮之一。三个速写:
- 太大:一步跨过山谷、来回震荡甚至发散,损失曲线像锯齿乱跳不下。
- 适中:稳定下行,训练损失平稳收敛。
- 太小:像蜗牛爬,训练半天损失几乎不动,白白烧算力。
不同学习率在同一损失曲面上的轨迹
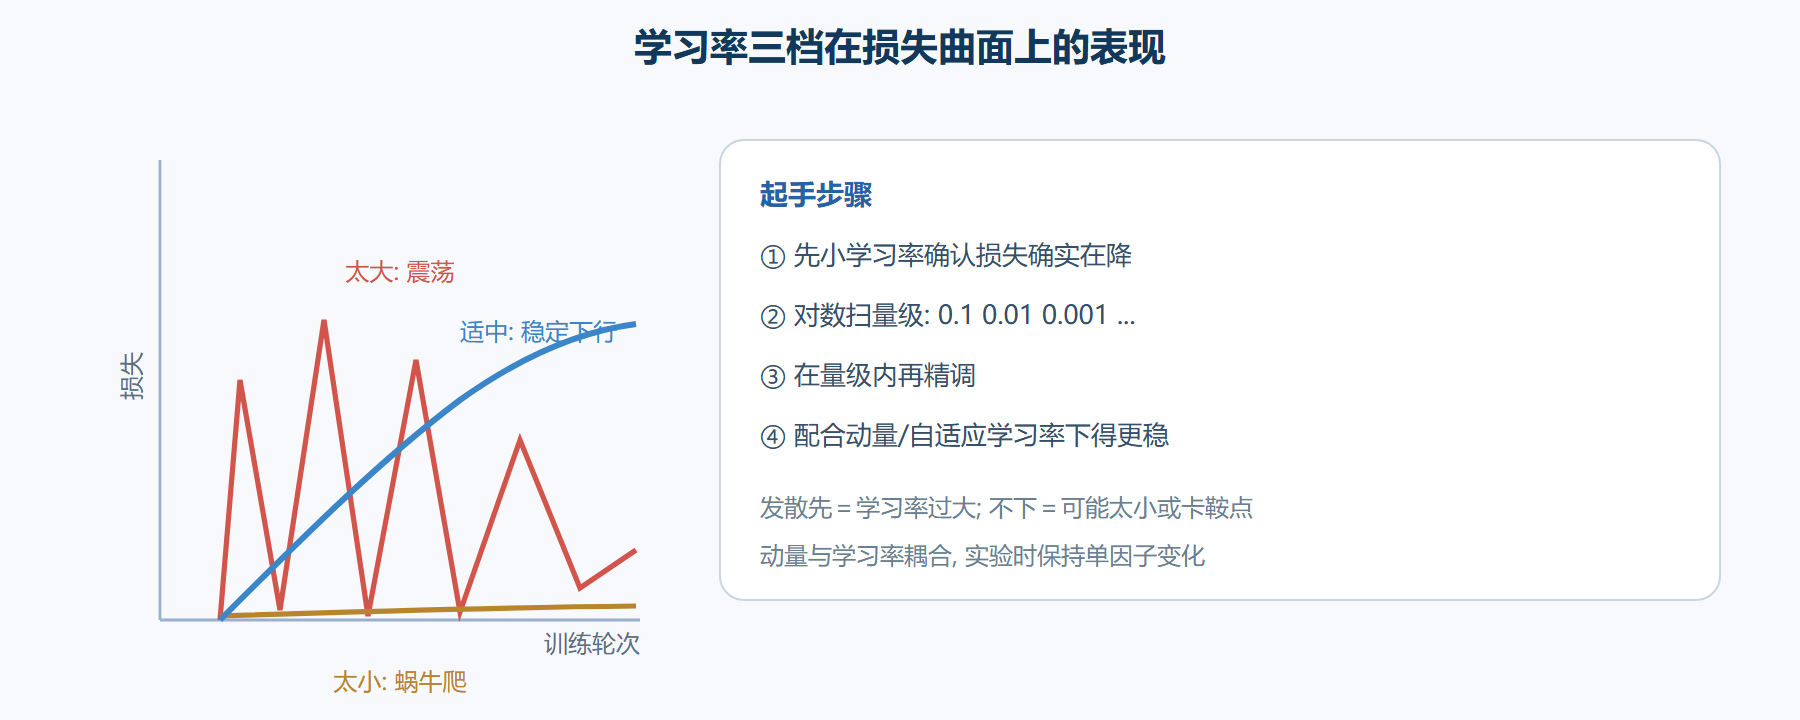
起手经验:先试一个偏小的学习率确认损失确实在降,再用"对数扫"(0.1、0.01、0.001…)粗定量级,之后才在此范围内细调。学习率若配合好动量或 Adam 的自适应,往往能下得更稳。
# 示意:登录扫描学习率的量级 for lr in [1e-1, 1e-2, 1e-3, 1e-4]: run_trial(lr=lr, epochs=5) # 记录每档的损失下降轨迹,挑平滑下降且快速的
⚠️ 常见坑:动量与学习率是耦合的——加大动量后,同样的学习率效果会不同;在一次实验里同时改两个而没控制变量,你分不清是谁带来的提升。这就是"超参实验要单因子变化"的雏形,第六章会正式化。
💡 关键直觉:如果你看到损失曲线"先降后长期不动",不一定是走到谷底,可能是在鞍点/平原。试着加大学习率或加一点噪声冲出它,看看曲线是否继续下探。
五、把"步法"也当成要调的旋钮
很多人把优化器当成固定不变的黑箱,但"步法"本身就是一组值得单独实验的旋钮。动量系数、权重衰减、是否加一点梯度裁剪(clipping),这些都会改变"这一迈怎么落",而且它们和学习率之间是强耦合的——改了一个,另一个的最优值往往也要跟着动。所以我不建议一开始就在优化器内部到处拧,而是先固定一套被验证过的常见组合(比如 Adam 默认 + 轻微 weight decay + 较小学习率),把模型整体训通,再回头把优化器当一个整体去评估"换一下有没有净收益"。
这里有三个特别容易踩的细节。一是梯度裁剪和损失图:训练早期偶发爆炸梯度时,裁剪不是掩盖问题,而是给训练一个稳定的前提——但裁剪阈值本身要调,太大没用、太小又压掉了真实的梯度信息。二是权重衰减和 L2 不是一回事:在 Adam 这类自适应优化器下,直接对损失加 L2 项和把 weight decay 放进更新式里,行为并不相同,别指望"同一个正则参数"在两套实现下产出一样的效果。三是**"恢复最好点"而非"用最后一个点"**:优化器停下时停在哪个位置会受动量余波影响,真正该拿的是训练过程中验证最好那个检查点,这也是第四章监控一致的老规矩。把这三点想透,"怎么迈步"就从玄学变成可以单因子验证的普通旋钮。
六、学习率与批量耦合的一张经验撮要
批大小不是你随手挑的"工程细节",它和学习率一起决定"每步的有效学习强度"。经验上,批大小翻倍时,常常可以把学习率也适当调大(线性缩放大致方向),因为梯度估计更稳、允许迈更大的步子;反之批太小、梯度噪声大,学习率就得压小。但这只是"方向性的经验",落到你的模型上仍要用验证信号核实。一句话:批量与学习率通常一起定,而不是孤立地各自拍脑袋。把这一茬和前面"动量与学习率耦合"放在一起看,你就明白为什么第六章反复强调"一次只动一个旋钮"——它们互相咬合,一起动就说不清是谁的功劳了。
若要让"步法"的理解再落地一点,不妨养成一个动作:把训练早期若干步的参数更新可视化出来(比如画梯度范数、每轮步长随 epoch 变化)。你往往能亲眼看到"学习率太高时梯度范数狂跳、太低时步长小得可怜"——这种"看得见的证据"比任何抽象的公式都更能帮你记住该往哪个方向调。可视化不是炫技,而是把"下坡走法"从看不见的数值变成可感知的曲线,让'这一步迈得合不合理'这个判断,第一次有了直观的抓手。
本节要点回顾
- 要点一:全批量/随机/迷你批是同一下坡算法的三种采样口径,现代以迷你批为准。
- 要点二:动量用"惯量"压震荡、跨洼地;自适应学习率按维度调步长。
- 要点三:学习率太大会震荡发散、太小不收敛,起手先扫量级。
- 要点四:动量与学习率耦合,实验时要单因子变化。
- 要点五:"先降后不动"可能是鞍点,试图冲出它再看是否继续下探。
下坡走法有了,最后一块是训练过程怎么被观察和叫停——训练监控。