4.4 训练过程监控
4.4 训练过程监控
本节摘要:训练不是跑完看分数,而是在过程里被读数和叫停。本节教你读损失曲线——识别下得去、下不去、越拉越开三种形态;设置收敛判定、检查点与简单提前停止,把训练从盲盒变成可观测、可干预的过程。
学习目标
阅读完本节,你应当能够:
- 从训练/验证损失曲线诊断欠拟合、过拟合、发散三类问题。
- 用验证损失做收敛与提前停止的判定,而不是只看训练损失。
- 设计检查点策略,防止算力白烧。
一、让"过程"可见,排错才有素材
不少团队把训练脚本写成一个只能产出最终分数的黑箱。可真到调参排错,最能给线索的从来不是最终分,而是过程曲线。本节给训练装上仪表盘——每个 epoch 记录训练损失与验证损失,训练结束就能画出两条随时间变化的曲线。
二、损失曲线的三张脸
把这两条曲线一起看,几乎总能套到三种典型形态:
- 两张脸都低且贴近:正常训练,模型学好且没明显过拟合,可以继续加容量或换更强模型争取上限。
- 训练降、验证升(剪刀口拉开):过拟合逼近——模型开始背训练集,泛化在退化。对策是正则、早点停、加数据、降容量。
- 两张脸都下不去、停在平地上:欠拟合——模型容量或特征不够吃下数据规律。对策是加容量、加特征、减正则、降学习率查是否收敛太慢。
训练与验证损失的四种走向判别
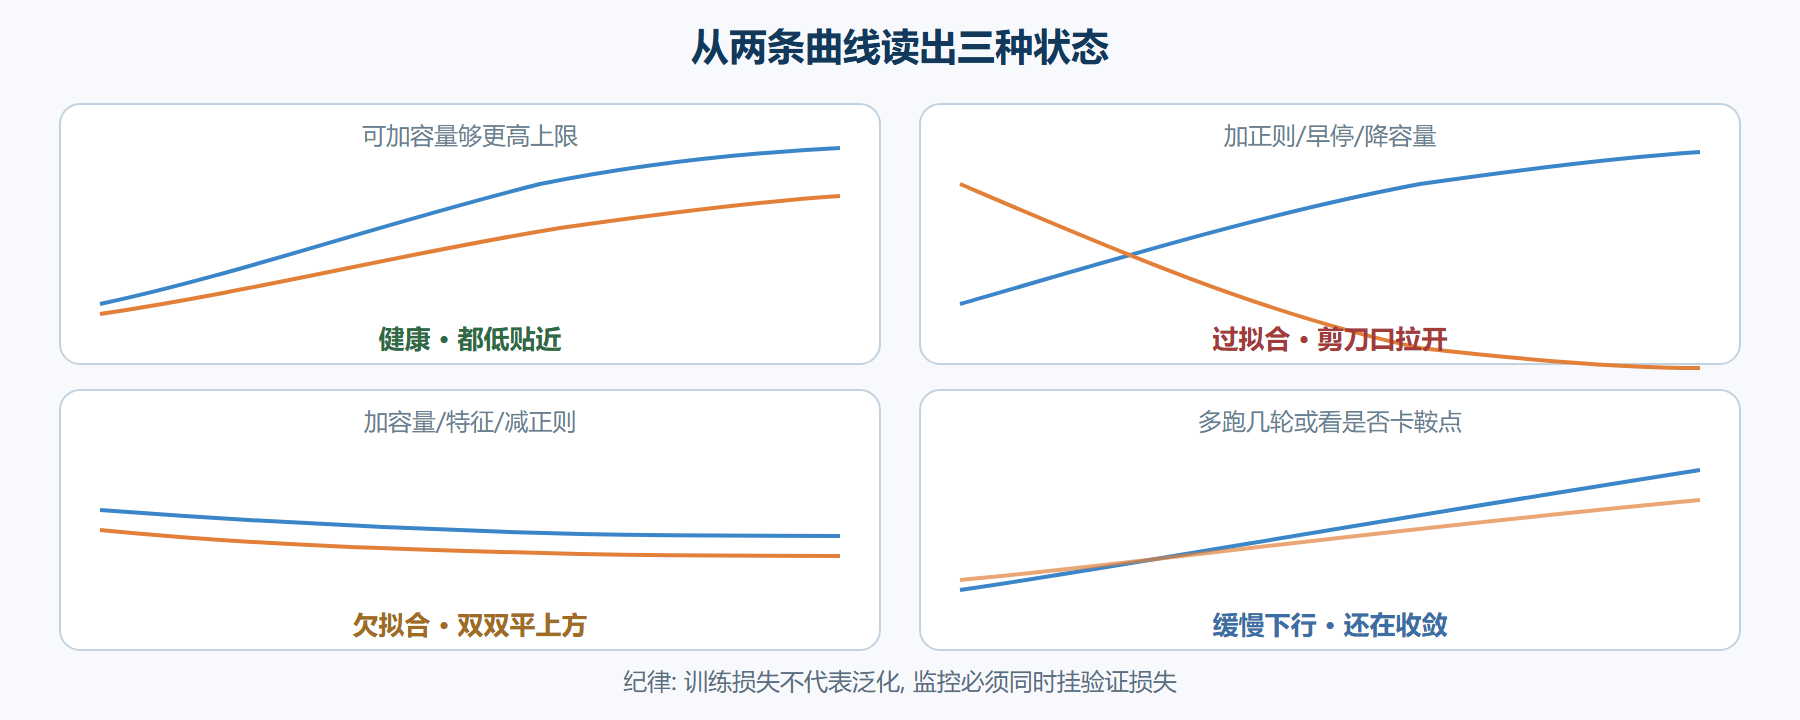
读曲线的关键纪律:训练损失不代表泛化(那是第一章三把尺子里的第一条),所以监控里一定要同时挂验证损失;单看训练曲线会误判。
三、收敛与叫停:把训练管起来
"训练多少 epoch"不该靠拍脑袋。更稳的做法是看验证损失:当验证损失连续若干 epoch 不再下降(甚至回升),就该考虑停止。这就引出了下一章要正式讲的提前停止——本节先在监控里埋下它的判据:记录"最佳验证损失和对应检查点",一旦触到停止条件,回滚到那个最优点,不拿最后的过拟合点当结果。
# 示意:训练监控骨架(概念性) best, patience, wait = 1e9, 5, 0 for epoch in epochs: train_loss = run_train(epoch) val_loss = evaluate(epoch) log(epoch, train_loss, val_loss) # 读入仪表盘 if val_loss < best: best, wait = val_loss, 0 save_checkpoint(epoch) # 存最好的那版 else: wait += 1 if wait >= patience: # 5 轮不改善即停 break
四、检查点:防算力白烧
训练中途崩一次、断电一次,从头再跑,是最大的隐性浪费。对策是周期性地存检查点(状态、优化器,最好连随机状态一起存)。崩溃后从最近的检查点接着跑,而不是归零。检查点的频率取内存与算力的平衡:模型大,就拉长间隔;模型小,可以每个 epoch 存一次。
⚠️ 常见坑:只记录训练损失、不记录验证损失,还拿训练曲线判断"是否过拟合"。从第一节就说了,过拟合只有在训练与验证对照时才看得见。仪表盘必须同时挂两条线。
💡 关键直觉:监控数据的意义不止用于当下——把每次实验的曲线存档,你就在积累第一手的"超参-曲线形态"经验库。后文调参心法里,这些"当时我见过哪种曲线"的记忆,比任何书本规则都更值钱。
五、读曲线要避开的三个"自欺"
曲线人人会画,但不少人栽在"读错了自己想要的结论"。最常见的三种自欺,我逐一拆开。一是只挑"平滑的那一段"看:训练早期损失天然抖得厉害,有人会跳过开头只盯着中段说"看,多平稳"——可真正要警惕的过拟合迹象往往出现在后期剪刀口,跳过等于让眼睛替你删掉了最该看的证据。二是把"验证动了 0.0001"当成提升:曲线再美,判断"有没提升"要看是否大于多种子的自然方差,否则你只是在给噪声写表扬稿。三是拿"训练损失已经很低"就宣布成功:训练损失低跟泛化好是两回事,第一章的尺子一已经讲过,这里只是提醒你监控表上"训练 == 验证 == 业务报告"三行都要摆齐,别只盯一行自我安慰。
六、监控的最小"仪表盘"清单
把上面的讲法收敛成一张可照做的最小清单,落进每个脚本就够用:记录逐 epoch 的训练损失、验证损失、当前学习率、本轮耗时;每 N 轮把"最佳验证损失对应的检查点路径"和"目前最好分数"写在日志头部,方便随时恢复;如果用了学习率调度,把每个 epoch 实际用的学习率也打出来,否则你复盘时根本不知道曲线在哪一段对应多大的步长。这几行加上一个简单的曲线绘图,就能让你在下一次改动前"先看图、再动手"。这一套虽然朴素,却是把训练从"黑箱输出一个分"变成"可解释、可归因"的关键一步。
最后再补一个关于"监控与调参的联动"提醒:监控不只是画给事后看的,它要能反过来驱动你当下这一轮该动什么。例如当你看到验证损失过了某个 epoch 后开始回升,这就是"剧情节点"——提醒你此时该考虑提前停止,或去检查是不是学习率需要调度衰减了。训练过程里的这些拐点,往往是比"最后一分"更早、更明确的信号。会读曲线的人,不是等训练跑完才评判,而是一边跑、一边根据曲线的走向实时调整策略。这也是你从"会训练"迈向"会实验"时,最容易进阶的一步。
把这一节和整册的线索扣一下:监控是你和训练之间唯一的"实时对话"窗口。它把第四章的"训练流程"与第五章的"泛化管理"真正连起来——你在监控里看到过拟合迹象,才接得上后面那张"正则/Dropout/提前停止"的处方单。所以别把监控当成"顺便打几行 log"的杂活,它是你所有调参动作的事实依据。给足它的地位,你会发现后续每一次"该拧哪个旋钮"的判断,其实都在这里有了预演。
本节要点回顾
- 要点一:训练/验证两条损失曲线是排错的第一手证据.
- 要点二:三态判别——双低贴近=正常、剪刀口=过拟合、双平下方=欠拟合。
- 要点三:训练损失不代表泛化,监控必须同时挂验证损失。
- 要点四:用验证损失判收敛与停止,回滚到最佳检查点而非最终点。
- 要点五:周期性存检查点,把崩溃成本压到最低。
- 要点六:把曲线存档,积累自己的超参-曲线经验库。
训练能观察到、能被叫停后,第四章的回路就完整了。下一章摆开对抗欠拟合/过拟合的武器。