6.1 超参数类型与它们的影响
6.1 超参数类型与它们的影响
本节摘要:动手搜索之前,先给超参数排队、找最重要的抓手。本节把超参数分成"决定能否收敛、决定收敛速度、决定模型容量、决定泛化"几类,并讨论学习率这类旋钮的大影响与它们之间的耦合,为后面选搜索重点打好底。
学习目标
阅读完本节,你应当能够:
- 给常见超参数按其影响大小与作用对象分层。
- 说清为什么学习率通常最值得先调。
- 理解学习率与批大小、动量等的耦合,懂得"单因子变化"的重要性。
一、旋钮很多,但不是每个都值钱
超参数栏像一块巨大的飞控面板,几十个钮。但做过的人都会告诉你:不是每个钮都值得你去拧。调参的第一个动作,是先把面板按"影响大小"分个先后,把预算花在最管用的那几个上,而不是均匀撒。
二、按影响与作用分四档
超参数的四档影响力层级
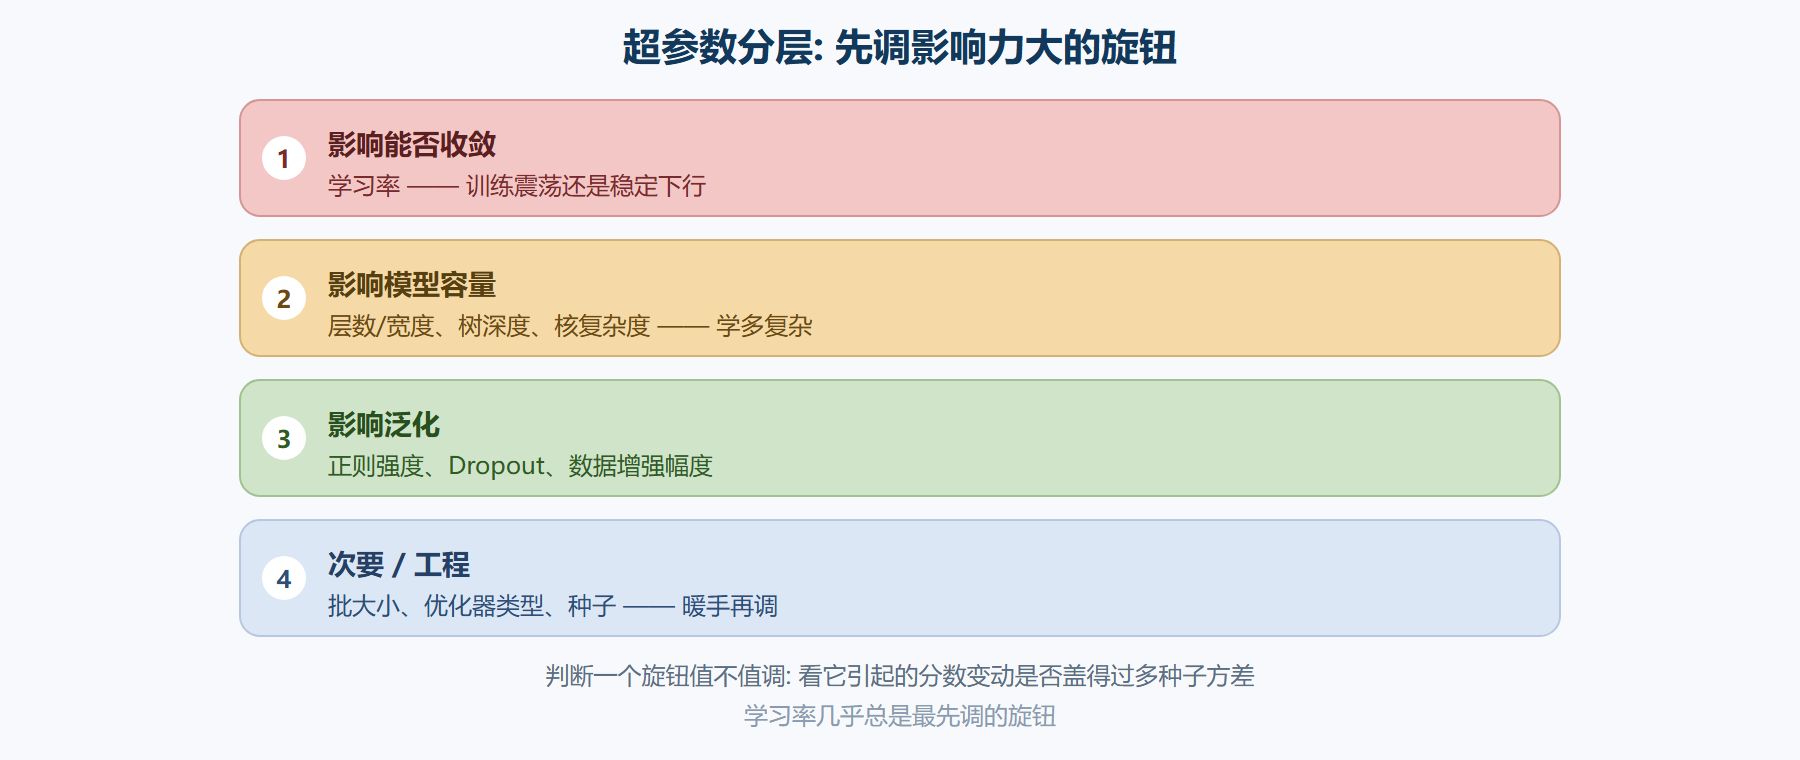
- 第一档:能否收敛 —— 学习率。它直接左右训练是专心下行、震荡还是发散。学习率没选对,剩下的都白搭,所以几乎永远先试它。
- 第二档:模型容量 —— 网络层数/宽度、树的深度、核的复杂度等。它们决定能学到多复杂的函数,直接连到欠/过拟合。
- 第三档:泛化 —— 正则强度、Dropout 概率、数据增强程度。它们几乎只影响"会不会过拟合"、对容量影响小。
- 第四档:次要/工程 —— 批大小(在预算允许时兼顾显存与梯度质量)、优化器类型、种子。它们有意义,但通常不值得在最前头耗。
三、学习率:值得最先花力气
原因很直接:它既是第一档最关键的,又和多数其他旋钮“共享舞台”。学习率太大,复杂模型直接发散,后面正则、容量什么都测不准;学习率太小,前几轮损失几乎不动,你以为欠拟合白忙一场。所以主流走法:先粗定学习率,确认收敛在健康下行,再谈容量与正则。
四、耦合:为什么“单因子变化”是纪律
超参数之间不是独立的。典型如:学习率与批大小(批变大可线性放大学习率)、学习率与动量(动量改变有效步长)、容量与正则(容量大需要更多正则)。一次实验只变一个旋钮、其余固定,正是为了不把"A改为B带来的提升"错算到"同时改的C"头上。
实验舱式的严谨做法:想同时试多个档位时,挑有限几组正交的组合,其余锁定成默认,否则你连"刚才到底是进步了还是噪声"都说不清(这也和第一把尺子的“信号要稳”咬合)。
⚠️ 常见坑:把"高等次的旋钮"和"低等次的旋钮"在同一轮实验里一起动,然后在日志里只记了最终分数——事后复盘时,你根本无法归因是哪个钮的功劳。记录上要能支撑归因。
💡 直觉:判断一个旋钮“值不值得调”,看它引起的验证分数变动幅度是否明显大于“多种子方差”。若连种子噪声都盖不过,说明它当前影响微小,不必在它身上烧预算。
五、每个模型,其实都有一张"旋钮地图"
与其泛泛列一堆超参数,不如学着给你手头的模型画一张专属的"旋钮地图":一条轴是"影响大小",另一条轴是"该在什么时候动"。以一台常见 GBDT 为例,学习率和树的深度几乎总是靠前、影响巨大,得先花力气;叶子最少样本、每棵子树采样比例属于"容量/泛化"的调节阀,分批处理;而随机种子、线程数这类工程项,几乎不必当作调参对象。换到神经网络,旋钮地图更宽:学习率、批量、块宽/层数靠前,激活、Dropout、优化器中间,随机种子垫底。画图的那一刻,你就把"先调什么、后调什么、根本不用调什么"一次性钉清楚了,这比背任何清单都更贴合你的具体任务,也是本章后面搜索策略落地的第一前提。
六、一次"只动一个"要动到多细才够
有人觉得"单因子变化"太慢、恨不得一次多动几个。这里给一个务实的节拍:放宽但可归因——你不需要每动一次就全量重训半天,但任何一次并行改动都必须"能说清是谁带来的提升或退步"。做法是分两钟粒度:先做粗粒度探界(几个关键旋钮各试 2-3 档,往往可以把搜索范围粗粗圈住),再做细粒度精修(围绕一个目标旋钮小幅扫描,其余锁定)。粗探谁都可以多动几个,细修期则严格一次一个。这样既不放弃"归因清晰"的底线,又不必把自己拖累到每步都要重训的极端。这一章后面的网格、随机、贝叶斯,本质上都是这套"先粗后细、以可归因为准绳"在不同预算下的自动化版本。
再多说一句关于"超参和验证信号"的关系,帮你把这一节和前面的尺子接上:只有当一个旋钮的敏感度明显大于验证信号的噪声,它才值得进入你的搜索空间。如果你用一个旋钮扫完了不同档位、验证分几乎没动,那它大概率要么暂时不重要、要么当前范围没踩到利害区——与其硬塞进搜索烧预算,不如先把范围放大或直接排除。先扫一遍"每个候选旋钮有多敏感",再决定"正式搜索放哪些",这个前置动作往往能显著提升搜索效率。把"灵敏度筛查"写进你的流程,超参调优就从"试运气"变成了"有目的地缩小不确定度"。
回到这一节最关键的一句话:调参的功力,一半在于知道哪些旋钮本来就该别去动它们。面板上几十个钮,真正值得你花预算的常就那么几个,把它们优先找出来、其他的当成默认锁好,你才不会把时间烧在"证明一个无关紧要的旋钮无关紧要"上。给"识别高影响旋钮"这件事足够的重视,它往往是新手与老手之间最直观的一道分水岭。带着"哪些钮值得先动"的名单进下一节,你才能把网格与随机的那点预算,花在最容易出结果的地方。也别忘了一条补充:这份"名单"会随模型的成熟而变,别当成一劳永逸的真理,偶尔回望更新一次。先用手筛出"值得搜的",再让机器去搜"那些值得搜的",往往就是最省力又最有效的分工起点。
本节要点回顾
- 要点一:超参数按影响分四档,学习率几乎总是最先调的旋钮。
- 要点二:容量类决定能学多复杂,正则类决定会不会过拟合,分工不同。
- 要点三:学习率与批大小、动量等耦合,先粗定学习率再谈其他。
- 要点四:单因子变化是纪律,避免把提升错归因到无关旋钮上。
- 要点五:判断旋钮值不值调,先看它是否盖得过种子噪声。
认清了旋钮,下一步就是用朴素的网格或随机把第一批实验铺开。