第六章 超参数调优策略
第六章 超参数调优策略
章节摘要:本章跟着一条线走——终于轮到大多数人最想看的:超参数到底怎么找。前面按"数据→模型→训练→泛化"铺了路,现在它去托起一个实验系统:先认清每个旋钮是什么、影响多大,再从朴素的全枚举到聪明的自适应搜索,最后用工具把实验记录管起来。
一条主线
主线是"把调参从碰运气变成有预算的搜索"。超参数组合的空间大得吓人,若你不知道哪些旋钮重要、不知道用什么策略去搜、也不知道怎么把每次实验记录下来复盘,只会越调越乱。我们把这条主线分成四步:认识旋钮、传统全搜/随机搜、聪明的自适应搜索、以及最终落到工具与实验记录。
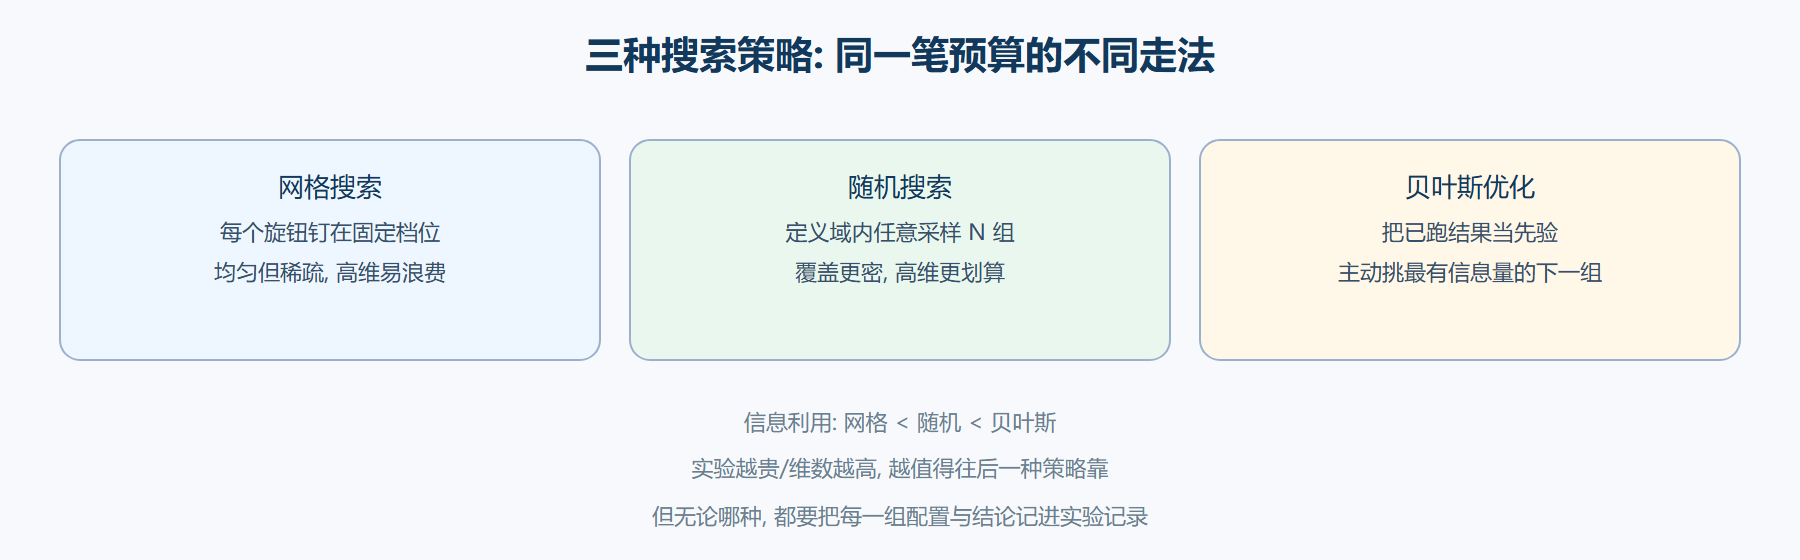
这里最值得先建立的直觉是**"预算感"**。假设你有六个超参数、每个试 10 个取值,全枚举就是 100 万次训练——在现实里根本跑不完。所以第六章教的不是"怎么试尽",而是"怎么用有限的预算买到最多的信息"。随机搜索在维度高时之所以胜出,是因为它的覆盖面更随机均匀;贝叶斯优化则是把已跑实验当成先验,主动挑"最有信息量"的下一组。两者本质都在回答同一个问题:给定 N 次训练预算,怎么选这 N 组参数最划算。
沿途站点
- 01 超参数类型与它们的影响:先给旋钮排队——哪些对结果影响最大(学习率、容量、正则强度),哪些是小角色;理解它们之间的耦合。
- 02 传统调优方法网格与随机搜索:全枚举与随机采样的对比,以及在维度升高时随机搜索为什么性价比高。
- 03 自动化调优技术贝叶斯与进化:让搜索"越搜越聪明"——贝叶斯优化用代理模型挑最有希望的下一组,进化类用遗传操作迭代,这是大数据/贵训练时省算力的关键。
- 04 调优工具与实验管理:把以上落到真正的工具与流程——怎么用框架做搜索、怎么记录每次实验、怎么让结果可复现可复盘。
同样一笔预算,三种走法
把四节串起来看,第六章其实只回答一个问题:给定 N 次训练预算,怎么选这 N 组参数最划算。网格、随机、贝叶斯本质上是三种不同的"花预算姿势",它们的差别全在"下一组往哪试"上:
拐点与结论
本章的认知转折:调参的瓶颈通常不是"试的不够多",而是"没有预算感与记录纪律"。随机搜索往往能在高维空间靠近随机网格的一道成本达到相近效果,而贝叶斯优化则把每一次训练结果的反馈变成下一组的方向。结论是"先小范围定范围、用合适的搜索粒度、把每一组都记下来",这是实验舱式调参的核心——把每组训练当成一次可被复盘的数据点,而不是孤立的碰运气。
读完你应该
- 说出 2-3 个对性能影响最大的超参数及其方向性.
- 解释为什么维度升高时随机搜索优于网格。
- 说清贝叶斯优化的代理模型与"下一组怎么挑"的机理。
- 给一组配置跑一个受控、可复现的搜索,并把过程记录下来复盘。
先帮你把期望值摆正:很多人以为"会调参 = 知道一组完美超参数",看完本章你应该反过来——会调参 = 能在给定算力预算下,用最少的训练次数逼近一组足够好的配置,并能让这个结果被复现和解释。所以重点不在记某组数字,而在掌握"范围怎么定、搜索策略怎么选、结果怎么验证"。你照着第三章起的每一章积累的"旋钮清单",到这里才第一次真正系统化地被组织起来,别忘了回头对照。
各站之间的"接力"
四站并不是四个井水不犯河水的独立小节,而是一条流水线:01 认识旋钮 → 02 用朴素法粗摸范围 → 03 用聪明法精修 → 04 用工具与记录把它固化。前两站解决"往哪试",后两站解决"怎么最省地试、且试完还能复现"。这条接力线想强调的是:调参能力不是一个"会按按钮"的操作,而是一套把"空间设计、搜索策略、评估稳定、结果记录"串起来的工程素养。
下一章的接力
超参在单机单卡上调好了,下一章把方案推到更高层次——迁移学习、知识蒸馏、剪枝量化、分布式,以及真实上线后更长期的概念漂移问题。