1.4 优化器与梯度下降的第一课
1.4 优化器与梯度下降的第一课
本节摘要:损失给出方向,优化器负责决定"沿这个方向走多大步"。本节把梯度下降从原始版本一路升级到 SGD、动量、RMSProp、Adam,讲清学习率、动量、自适应学习率各自解决什么问题,并给出选型节奏。
导航到 1.4,前面已经配齐了结构、非线性和量尺。现在要解决的是:"每走错一个方向,该把每个参数扳回去多少?"这个"扳多少、往哪扳"的执行者,就是优化器。它是本章四节里离第2章最近的一位——它要消费的指标,正是反向传播将要算出来的梯度。
光有方向还不够,还得决定走多大步
梯度告诉我们当前位置哪个方向让损失降得最快,但没说该走多远。走大了,可能跨过谷底在两侧震荡;走小了,训练磨磨蹭蹭几个月都不收敛。这个"一步多远"由两个量决定:梯度的方向,以及超参数"学习率"。最朴素的梯度下降,就是参数 = 参数 - 学习率 * 梯度,一步一个脚印地挪。
从全量到随机:把每次计算做轻
向整个数据集求一次梯度,几十万样本就得全跑一遍,太慢。优化器因此演了一出"降采样"的好戏:随机梯度下降(SGD)每次只取一小撮(一个 mini-batch)样本来估梯度,再用它更新。虽然每一步都有噪声、走的是"醉汉路径",但方向大体没错,关键是开销骤降,训练规模从此才撑得起来。噪声还有个额外红利——偶尔能把模型从鞍点、浅洼里摇出来,算是一种歪打正着的正则化。
动量:给下山加点惯性
噪声解决了速度,却带来震荡——一批样本把参数往东拽,下一批又往西拽。动量的思路很朴素:把历史更新方向也掺进来,让步伐"带着惯性"走。方向一致的路段,惯性越滚越大,快速通过;方向反复的路段,惯性互相抵消,步子稳住。它解决的是"方向总是抖"的病。常见的 momentum 超参约 0.9,意味着当前方向九分靠历史、一分靠当下。
自适应学习率:让每根参数各走各的
学习率如果对所有维度一视同仁,会出笑话:有的维度陡峭,同样一步跨得过大;有的维度平缓,同样一步走得嫌小。Adagrad 史无前例地按"该参数历史梯度的累计"给每个参数配单独学习率,平缓轴自然放大、陡峭轴自然缩小。但它有个毛病:累计值只涨不跌,越练步越棉,最后几乎停摆。RMSProp 用一个滑动平均代替永涨的累计,解决了"越走越僵"。Adam 则把动量的惯性思想和 RMSProp 的自适应幅度焊在一起,再配一个修正偏置的小技巧,收敛又快又稳,是今天最省心的默认选项。
一代代优化器各修了什么:一张演进时间线
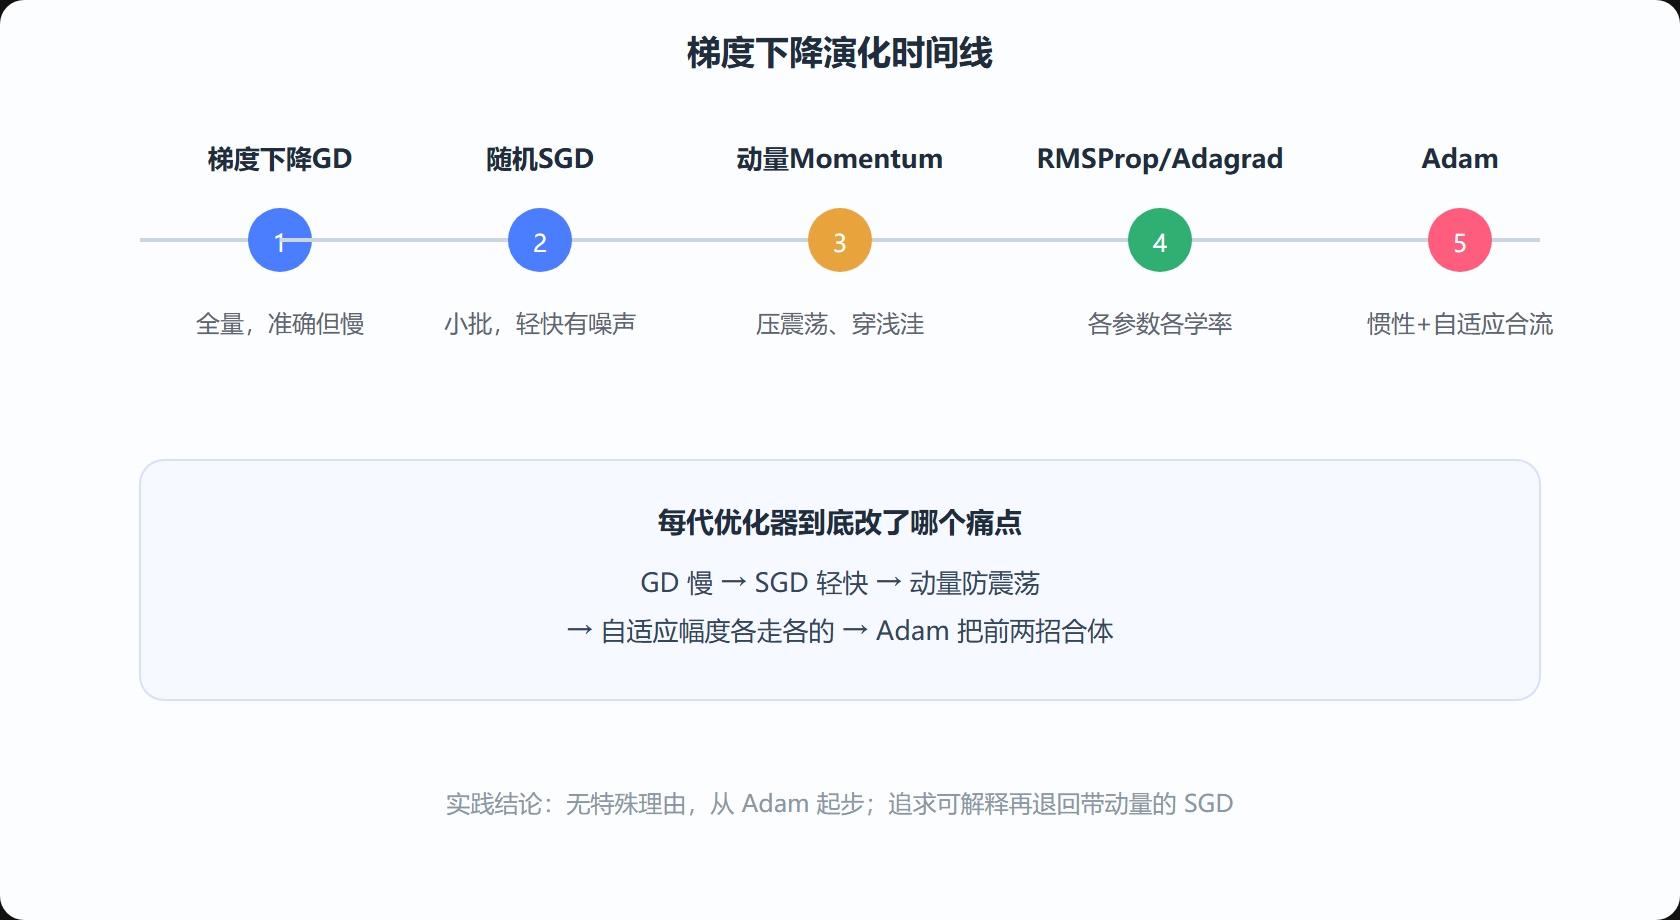
下面这张图把优化器的升级动因一条条串起来,每条对应一种曾经的痛点。
图 1-4 优化器演进时间线
用代码模拟三种步法在同一个碗里下山
把抽象落到实数上。用一个简单的二次型损失,分别用"固定步长""带动量""Adam 式自适应"去走前几步:
import math def mse_w(w): return (w - 2.5) ** 2 # 谷底在 w=2.5 def g(w): return 2 * (w - 2.5) # 损失对 w 的梯度 w1 = w2 = w3 = 0.0 lr, mu, eps = 0.1, 0.9, 1e-8 v, m, vw = 0.0, 0.0, 0.0 for _ in range(3): w1 -= lr * g(w1) # 朴素 v = mu * v - lr * g(w2); w2 += v # 动量 m = 0.9 * m + 0.1 * g(w3); vw = 0.9 * vw + 0.1 * g(w3)**2 w3 -= lr * (m / (math.sqrt(vw) + eps)) # 近似Adam print("朴素", round(w1,3), "| 动量", round(w2,3), "| 类Adam", round(w3,3))
三列都朝谷底 2.5 跑,但速度、稳度各不相同,你能亲眼看到配了惯性或自适应幅度后收敛更利索。
选型别只看名气
Adam 不是免死金牌:它有时收敛过快、对泛化不那么友好,且两个一阶二阶矩的指数衰减参数也需要留意。工程上稳妥的路径是:默认 Adam 起步,观察损失曲线;若发现过拟合或想微调得更细,可换回带动量、学习率调度配合的 SGD。而真实项目里,学习率的调度(热身、衰减)往往比换优化器本身更能改命——这部分到第2章 2.4 的超参数专题再展开。
学习率给多大,才不算"僵"或"疯"
选学习率是优化器落地前最先要面对的实际操练。给太大,损失曲线锯齿乱跳、数值可能直接爆成 NaN;给太小,曲线板成一条几乎水平的线,几个月看不到动静。工程上的诊断手段是盯损失曲线:若它抖动得像心电图,先砍学习率;若它一路缓到底皮都不动,多半是太小或者陷入了浅平区。常见做法是设一个"从小到大再到小"的扫描,找出曲线最陡、下降最快的那段对应的量级。
还有一层容易被忽略:学习率不是全程不变的。训练早期离谷底远,走大步快速逼近;接近谷底时该放慢,避免在最优解附近绕圈。于是有了各种调度——随时间衰减、按步数衰减,以及更平滑的余弦衰减。结合热身(第2章 2.4 会展开)的思路,图 1-4 那条时间线里每个优化器其实都在回答同一个问题:在"走得动"和"走得稳"之间,怎么给每一步配一个合适的步长。选型时把这条主线记住,就不会被一堆名词绕晕。
一个直觉对照
想象从山坡顶滚球下山:固定大步长像是给球绑了马达,坡度陡就一直冲、坡度平就没劲;动量像给球配了记忆,滚过的方向带着惯性滚顺了;自适应幅度像每根轴各有自己的弹簧,陡的轴自发减速、平的轴自发加速。想清楚这三个比喻,再看那三段模拟代码的输出的三列数字,收敛的快慢与稳定性差异就有了直观的着落。
优化器不是越新越好
还有个反直觉的点要说透:优化器的发展不是一条"新必替旧"的直线。老牌 SGD 在中大规模数据、尤其是过了瓶颈期之后,配合动量和恰当的学习率调度,常常能取得比 Adam 更漂亮的泛化;Adam 的优势在于开箱即用、调参少、前中段收敛快。所以业界那句"默认 Adam,深化看 SGD"其实是一句务实的选择,而不是对某一家信徒式的崇拜。选型的本质,是拿"调参的舒适度"换"最终精度的上限"——把这场交易的核心想明白,树的每个优化器都会自己跳出来应征。
优化器不是越新越好
还有个反直觉的点要说透:优化器的发展不是一条"新必替旧"的直线。老牌 SGD 在中大规模数据、尤其是过了瓶颈期之后,配合动量和恰当的学习率调度,常常能取得比 Adam 更漂亮的泛化;Adam 的优势在于开箱即用、调参少、前中段收敛快。所以业界那句"默认 Adam,深化看 SGD"其实是一句务实的选择,而不是对某一家信徒式的崇拜。选型的本质,是拿"调参的舒适度"换"最终精度的上限"——把这场交易的核心想明白,树的每个优化器都会自己跳出来应征。
本节要点回顾
- 学习率决定一步多远,太大震荡、太小磨蹭
- SGD 用 mini-batch 换速度,噪声反而带来一点正则化
- 动量压震荡、穿浅洼,靠的是历史方向的惯性
- RMSProp/Adagrad 给每个参数单独学习率,解决"坡度不一"
- Adam = 动量 + 自适应 + 偏置修正,是当前最省力的默认项