- 文集信息
- 目录大纲
- 最新文档
- 知识宇宙
文集详情
文集导读
教程导读:跟着梯度走一趟神经网络
想象你站在一座不上不下的山坡上,看不清全局,只知道脚下哪边更低。每一步,你都往更低的方向迈一小步,走多了自然到了谷底。神经网络训练就是这么回事——但比你多一个麻烦:它要让几百万个参数一起往该去的方向走,而算清"谁该动多少"这件事,靠的是让误差从输出端一路倒着爬回输入端的梯度。这本书的主线,就是顺着这股"逆行"的梯度,把深度学习里的主流算法一件件拆开、装回去。
这本书到底讲什么
市面上的深度学习教程多半按"模型清单"罗列:CNN 是这样、RNN 那样、Transformer 又是第三种。读完之后,公式背了一堆,回到自己的项目却不知道什么时候该用哪个。这本书换个路子——把对象从"模型"挪到学习本身:一个网络到底是靠什么学起来的?答案是反向传播:前向把输入变成预测,反向把误差折算成每个参数的修正量,如此循环往返。于是每一种模型都不再是孤立风景,而成了台子上解决特定问题的同一件工具的演化产物:CNN 为了让梯度在空间上复用得更省,RNN 为了让梯度穿越更长的时序,Transformer 干脆让梯度一步跨到任意远的距离。
哪类人值得读
写过哪怕一个模型的实践者,想搞懂训练为何卡住、性能为何上不去;刚入门、被"梯度消失、过拟合、学习率"这些词劝退的新手;以及想给团队写一份能讲清楚"算法为什么长这样"的技术文档的人。我把门槛放低:不要求你把微积分推导完完整整背下来,只要有偏高中的函数与求导直觉,能顺着例子一步步按计算器,就足够。
读完你会得到什么
- 能手算一个小网络的一次前向与一次反向,讲清误差怎么"分摊"到每个权重
- 用"梯度健不健康"这把尺,解释激活函数、学习率、正则化的种种选择
- 分清 CNN、RNN、Transformer 各自在解决哪一类梯度或结构难题,并据此选型
- 对 GAN、VAE、扩散、强化、图网络这些前沿,不再只有名词,而是知道它们各自站在主线的哪一站
学习路线与知识地图
书里七章是一条自底向上的链:先有神经元和一次前向(第1章),再有反向传播这个引擎(第2章),然后把引擎装进三种主要骨架——卷积(第3章)、循环(第4章)、注意力(第5章),接着看引擎如何驱赶更前沿的学习范式和生成模型(第6章),最后收在怎么把模型送上线并且用得负责任(第7章)。下图就是这套依赖关系的地图。
图 00-1 全册知识地图:七章如何立在反向传播这台引擎上
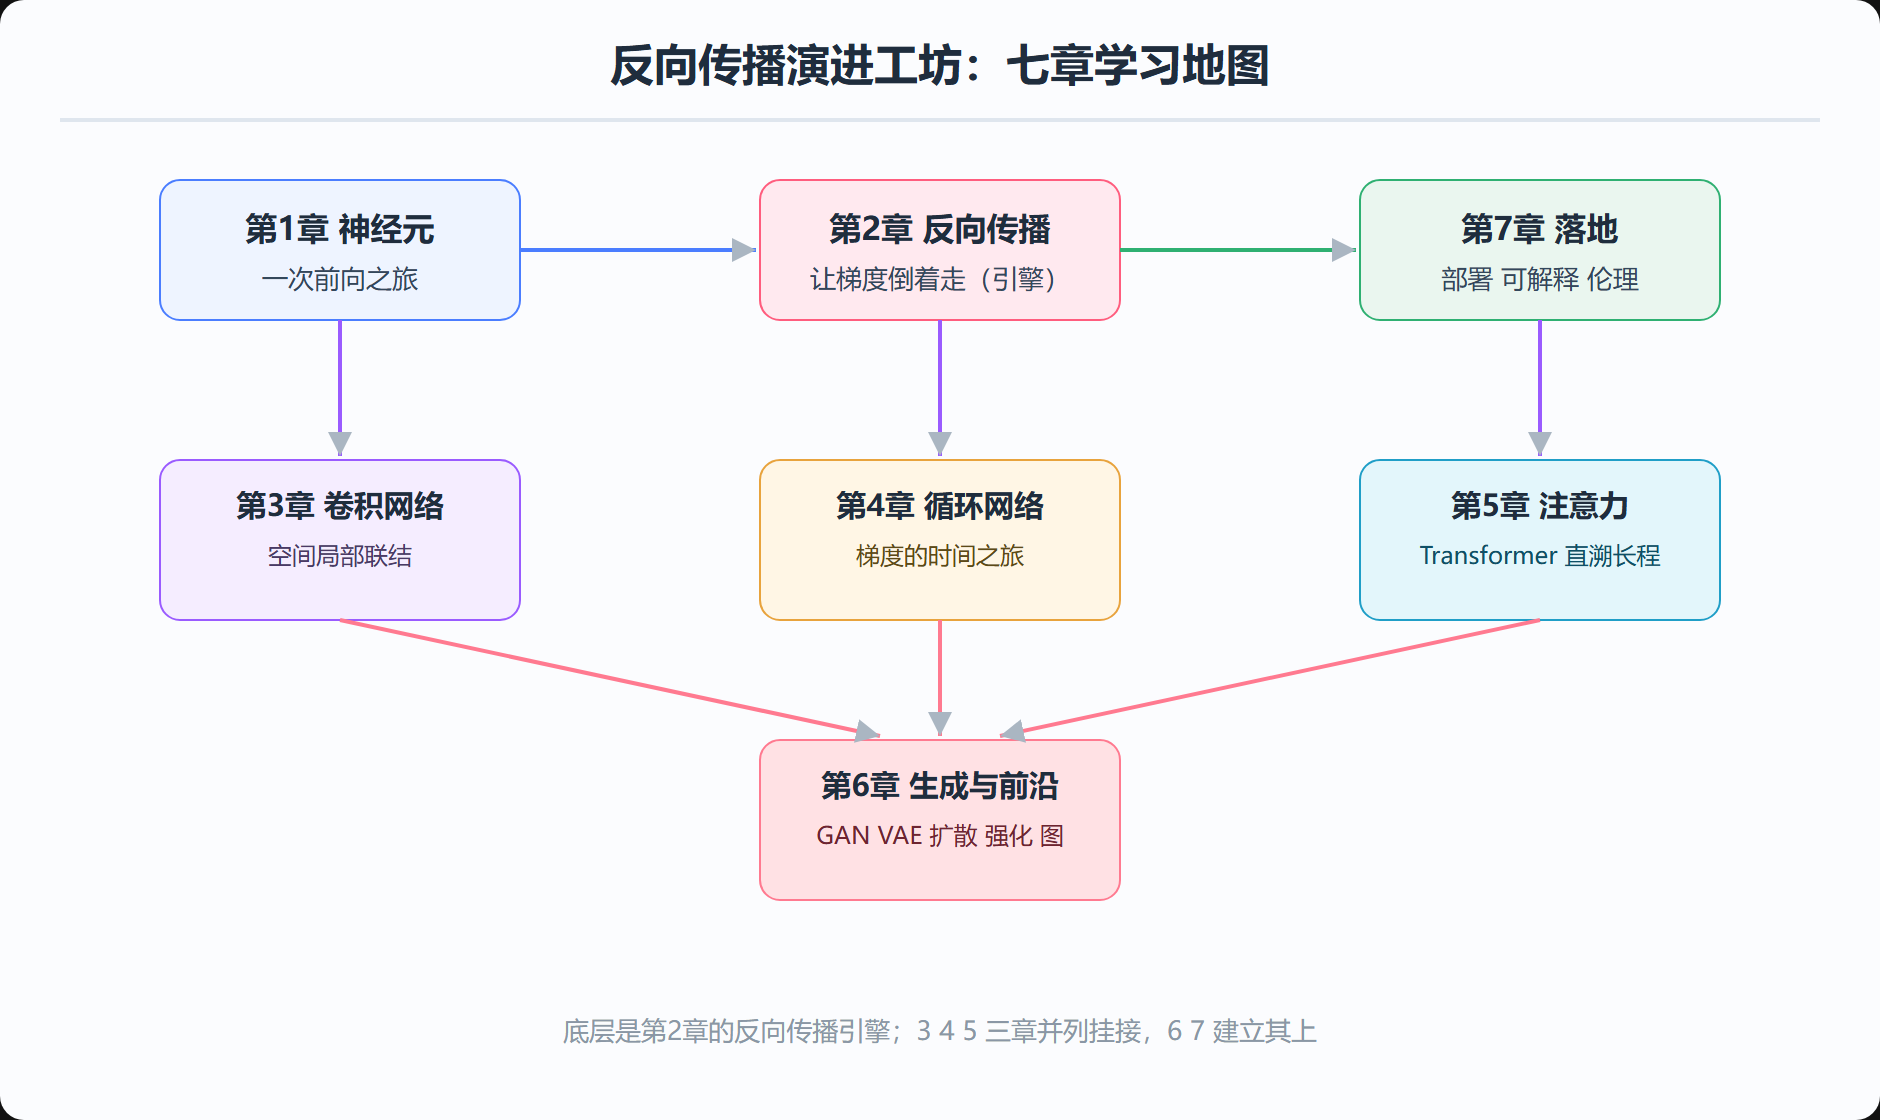
依赖逻辑一句话:第2章的反向传播是发动机,其余五章是挂在这台发动机上的不同车厢。第4、5两章都可以先于第3章读,但它俩共同依赖第2章的梯度直觉;第6、7章建在它们之上。
怎么用这本教程
顺序读最省力,每一章都和上一章有接口。第2章是全书的钥匙,哪怕时间紧也请把 2.1 那一节的反向传播手算过一遍——后面的池化、门控、注意力,说穿了都没离开这一盏卡。第3到5章可按兴趣换顺序。第6、7章信息密度高,适合当作"前沿索引"随用随查。每节的演练小例子都尽量短到能在本地敲完,我不建议跳着只看结论——梯度这种事,不亲手算一遍,永远只见其表不见其里。
读之前最好知道的几点
这本书可以当作第一本深度学习入门书,但若连神经元、激活函数这些词都没见过,建议先花半小时翻一遍第1章。书里会有少量公式,我会尽量先给直觉、再给形式,能跳过证明的绝不满铺。还有一个心态上的提醒:别被"深度学习等于黑盒"这句老话劝退。等你看着误差在每一个权重上的份额一点点算出来,黑盒自然透亮了——这正是全册把"反向传播演进"当主线的原因。
目录大纲
最新文档
知识宇宙
正在加载知识图谱...