2.1 反向传播:链式法则一盏卡算到底
2.1 反向传播:链式法则一盏卡算到底
本节摘要:反向传播是全书的主引擎——它用链式法则把总误差拆解成每个权重的"责任份额"。本节从一个线性小网开始,手把手把前向、反向、更新三步算完,再延伸到一个隐藏层,最后用代码复现并逐步核对。
从导读开始就反复提"梯度要倒着走",本节终于把它落到纸面上。它的位置承接 1.4:优化器说"我要每个参数的梯度",而反向传播正是那个一趟回来就发完所有梯度的引擎。这一节是全书最不能跳的一节——后面的残差、门控、注意力,全都是这台引擎的改良。
误差是一笔账,必须有人来分摊
要训练一个网络,本质是处理一桩"责任纠纷":输出端错了,到底该怪哪个权重?一件事看着简单——把总误差照所有权重的影响大小分掉,大的多认、小的少认。问题在于影响大小不是一眼看得到的,中间隔着一层层加权和与激活。反向传播的整套动作,就是用链式法则,把这个"责任份额"从输出端一路折算回每个权重。
链式法则用一句话记:如果总损失 L 经过中间量 y 才与参数 w 挂钩,那么 L 对 w 的变化率,等于"L 对 y 的变化率"乘上"y 对 w 的变化率"。两段相乘,就把误差顺着依赖链送回去了。
先拿只有一条线的小网立规矩
太久不碰导数的读者别慌,我们从没有激活、只有一个权重的最简情形切进去。设真实目标 t=1.5,输入 x=2,权重 w=0.5,模型输出 y=w x = 0.5 乘 2 = 1.0,用平方差当损失:L=(y-t)²=(1.0-1.5)²=0.25。
现在问:这一丢丢误差该由 w 怎么分担?
第一步,算"输出有多错":L 对 y 的导数=2(y-t)=2*(−0.5)=−1.0。它表示 y 若稍微大一点,损失会降多少。
第二步,算"y 怎么随 w 变":y=w x,所以 y 对 w 的导数等于 x=2。
第三步,把这两段相乘得链式结果:L 对 w 的导数 = (−1.0)*2 = −2.0。
最后更新:w 新 = w − 学习率 * 梯度 = 0.5 − 0.1*(−2.0)=0.7。梯度是负的,说明往大调刚好降损失。模型从预测 1.0 挪向 1.4,离目标 1.5 更近了。
这套"求局部导数 → 相乘回传 → 按梯度更新"的流水,就是反向传播的骨架,网再深也只是把它在每一层重复多编几次。
一层隐藏层:把链条多接几段
把上面这套接到第1章的多层感知机上。隐藏神经元先做加权和 Z1,再过激活得到 A1,输出层再过一遍到 y,于是出现了更长的链:L 影响 y,y 影响输出层的权重 v,也通过 A1 影响隐藏层的权重 W。反向传播从后往前逐段解链:先拿到 L 对 y 的偏导数,它既直接生出输出权重的梯度,又作为"误差信号"继续往下游流,去算出 L 对 A1、再对 W 的梯度。这段"误差信号一层层往回淌"的过程,就是图里那条与箭头相反的回路。
图 2-1 前向推值、反向回传误差信号的计算图
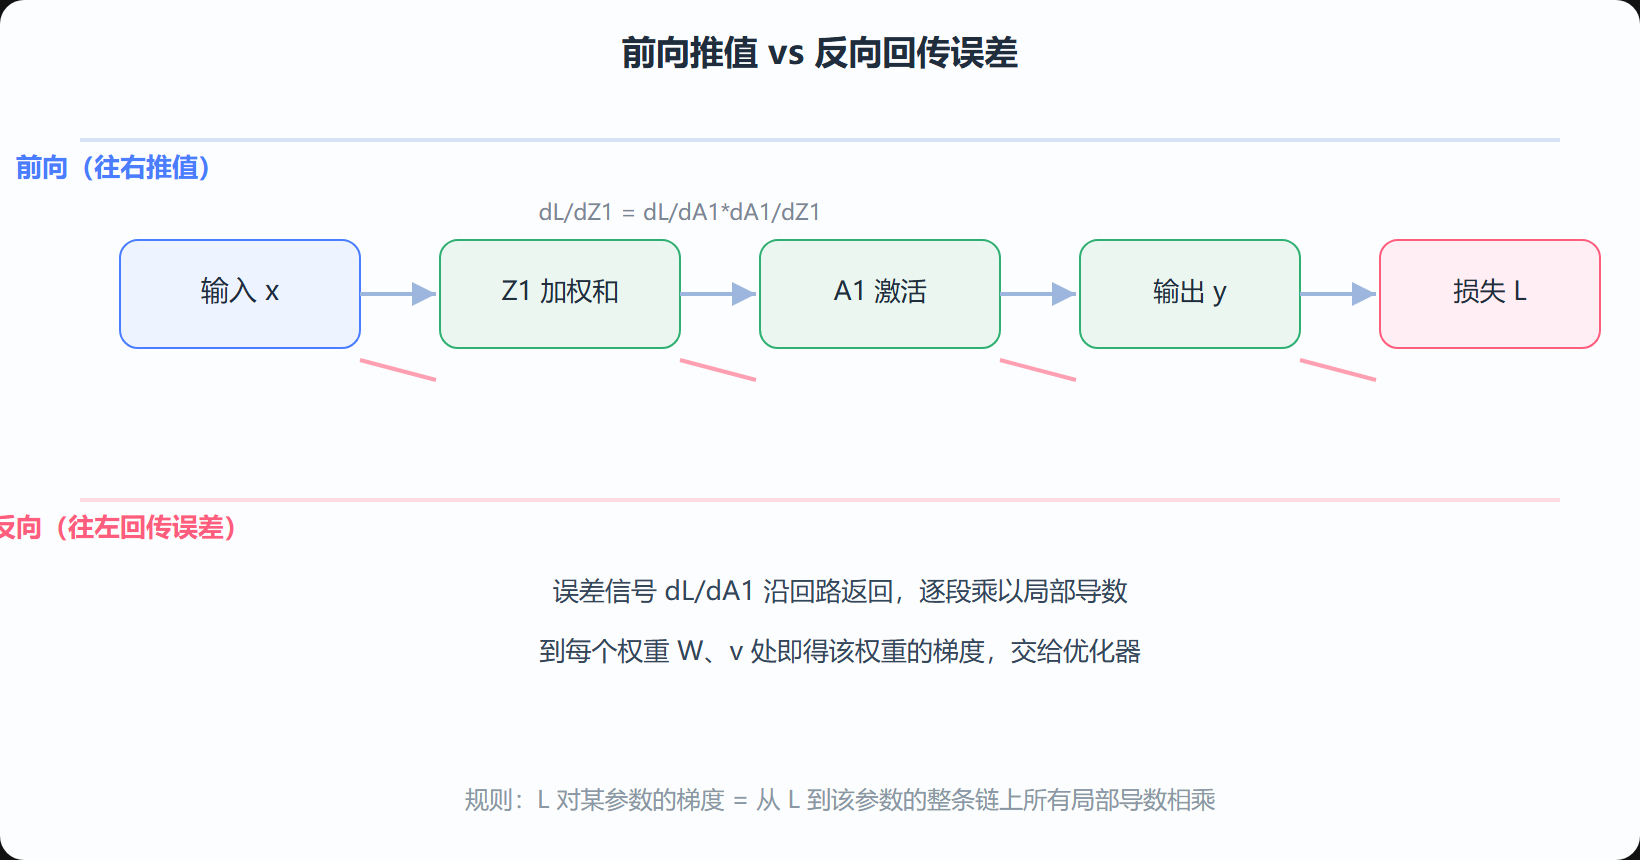
黄金规则写在图底:某参数的梯度 = 从损失到该参数的整条链上所有局部导数相乘。这句话换个说法就是"责任按链条份额分摊",是整个反向传播的灵魂。
用代码把更新量亲手算出来
写代码的好处是你能把每一步的中间数打出来核对。先算最简线性小网:
x, w, b, t, lr = 2.0, 0.5, 0.0, 1.5, 0.1 y = w * x + b L = (y - t) ** 2 dL_dy = 2 * (y - t) # 输出端的误差信号 dy_dw = x # 局部导数 dL_dw = dL_dy * dy_dw # 链式相乘 w_new = w - lr * dL_dw print("y=", y, "L=", L, "dL_dw=", dL_dw, "w_new=", w_new)
再扩展到一个带隐藏层、全用链式法则手推的反向实现,把"误差从输出回传到 W"也打印出来:
import numpy as np def sigmoid(x): return 1/(1+np.exp(-x)) x = np.array([1.0, 0.0]); t = np.array([0.7]) W = np.array([[0.9, 0.2], [-0.3, 0.4]]); b1 = np.array([0.1, -0.2]) v = np.array([0.6, 0.3]); b2 = 0.0 Z1 = W.dot(x) + b1; A1 = sigmoid(Z1) y = v.dot(A1) + b2; L = (y - t[0]) ** 2 dL_dy = 2 * (y - t[0]) dL_dv = dL_dy * A1 # 输出权重梯度 dL_dA1 = dL_dy * v # 误差继续回传到 A1 dA1_dZ1 = A1 * (1 - A1) # sigmoid 局部导数 dL_dZ1 = dL_dA1 * dA1_dZ1 dL_dW = np.outer(dL_dZ1, x) # 隐藏权重梯度(外积) print("A1=", A1, "\ny=", round(y,4), "L=", round(L,4)) print("dL_dv=", dL_dv, "\ndL_dW=\n", dL_dW)
输出里的 dL_dW 每个元素,就是训练第一阶段要发给优化器那张"责任清单",下一步它们与学习率结合,把 W 和 v 各往下降损失的方向推一点。
反向传播和"黑盒"其实没关系
很多人把深度学习叫黑盒,其实看看上面这些数就知道:每一层的梯度都是清清楚楚按规则相乘出来的。所谓黑,只是因为参数太多、链条太长,人算不过来,而不是原理暗箱。理解到这一层,后续所有"为了让梯度更顺"的结构(残差、门控、注意力)你都能看出它们到底在动链式法则的哪一段。
那张"责任清单"该怎么核对
跑完上面第二段代码,你会得到两样东西:y 和 L(前向的结果),以及 dL_dv、dL_dW(反向的梯度)。怎么判断这些数对不对,而不是代码写岔了?最踏实的办法是数值差分硬核对:把某个权重手动改一点点(比如在 W[0,0] 上加一个很小数),重新跑一次前向,看损失变化量除以扰动是否约等于梯度里对应那一格。两者应当高度接近。这种做法叫数值梯度校验,很多深度学习框架在开发者自检时就是靠它。
它还有个附带的地图作用:让你看出一层层的误差信号在量级上如何衰减或放大。把 dL_dv 和 dL_dW 两个数组并排打印,你会观察到越靠近输出端的权重梯度往往越大、越往输入端的越小——这正是第4章要讲梯度消失的最初端倪。现在先记住这个现象即可,后面会专门拿着放大镜来看它。
一句口诀防止链扣错
只要记住"先求局部导数、再按顺序相乘、最后交给优化器",反向传播就不会迷路。网越深,只是链上多些环节,骨架不变——这也是为什么 2.1 之后,后面每一章谈的各种结构,你都能往回找到"它在链式法则的哪一段做了手脚"。
本节要点回顾
- 反向传播 = 链式法则,把误差按依赖链拆成每个权重的份额
- 三段式:前向推值 → 反向求局部导数相乘 → 优化器按梯度更新
- 黄金规则:某参数梯度 = 损失到这参数的整条链上所有局部导数之积
- 输出端误差信号会一路回传,是每一个"责任份额"的源头
- 原理非常透明,黑只是在规模,不在机制