2.3 正则化:L1、L2 与 Dropout
2.3 正则化:L1、L2 与 Dropout
本节摘要:上一节说要治"只会背题",本节给三味药——L1、L2 和 Dropout。L2 拴住参数大小、L1 逼出稀疏、Dropout 练一支更抗打的隐队长,各自机理与代价都讲清楚。
承接 2.2 说的"参数太自由就要上保险",本节把保险单打开。正则化的大方向就一句话:在损失里加一道"约束的审判",让网络不敢把参数凹到只贴训练集的形状。三种配方分别从"参数大小""参数稀疏""参数协作"三个角度下手。
给损失账本上再加一行罚款
思路第一招很直白——在原有损失上加一笔"参数罚款",让"把参数调大去贴噪声"变成得不偿失。正则化项看的是权重本身的模样,训练越用力,这笔罚款涨得越凶,模型就学会克制。选哪种"罚款计价",就分出 L1 和 L2 的差别。
L2:让权重悄悄缩水
L2 的罚款按"权重的平方和"计价。它对大权重特别敏感——某个权重一大,罚款平方级飙升,于是它鼓励把所有权重压到较小、较均匀的水平,不许个别参数孤军猛进。惩罚项进了梯度之后,每次更新会自动给权重乘一个小一点的衰减系数,相当于"每步都放一点血",权重很难长胖。它从不逼任何参数归零,只要求人人安分。
L1:把不重要的参数清零
L1 改用权重的绝对值之和计价。它有个 L2 没有的暴脾气:对接近零的权重,它的"罚款坡度"恒定为 1,不像 L2 那样越接近零点越迟钝。结果就是 L1 不但压下幅度,还逼一部分权重彻底变零,留下一个稀疏的权重矩阵。稀疏的好处是"选特征"——一堆输入里哪些是无用废话,直接被清了退出代价。代价是损失面在零点处不光滑,优化时多几分崎岖感。
图 2-2 L1 与 L2 惩罚几何:谁舍得把权重清零
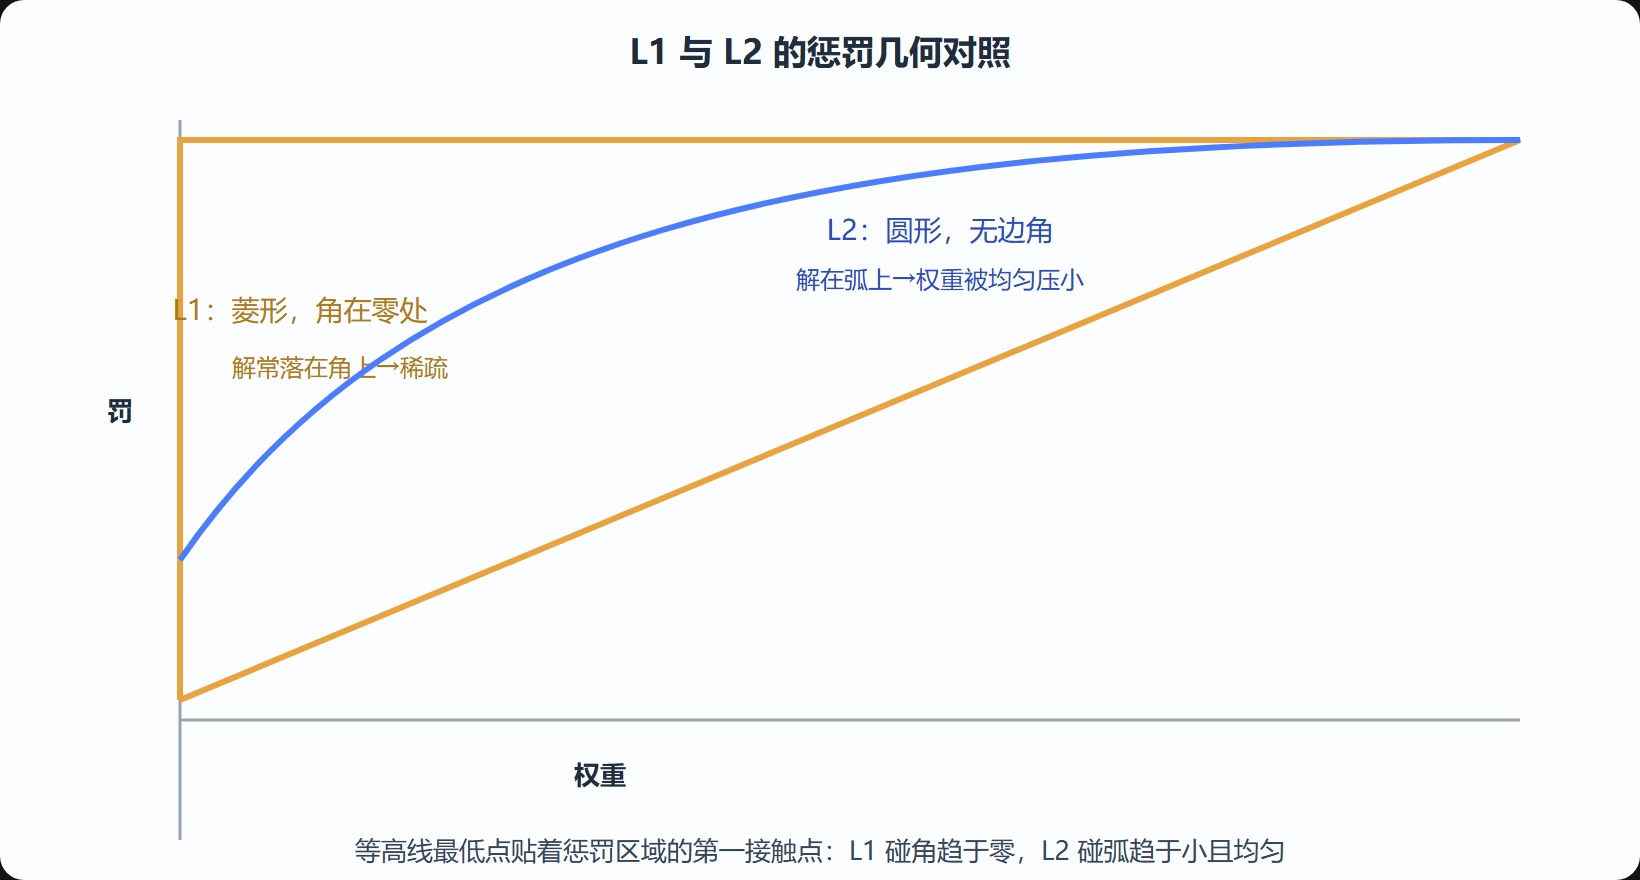
图中 L1 的惩罚区是个菱形、角正好杵在零点上,故最优点常落到"权重=0"的角上;L2 的惩罚区是个光滑圆盘,最优点落在弧上,把权重压小但留条命。这一个小小的几何差别,决定了"稀疏"还是"均匀"。
Dropout:练一支不会单点依赖的队伍
想在推理时不抱一根大腿,L1/L2 做不到这点——它们只管参数幅度,不管参数之间的协作依赖。Dropout 的招更刁钻:训练时每一轮随机把一部分神经元"拉下不上场"(按伯努利概率置零),逼网络学会在没有固定帮手的情况下也能自己完成任务。这样每个神经元都不能指望别人常驻,得各自练出真本事;到最后推理时,爪子全放下来,整合起来反而更稳。它常被比作"绕路让人多练几路回家"——换个说法是给网络看很多条阉割版的地图,逼它记住主干而非某个局部捷径。
工程关键点是训练和推理要"对账":训练时按概率丢弃,推理时不丢但要把权重按保留概率缩放(或反向,训练时放大),否则两阶段数值不一致,推理效果会莫名变差。
用一小段代码体会 L1 与 L2 的两步更新差异:
import numpy as np w = np.array([1.2, 0.05, -2.3, 0.0]) grad = np.array([0.2, 0.5, 0.1, 0.3]) lr, lam = 0.1, 0.1 w_l2 = w - lr * grad - lr * lam * w # 多扣一项平方罚的梯度 w_l1 = w - lr * grad - lr * lam * np.sign(w) # 多扣一项绝对值罚的梯度 print("L2后:", np.round(w_l2,3)) print("L1后:", np.round(w_l1,3))
留意 L1 那列里原本是 0.0 的第四个权重:L1 的符号罚把它留在零,而 L2 只是把它轻轻推向更小——一个清进,一个劝小,分道扬镳就在这一步。
正则化不是万能,也不该全上
正则化要配得上"病"。欠拟合时硬加正则化只会雪上加霜;参数本来不多也别乱上 Dropout。现实中更推荐的一个顺序是:先确认数据够、容量合理、训练充分,再一步步对症上保险,而不是一上来把 L1、L2、Dropout 全塞进去看疗效。真拿不准时,L2(权值衰减)和 Dropout 的组合是最常见且稳妥的起步配方。
权重衰减、Dropout 与归一化的配合
正则讲究组合,不靠单打独斗。L2(工程里常写成"权重衰减 weight decay")和 Dropout 是黄金挡配,因为一条栓参数大小、一条破协作依赖,互补不冲突。但要注意和归一化联动:像第1章 1.2 说的,激活、初始化、学习率、归一化本就在同一盘棋里,加了 Dropout 往往要给后面的层搭配当的激活与初始化,避免"一边丢神经元、一边又堆在某个尺度上"的别扭。真拿不准时,别一次全上,每个变量单独加回去、盯着验证集看,比一把梭后看个寂寞更靠谱。
一段直觉对照
把网络想象成一家分工明确的餐厅:L2 像给每位员工定了"工作量上限",谁都别太拔尖盖过队伍;L1 像把没必要的岗位直接裁掉,砍到最精简;Dropout 像每班随机抽掉几位员工练习顶岗,逼所有人都会干别人的活,真到全员到齐时反而更稳。三层比喻对齐后,你会看出三种药治的根本不是同一个病——这也是为什么通常不建议三个一起狂上。
三种约束各治哪种病
你可能想问:这三种药到底各治哪种病。答案并不挤在一起——当你发现权重普遍偏大、个别参数在孤军奋战时,L2 是首选,它均匀地把大家按回合适的量级、最通用也最不容易出错;当你明确知道有大量输入特征是噪声、想顺手做筛选时,L1 更合适,它会把没用的输入直接清零、交给你一份稀疏模型;而当网络深到神经元之间"抱团作弊"、单点依赖严重时,光靠 L1/L2 拧不动,得让 Dropout 上,它专门破的是"协作依赖"这种结构病。三种药治的不是同一个部位,这再次印证了"别把三道保险一股脑全上"。
实战里还有个常见误区:往损失里加一坨正则项,就以为高枕无忧。其实正则化的强度(那只放血的系数)本身也要调——太小等于白加,太大模型被约束得学不动、欠拟合又回来。工程里通常把强度当作一个超参数去扫描,配合 2.4 的超参数调优一起做。而且记住:正则治的是"参数太自由导致的过拟合",如果病根在"数据太脏、标签错得离谱",再强的正则也救不回来。所以正确姿势,是先把数据、容量、训练三项体检做完,再开正则这味药。
本节要点回顾
- 正则化 = 在损失上加约束审判,让网络不敢贴死训练集
- L2 均匀压小权重,从不归零,通用第一选
- L1 逼出稀疏,顺手做了特征筛选,代价是零点不光滑
- Dropout 打破单点依赖,训练置零、推理要按概率对账
- 对症下药,别把三道保险一股脑全上