1.2 为什么需要版本控制
1.2 为什么需要版本控制
本节摘要:没有版本控制的开发是场混战:手动复制命名管理版本、多人改同一文件互相覆盖、出 bug 无法追溯、硬盘损坏全盘皆输、想试新方案又怕毁掉主线。本节把七个具体困境逐一摆开,再对应对应解法,说明版本控制不是"锦上添花",而是"没有它,软件工程的复杂度迟早压垮你"。
本节目标
阅读完本节,你应当能够:
- 列举没有版本控制时团队开发会遭遇的至少五个具体困境。
- 解释版本控制如何解决"无声覆盖"与"无法追溯"两大协作痛点。
- 说明分支能力为什么是"大胆实验"的前提条件。
- 从发布管理与审计角度理解版本控制的非编码价值。
一、问题与直觉
先做一个思想实验:把你电脑里的一个项目目录,交给五个从来没听说过版本控制的人一起维护一周。不用真的做,光想象结局——大概率是下面这样的混乱叠加:
第一个来的人改了配置文件,存了一份"备份"到桌面;第二个来的人在他改过的文件上继续改,覆盖了第一人的成果;第三个人删了某个模块,因为"我觉得没用";第四个人想加个新功能,又不敢大改,只好在旧代码旁边堆一堆注释掉的死代码;第五个人在周五下午把整个目录拷走了一份,说"我回家继续做"。
一周后这个目录还能编译,就是奇迹。这不是夸张,这是上世纪九十年代真实开发团队的日常,也是集中式版本控制系统诞生的土壤。
问题不在人的恶意,而在结构:没有记录变化、没有隔离并行、没有回溯手段,多人的改动在同一个文件系统里只能互相倾轧。规模小还能靠默契硬扛,一旦代码量上来、参与的人多起来,靠人肉协调必然是崩溃结局。
数据在丢失之前,先崩的是信任
还有一个常被低估的代价:版本缺失会磨损团队之间的信任。当"不知道谁改了配置"成为常态,成员会开始互相猜疑,甚至发展出"我改完就立刻复制一份备份到网盘"的自保行为——每个成员都背着私人的"影子版本库",团队的协作反而更乱。版本控制的价值之一,是让所有改动透明可见:谁改了什么,全在记录里,不需要猜。信任不是版本控制直接给的,但它给透明,透明养信任。
"我没遇到这些坑"为什么不能说明问题?
有些单人开发者会说:我从来没被覆盖过、没丢过文件,是不是不需要版本控制?这个反驳有个盲点:没遇到不代表不会遇到,只是风险还没兑现。硬盘故障平均多久一次、误删多久一次,这些都是概率事件。版本控制在这里的角色是保险——你在没出事的时候为它付成本,换来出事时的免灾。而且单人开发更该考虑的不是"覆盖",而是"回滚":你的实验改崩了,有版本控制就能秒回,没有就只能靠手改回来——后者在复杂改动下几乎等于重写。
二、核心原理
把"没有版本控制"的困境逐个拆开,每一个困境都对应 VCS 的一项能力:
困境一:手动管理版本混乱。 用复制粘贴建副本,文件名变成 document_final_v2_真的_别动.doc。VCS 的解法是自动化记录:每次提交自动生成版本,命名由系统管理,版本之间关系清晰。
困境二:多人协作互相覆盖。 A、B 同时改一个文件,后保存的人静默覆盖前一人。VCS 的解法是检出/提交模型:改动不是直接写进共享区,而是先提交到各自的分支,再用合并机制整合,覆盖变成了可控的合并操作。
困境三:无法追溯问题。 程序出了 bug,不知道是哪个修改引入的。VCS 提供完整历史链和差异比较,能按文件、按提交、按作者过滤,把嫌疑范围一步步缩小。
困境四:工作丢失风险。 文件损坏、误删、硬盘故障,一切归零。VCS 的仓库本身是多份历史备份——尤其在分布式系统里,每个开发者的本地都是完整备份。
困境五:分支开发困难。 想试新方案,又怕动主线。VCS 的分支让实验在隔离线上进行,成功就合并,失败就丢弃,主线毫发无损。
困境六:发布与版本管理混乱。 不知道线上跑的是哪个版本。VCS 配合标签(Tag)能力,给每个发布点打永久标记,回滚到某个发布版本是秒级操作。
困境七:审计与理解缺失。 想搞清某段代码为什么这么写,无人可问。VCS 的记录链回答"谁、何时、为什么改了这一行",配合规范提交信息,等于给项目保留了一本编年史。
七个困境和七项解法不是平行的,它们的底层其实是同一件事:把"状态"变成"历史"。没有版本控制,项目只有一个"当前状态",过去的一切都靠记忆;有了版本控制,每一个时刻都变成了可访问的坐标。
一个真实的对比场景
假设你正在维护一个上线了三年的 web 应用。用两个世界推演同一件事:
没有版本控制的世界。 线上出了个诡异的 bug,只在某个老用户的浏览器里出现。你只能翻本地的代码猜测,改了一版发上去,用户说"还是不行",你再改。一来一回耗掉两天,你甚至说不清这三天到底改过哪几行——因为压根没有记录。
有版本控制的世界。 你先用历史命令查一下最近一周的提交,很快锁定某个提交的改动涉及了浏览器兼容性,再用差异对比确认它改了什么,最后回退或修复它,发个补丁。全程可能不到两小时。
差别不在智力,而在有没有"可查的记录"。版本控制提供的不是能力加成,而是把排查路径从"凭记忆"换成"查记录"——后者在复杂度上升时不会随项目变大而失效,这是它作为基础设施的底气。
图 1-2 有版本控制与没有版本控制的差别
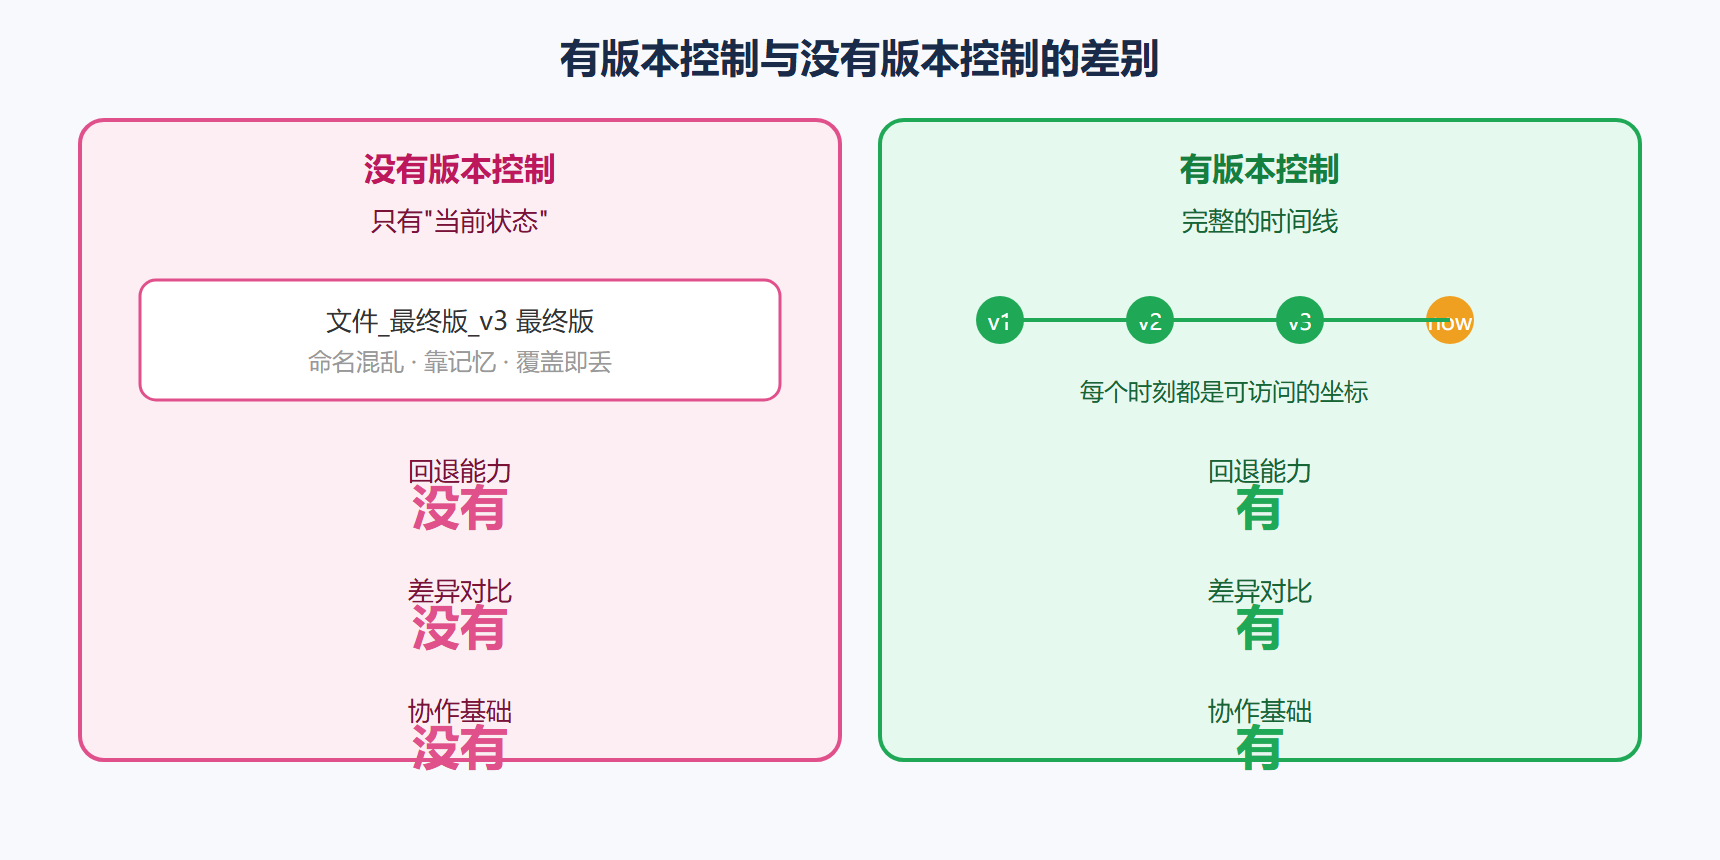
七条线最终收束到同一句:版本控制把"项目当前长什么样"升级为"项目如何一步步变成现在这样"。
三、工程实践要点
理解"为什么需要"之后,落地时的优先级很重要。很多人一上来就追求高级功能,反而忽视了最基础的几个动作:
| 实践 | 优先级 | 理由 |
|---|---|---|
| 频繁提交,粒度贴合工作节奏 | 最高 | 历史粒度直接决定你回滚的精度 |
| 写有意义的提交信息 | 高 | 让历史可读,是审计与追溯的基础 |
| 及时备份并推到远程 | 高 | 本地再完整,硬盘坏了也白搭 |
| 用分支做实验 | 中 | 单人项目也需要,但可后学 |
| 用标签标记发布 | 中 | 发布频率低时不必着急 |
| 用 Hook 自动化检查 | 低 | 团队规范到位后再引入 |
一个常见的认知误区:以为"版本控制 = 团队协作工具"。实际上单人的价值同样巨大——你的历史、你的实验、你的回滚能力,都不需要第二个人在场。团队协作只是版本控制价值的放大器,不是起点。
选择与代价
版本控制不是免费的,它也有成本,诚实地讲清楚,你才能判断值不值得:
- 学习成本:概念和命令需要时间,前一两周会明显拖慢你的"无脑操作"。
- 习惯成本:从"改完就存"到"改完要 add、commit、写信息",流程上多几步,初期容易觉得繁琐。
- 团队规范成本:多人协作时,提交粒度、信息格式、分支策略都需要约定,约定本身要花沟通成本。
这些成本是真实存在的,但边际递减:一旦成为习惯,几乎感觉不到。而它换来的收益——可回滚、可追溯、可并行——在项目生命周期内持续生效。对这个权衡,我的判断很明确:除非你只写一次性脚本且永不复用,否则版本控制的收益远大于成本。
⚠️ 常见坑:备份靠手动拷贝"当前目录"而不是靠版本仓库。手动拷贝只能保护最新状态,版本仓库保护的是整条历史——前者防丢文件,后者防丢"过程"。
💡 关键直觉:把版本历史当成项目的"审计账本"。账本的价值不在记账本身,而在出事时能查、能对、能还原。你越是在意代码质量,越需要这本账。
场景自测:下面哪种情况需要版本控制?
为了帮你把抽象价值落到具体判断上,做四个小测试:
- 你正在写论文,导师说"第 3 章改回上周那个版本"。你上周没存副本,现在要手动回退——需要。
- 你和同事同时维护一份接口文档,各改各的,谁后保存谁覆盖谁——需要。
- 你写的脚本只跑一次、用完就删、永远不改——不需要,成本大于收益。
- 你的个人项目持续演进,会加功能、会重构、会踩坑重来——需要。
判断标准总结成一句话:只要你的内容会"回头改",就需要版本控制。 "回头改"意味着你要找回过去的状态,这正是版本控制的看家本领。至于项目规模大小、是否多人协作,都只是次要变量。
补充说明一下"回头改"的分量:它不只是"改错了要回退"这么简单。真实开发中,你会反复比较新旧两版哪个更好、会为了排查一个 bug 翻一周前的代码、会从旧版本里救回一段被删掉的逻辑——这些全是"回头改"的具体形态。每一桩都在消耗时间,版本控制把这些消耗从"找回忆"变成"查记录"。
一节小结
- 手动命名混乱:复制粘贴建副本不可维护,VCS 用自动化记录替代。
- 协作覆盖:并行改动靠检出/提交与合并机制变成可控操作。
- 追溯能力:完整历史链让 bug 定位从"靠猜"变为"靠查"。
- 数据安全:分布式系统天然多副本,历史与当前状态都受保护。
- 实验自由:分支把"大胆尝试"的成本降到接近于零。
- 发布管理:标签与回滚让版本发布从混沌走向有序。
- 核心本质:版本控制把"状态"升级为"历史",让项目每一步都可审计。
- 落地优先级:频繁提交与规范信息最优先,高级功能按需引入。
下一节我们看版本控制的三种形态——同样是"记录变化",本地、集中式、分布式走的是三条完全不同的路。