1.3 版本控制系统的三种形态
1.3 版本控制系统的三种形态
本节摘要:版本控制系统按架构分为三大家族:本地型(RCS、SCCS)把历史存在单台机器,简单但无法协作;集中式(CVS、SVN、Perforce)用一台中央服务器统一管理,好理解却有单点故障;分布式(Git、Mercurial)让每个开发者拥有完整仓库副本,离线可用、无单点故障,代价是概念更复杂、克隆体积更大。本节用三张架构图把差异讲透,为理解 Git 打底。
你能学到什么
阅读完本节,你应当能够:
- 画出本地、集中式、分布式三种 VCS 的架构示意图。
- 指出集中式系统的单点故障风险及其网络依赖。
- 解释分布式系统"每个客户端都有完整历史"的含义与代价。
- 说出 Git、SVN、RCS 分别属于哪一族,并给出理由。
一、问题与直觉
想象一个团队从零开始选版本控制工具,他们会经历怎样的试错?
第一步自然是"最简单能用的"——把历史存在自己电脑上,这就是本地版本控制。单机自嗨没问题,可一旦需要两人协作,就傻眼了:历史在我这台机器上,你怎么看?拷给你?那两边的历史不就分裂了吗?
于是第二步升级:既然大家都要看同一份历史,就把仓库放到一台所有人都连得上的服务器上,这就是集中式。逻辑简单,管理集中,当年大多数团队止步于此。可这台服务器一旦宕机,整个团队立刻瘫痪——提交不了、更新不了、历史也看不了。服务器硬盘坏了且没有备份,整个项目的历史灰飞烟灭。
第三步是分布式:干脆把完整仓库复制到每个人的电脑上,谁都不依赖谁。这解决了单点故障,也带来新问题——概念变复杂了,本地和远程两套仓库的关系一开始总让人绕晕,而且克隆一个老仓库要下载全部历史,体积不小。
这三步就是版本控制系统的演化史,也是理解 Git 位置的最快路径:Git 是第三步的产物,而且把分布式的优势发挥到了极致。
为什么集中式统治了那么久?
在批评集中式之前,先给它应有的评价。SVN 之所以能统治软件行业十几年,不是因为开发者眼瞎,而是因为它确实解决了当时最痛的问题:多人协作。它把"历史在个人电脑里、别人看不了"这个本地型的死穴解决得干干净净——所有人在服务器上操作,谁提交了什么一目了然,权限也好管理。在那个年代,没有比它更好的选择。
它的真正软肋要等两个条件成熟才暴露:一是团队规模大到"服务器宕机 = 全组停工"的损失难以承受,二是开源协作兴起,分布式协作的诉求压倒了集中管控的便利。SVN 不是做错了什么,而是世界变了。
从"服务器思维"到"网络思维"的跃迁
集中式和分布式之间,横着一个思维模式的鸿沟。集中式的默认心智是"服务器是唯一真相源,本地只是工作台"——你从服务器取,改完交回,一切以服务器为准。分布式的默认心智是"每个本地都是完整真相,网络只是同步渠道"——你在本地提交、改历史、建分支,一切先在本地成立,网络只是让各处的本地保持一致。
这个跃迁解释了新手学 Git 时的大部分困惑:为什么我 push 之前改的东西"不算数"?为什么离线也能提交?为什么"远程被删了本地还能工作"?——因为本地本来就是完整的。一旦接受"本地即仓库"这个前提,Git 的一切行为都顺理成章了。
二、核心原理
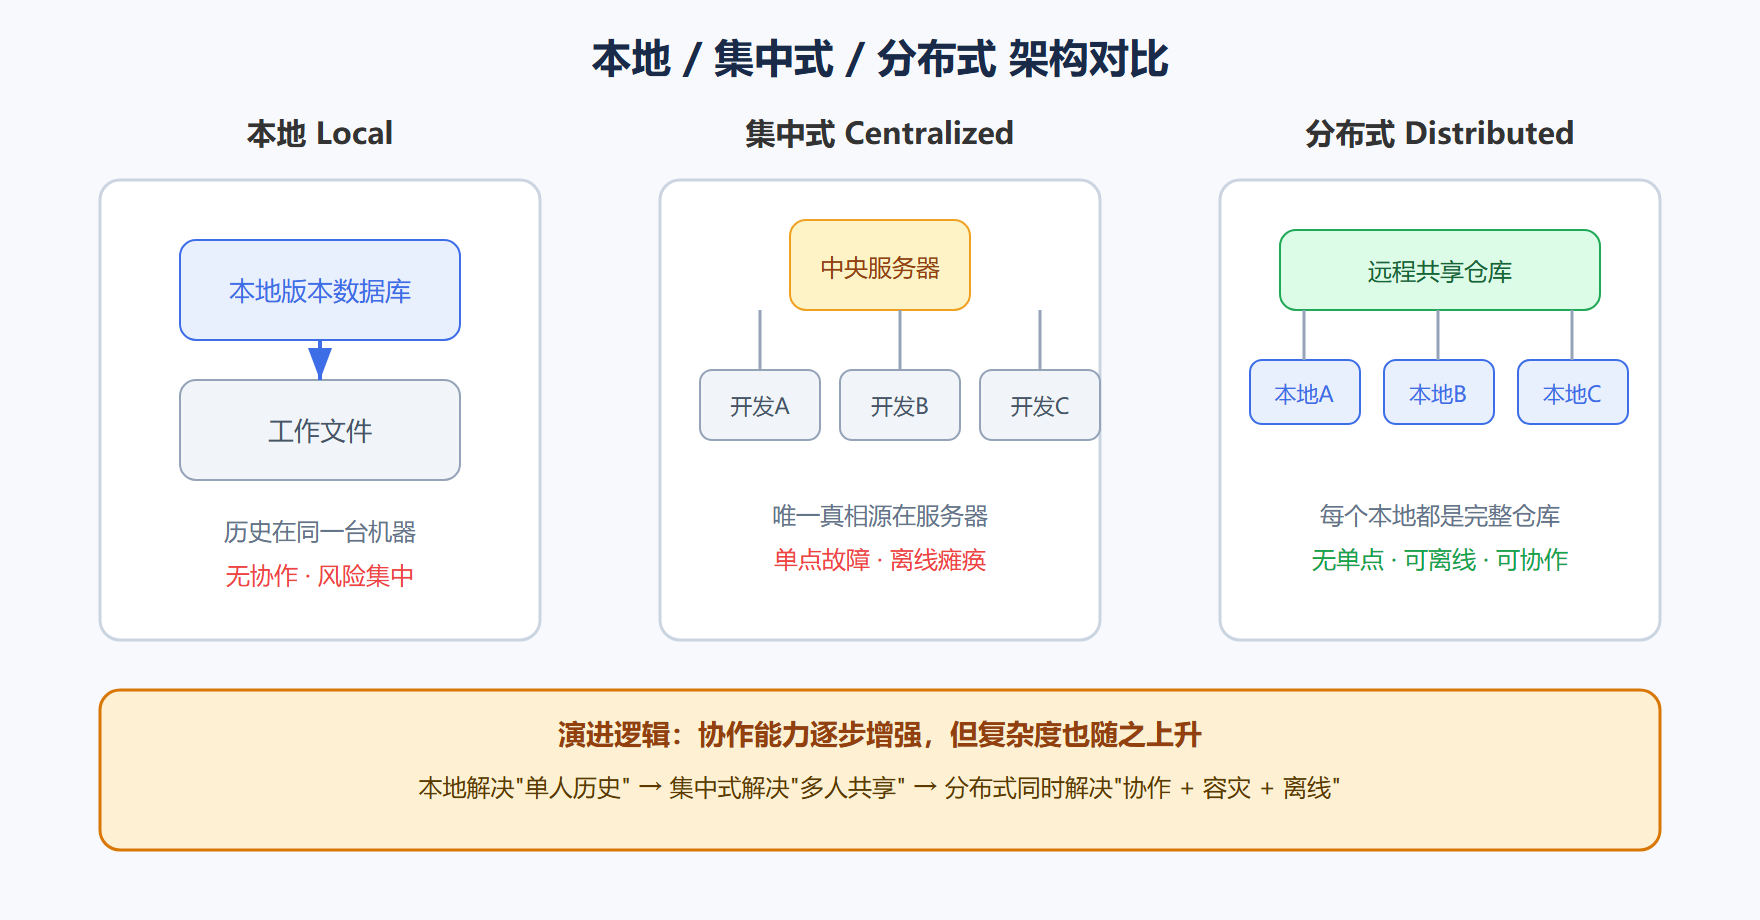
图 1-3 三种形态的架构演进对比
本地版本控制系统(Local VCS)
最早期的形态,把所有版本历史存在本地计算机的数据库中。你修改文件,然后提交到本地的版本数据库。代表是 RCS(Revision Control System)和 SCCS。
它的工作方式直白得像一个本地文件柜:
优点是不需要网络,安装即用。缺点是风险集中且无法协作:历史全在一台机器上,硬盘一坏全没了;别人根本连不上你的版本库,所谓协作只能靠互相传文件。
集中式版本控制系统(Centralized VCS)
为了解决协作,出现一个中心服务器存放唯一仓库。所有开发者从服务器"检出"文件修改,再"提交"回服务器。代表是 CVS、SVN、Perforce。
优点:管理集中、概念直观,管理员能在服务器上看清所有人的动作,权限也好控制。这是它统治了软件行业十余年的原因。
缺点同样致命:
- 单点故障:服务器宕机,所有人都无法提交、更新、看历史;硬盘损坏且无备份,整个项目历史就没了。
- 依赖网络:离线时连提交都做不了,更别说查看历史。
很多团队嘴上说"SVN 够用了",直到服务器磁盘报警那天才真正理解这两个缺点的分量。
分布式版本控制系统(Distributed VCS)
分布式系统把"检出文件"升级为"克隆整个仓库"——每个开发者的本地都是一个完整仓库,包含全部历史、分支和标签。提交通常在本地完成,再通过"推送/拉取"与远程或其他人的仓库同步。代表是 Git、Mercurial、Bazaar。
优点是一条长清单:
- 无单点故障:远程仓库再出问题,每个人的本地都有一份完整历史。
- 离线工作:提交、看历史、建分支全在本地,飞机上也能干活。
- 速度快:大部分操作不走网络,秒级响应。
- 分支强大:分支创建和合并都极轻量,后面章节会细讲。
代价也不是没有:初始克隆可能很大(要下载完整历史);概念上需要理解本地仓库与远程仓库的关系。但相比换来的可靠性,这些代价在绝大多数场景都值得。
三族对比总表
在对比之前,先给一个统摄性的观察:三种形态不是三个独立发明,而是对同一个问题——"历史存哪里"——的三代回答。本地型说"存我这儿",集中式说"存服务器上大家共享",分布式说"每人存一份,爱怎么同步怎么同步"。每一代都在补上一代的短板,也都在付出新的代价。看这张表时,请带着"谁在替谁买单"的眼光。
| 维度 | 本地型 | 集中式 | 分布式 |
|---|---|---|---|
| 历史存放位置 | 单台机器 | 中央服务器 | 每台客户端 |
| 协作能力 | 无 | 有 | 有,且更灵活 |
| 单点故障 | 有 | 有 | 无 |
| 离线工作 | 可以 | 不行 | 可以 |
| 代表产品 | RCS、SCCS | CVS、SVN、Perforce | Git、Mercurial |
| 学习曲线 | 最平 | 较平 | 较陡 |
三、工程实践要点
三种形态的选择逻辑其实简单:本地型只配个人单机,集中式适合小团队且能忍受停机窗口,分布式适合绝大多数现代项目。 Git 能成为事实标准,正是因为它在分布式阵营里把速度、分支能力和生态做到了极致。
落地时的两个提醒:
第一,别被"分布式"三个字吓住。很多人以为分布式 = 复杂,其实日常使用中你 90% 的时间只跟本地打交道,远程只是偶尔推送和拉取。分布式的复杂度是概念上的,不是操作上的。
第二,理解"分布式不等于没有中心"。Git 虽然技术上人人平等,但团队实践中通常指定一个托管平台(GitHub/GitLab 等)作为事实中心。这个中心是协作约定,不是架构依赖——它宕机了,大家的本地历史依然完好。
⚠️ 常见坑:把 SVN 时代的"集中式思维"带到 Git 里——例如把远程仓库当成唯一真相源,本地随便搞。Git 的本地仓库本身就是完整的,远程是同步枢纽而不是必需品,搞反了这个关系,遇到网络问题就会手足无措。
💡 关键直觉:把三种形态想象成图书馆的三种管理方式——本地型是你房间里的私人书架,集中式是只有一个总馆的总图书馆(闭馆你就借不了书),分布式是每家每户都有一整套馆藏副本的文献网络。Git 是第三种,而且副本之间随时能互相同步。
常见问题与 FAQ
现在还有人用 SVN 吗?为什么要了解它?
有,主要集中在老牌企业、银行、军工等对变更管控有特殊要求的行业。了解它不是为了怀旧,而是为了对比理解 Git:当你明白 SVN 的"集中式"意味着什么,你就更清楚 Git 的"分布式"省掉了哪些麻烦。面试、迁移项目、维护老代码时,这份认知都能派上用场。
分布式的"无单点故障"是不是绝对安全?
不是绝对,是相对。如果团队所有人只在同一个托管平台(如 GitHub)上协作,平台宕机期间大家确实推不了代码——但已有的历史在每个人本地都完好,谁都不怕丢。这就是"无单点故障"的准确含义:故障可能影响同步,但不影响数据本身。真正的保险还需要配合异地备份,但那是另一个话题了。
我可以先学 SVN 再学 Git 吗?
可以,但不推荐作为主路线。SVN 的集中式概念简单,能帮你建立"检出、提交、更新"的基本印象,但 SVN 没有暂存区、分支是目录拷贝,很多心智模型(比如"分支轻量")在 Git 里完全不同,反而可能带偏。直接学 Git 更高效,遇到难懂的概念时,本教程会用类比帮你拆解。
分布式系统的"克隆体积大"在实际中多严重?
视项目而定。老仓库或包含大二进制文件(图片、模型)的项目,首次克隆可能几百 MB;纯代码项目通常几十 MB 以内。现代带宽下,多等几秒换来的是一份完整历史,多数人觉得划算。如果实在在意,Git 还提供浅克隆选项只拉最近的历史,第 4 章会讲到。
总结:我该选哪种形态?
个人单机、无协作需求,可以本地型起步,但既然 Git 安装免费、命令不多,直接上 Git 更省事。需要协作的项目,直接选分布式,别在集中式上纠结——现在的生态,Git 及其托管平台已经把协作体验做到极好,SVN 的"管理便利"优势已经被平台功能取代。
核心回顾
- 本地型:历史存单机,简单无协作,硬盘坏即全灭。
- 集中式:中央服务器统一管理,直观但单点故障、依赖网络。
- 分布式:每人一份完整仓库,无单点故障、离线可用、操作快。
- 代表产品:RCS/SCCS、CVS/SVN/Perforce、Git/Mercurial 一一对应三族。
- 分布式代价:克隆体积大、概念更复杂,但可靠性收益通常远超代价。
- 实践认知:Git 的"分布式"体现在能力而非日常复杂度,远程中心是协作约定而非架构依赖。
下一节我们看 Git 本身——它 2005 年因何诞生,又凭什么在众多分布式系统中胜出。