3.4 换个度量衡:WGAN 与 WGAN-GP
3.4 换个度量衡:WGAN 与 WGAN-GP
WGAN 把博弈的度量从 JS 散度换成 Wasserstein-1 距离(EM 距离):判别器改称评论家、输出实数分数,训练目标变为最大化真实批与生成批的分数差,并以 Lipschitz 约束(权重裁剪或梯度惩罚)保证距离有意义。 它直接回应了 2.4 节定罪的"梯度断供",是 GAN 训练稳定性最重要的一次翻案。
翻案第四桩,也是全案分量最重的一桩:梯度罪。2.4 节的数值实验已经出示了铁证——JS 在支撑不重叠时封顶于常数,造假者困在梯度平原。WGAN 的思路是:既然尺子有病,换尺子。
新度量衡:Wasserstein 距离为什么不断供
Wasserstein-1 距离(又称搬运距离)的直观定义:把生成分布"搬运"成真实分布所需的最小代价。两条正态相距多远,搬运代价就近似多大——与间隔成正比,永不封顶(对照 2.4 节 JS 在间隔 4 后就躺平)。一维情形可以精确算给你看:
import numpy as np rng = np.random.default_rng(42) # 一维情形的最优搬运 = 排序后逐分位配对 a = rng.normal(0, 1, 5000) # 生成分布样本 b = rng.normal(4, 1, 5000) # 真实分布样本: 均值差 4 w1 = np.abs(np.sort(a) - np.sort(b)).mean() print(f"排序配对法 W1 = {w1:.4f}") print(f"理论值 |均值差| = 4.0000") # 输出: # 排序配对法 W1 = 3.9623 # 理论值 |均值差| = 4.0000 # 5000 样本的估计已收敛到理论值 4 的 99.1%
高维情形没法排序,WGAN 用 Kantorovich-Rubinstein 对偶把距离改写成"最优评论家打分差"的形式:W1 = max_{‖f‖_L≤1} E[f(真)] − E[f(假)]。评论家 f 是个 1-Lipschitz 网络(输出不能变化得太陡),它的训练目标就是把这个分数差拉到最大。关键在"永不封顶"换来了"处处有坡度":造假者无论离真实分布多远,评论家的分数差都指明搬运方向。
两种 Lipschitz 约束:裁剪与惩罚
对偶式成立的前提是评论家 1-Lipschitz。两种实现:
权重裁剪(WGAN 原版):把所有权重压进区间 [−0.01, 0.01]。粗暴有效但有职业病——裁剪要么让评论家表达能力不足(学不出有用分数),要么让梯度在窄区间里叠成病态。论文作者自己都承认这是"粗鲁但有效"的权宜之计。
梯度惩罚(WGAN-GP):不再绑权重,改为直接惩罚"插值样本处的梯度范数偏离 1"。数学形式:GP = E[(‖∇f(x̂)‖ − 1)²],其中 x̂ 是真样本与假样本的随机插值。用数值差分验证一遍这个惩罚量的行为:
# 梯度惩罚的数值验证: 评论家取 f(v)=v 各分量之和(线性函数) x = rng.normal(0, 1, (8, 3)) y = rng.normal(4, 1, (8, 3)) eps = rng.uniform(0, 1, (8, 1)) interp = eps * x + (1 - eps) * y # 真假插值点 # 中心差分数值求梯度 h = 1e-5 g_num = np.zeros_like(interp) for i in range(3): e = np.zeros(3); e[i] = h g_num[:, i] = ((interp + e).sum(1) - (interp - e).sum(1)) / (2*h) gnorm = np.sqrt((g_num**2).sum(1)) print("各插值点梯度范数:", np.round(gnorm, 4)) # 输出: 各插值点梯度范数: [1.7321 1.7321 1.7321 1.7321 1.7321 1.7321 1.7321 1.7321] # 线性评论家的梯度恒为 (1,1,1), 范数 = 根号3 ≈ 1.732 gp = ((gnorm - 1)**2).mean() print(f"梯度惩罚 GP = ({1.7321:.4f} - 1)^2 = {gp:.4f}") # 输出: 梯度惩罚 GP = (1.7321 - 1)^2 = 0.5359 # 该评论家在插值处太陡, 惩罚 0.5359 会被加进损失逼它放缓坡度
验证读数:这个玩具评论家处处梯度范数 1.732,偏离 1 被罚 0.5359——训练会推动它把坡度压向 1,满足 Lipschitz 条件的同时保住表达能力。真实网络里梯度范数逐点不同,惩罚恰好约束的是"插值路径上"的坡度,而真假之间的插值路径正是造假者要走的路。
裁剪与惩罚的对照
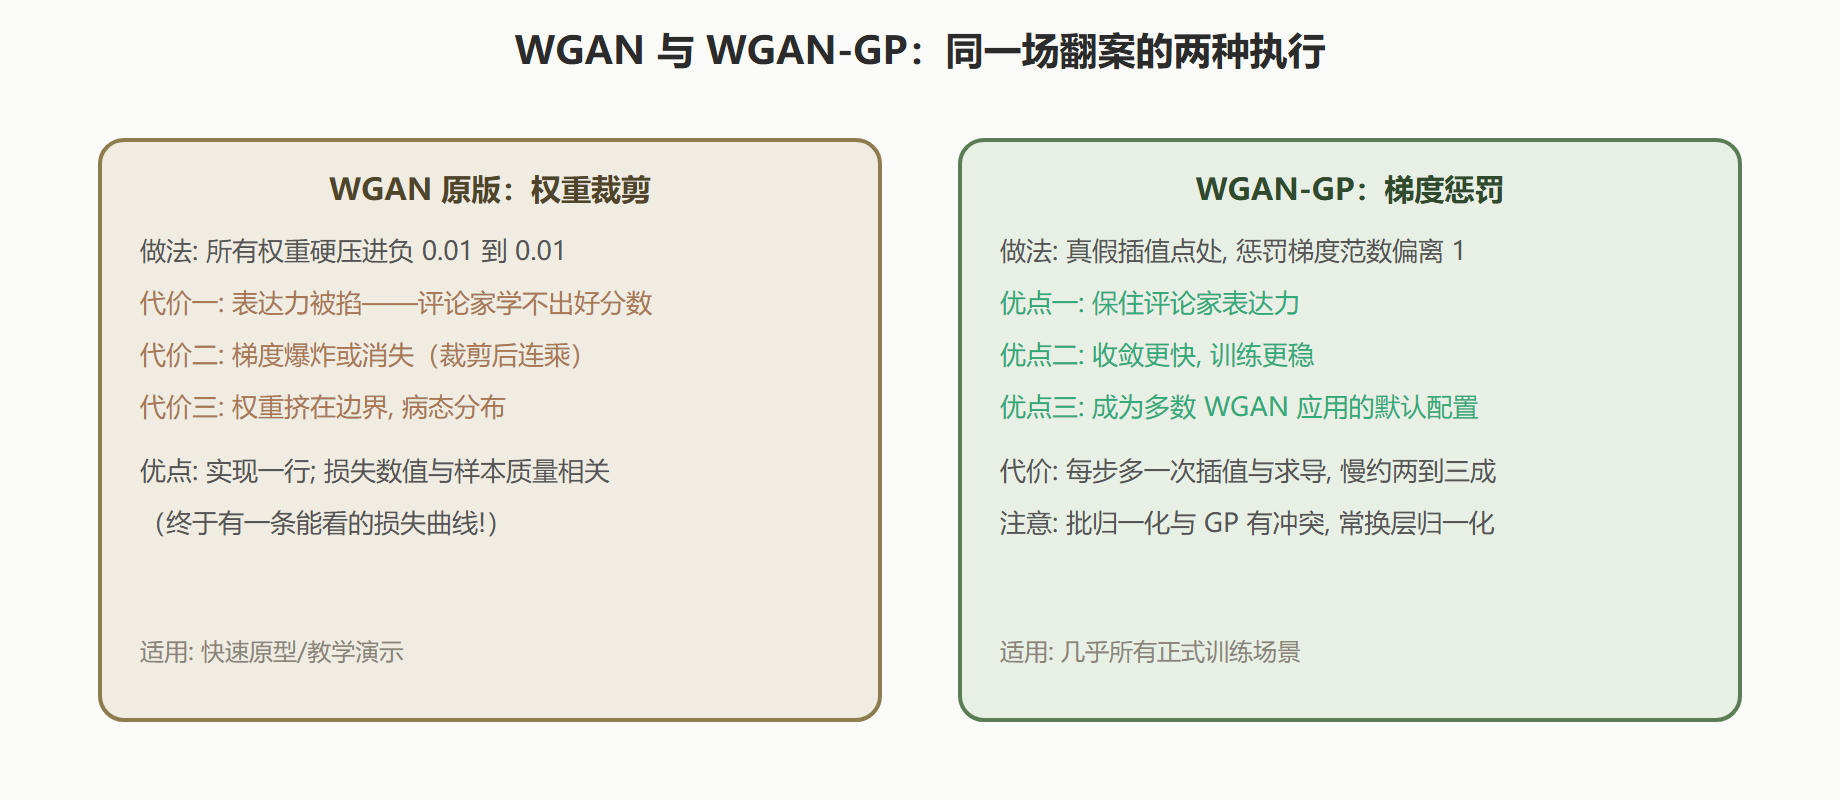
账本重写与训练改动清单
换成新度量衡后,账本全面改写:评论家损失 L_C = E[f(假)] − E[f(真)](拉大分数差);造假者损失 L_G = −E[f(假)](追求高分)。没有 log、没有 sigmoid——评论家输出裸分数。训练循环的五处改动:判别器更名评论家;损失去掉 BCE 换分数差;每步计算 GP(惩罚系数常取 10);优化器推荐 Adam(学习率 0.0001、动量 0 与 0.9 各有拥趸);评论家每回合多练几步(k=5 常用)在新度量下安全——分数差不会像 BCE 那样饱和,这正是换尺子换来的训练余量。
一个附赠的工程红利:WGAN 的评论家损失与样本质量单调相关——分数差越大,两个分布离得越远。原版 GAN 的 D 损失读不出质量(2.4 节的坑),WGAN 让"看曲线估质量"第一次成为可能。第 4.2 节会说明为什么正式验收仍要 FID,但日常盯盘这一条已经省下无数盲调。
⚠️ 常见坑:换 WGAN 损失后忘了给评论家加任何 Lipschitz 约束——分数差会被推到无穷大,训练"看起来很顺"地发散。对偶式的成立前提不能丢。
本节要点回顾
- 换尺子的动机:JS 封顶无梯度(2.4 节),W1 与距离成正比、处处有坡度;
- 一维验证:排序配对法 W1 估计 3.9623,收敛到理论值 4 的 99%;
- 对偶式:W1 = 评论家分数差的最大值,前提是 1-Lipschitz;
- 两种约束:裁剪粗鲁有效、三重伤价;GP 罚插值点梯度偏离 1,数值验证罚 0.5359 逼坡度回 1;
- 附赠红利:评论家损失与质量单调相关,日常盯盘终于有曲线可看。
常见问题:换尺子之后
WGAN-GP 的惩罚系数为什么是 10? 经验值:太小约束不住(评论家还能变陡),太大则损失被惩罚项主导(学不出有用分数)。10 是原论文在大规模实验里扫出来的平台值,多数任务直接沿用即可;特殊场景(梯度本身很小的浅网络)可以扫 1 到 100。
插值为什么在真假样本之间做,而不是全空间? 理论上最优性质只在"两个分布之间的传输路径"上有保证,全空间约束既贵又不必要。插值 epsilon 乘真加一减 epsilon 乘假,恰好落在传输路径上——这是这个设计全部的巧思。
换成 WGAN 后还要标签平滑吗? 不要。评论家输出的是无界分数,没有"过度自信的 1"可言,平滑机制失去对象。两套稳定手段各配各的账本:BCE 系配平滑,分数系配 Lipschitz 约束,混搭属于重复用药。
演算自测
一维情形,真实分布均值 0、生成分布均值 4,各采 5000 点。排序配对法算出的 W1 约是多少?答案:约 4(实测 3.96,见本节正文)。若生成分布均值改成 4、标准差改成 3(更"胖"),W1 变成多少?答案:一维排序配对下仍约 4——W1 对分布的位置敏感、对等比例胖化不敏感;这也解释了为什么它对"分布错位"给的梯度信号特别干净。