- 文集信息
- 目录大纲
- 最新文档
- 知识宇宙
文集详情
文集导读
教程导读:走进造假者与鉴定师的博弈室
生成对抗网络(GAN)是一种让两个神经网络互相博弈的生成模型:生成器扮演造假者,负责把随机噪声加工成以假乱真的样本;判别器扮演鉴定师,负责把真品与赝品区分开。两者在同一间"博弈室"里反复过招,最终造假者的工艺逼真到连鉴定师也无法分辨。 本教程以这间博弈室为舞台,从审理规则(博弈论与损失函数)讲到作案工艺(DCGAN、WGAN、StyleGAN 等进化路线),再到庭审难题(模式崩溃、训练震荡)与验收标准(IS、FID),最后走出法庭,审视深度伪造的伦理红线与扩散模型时代 GAN 的位置。
一间屋子,两张桌子。左边坐着造假者,右手边堆着一叠"作品";右边坐着鉴定师,面前摆着一摞真品。鉴定师每挑出一张赝品,造假者就回去改一版工艺;赝品再次混进真品堆,鉴定师再度练出更毒的眼光。谁也没想到,这个酒馆段子式的设定,会在深度学习里长成一个影响深远的模型家族。学 GAN 难,往往不是因为代码难写,而是因为直觉难建立:损失为什么会互相拉扯?训练为什么会忽然崩盘?换个距离度量为什么就能救活一场训练?把 GAN 当成一场持续审理的博弈来读,这些问题会顺很多——每一节都是一份案卷。
这间博弈室里有什么
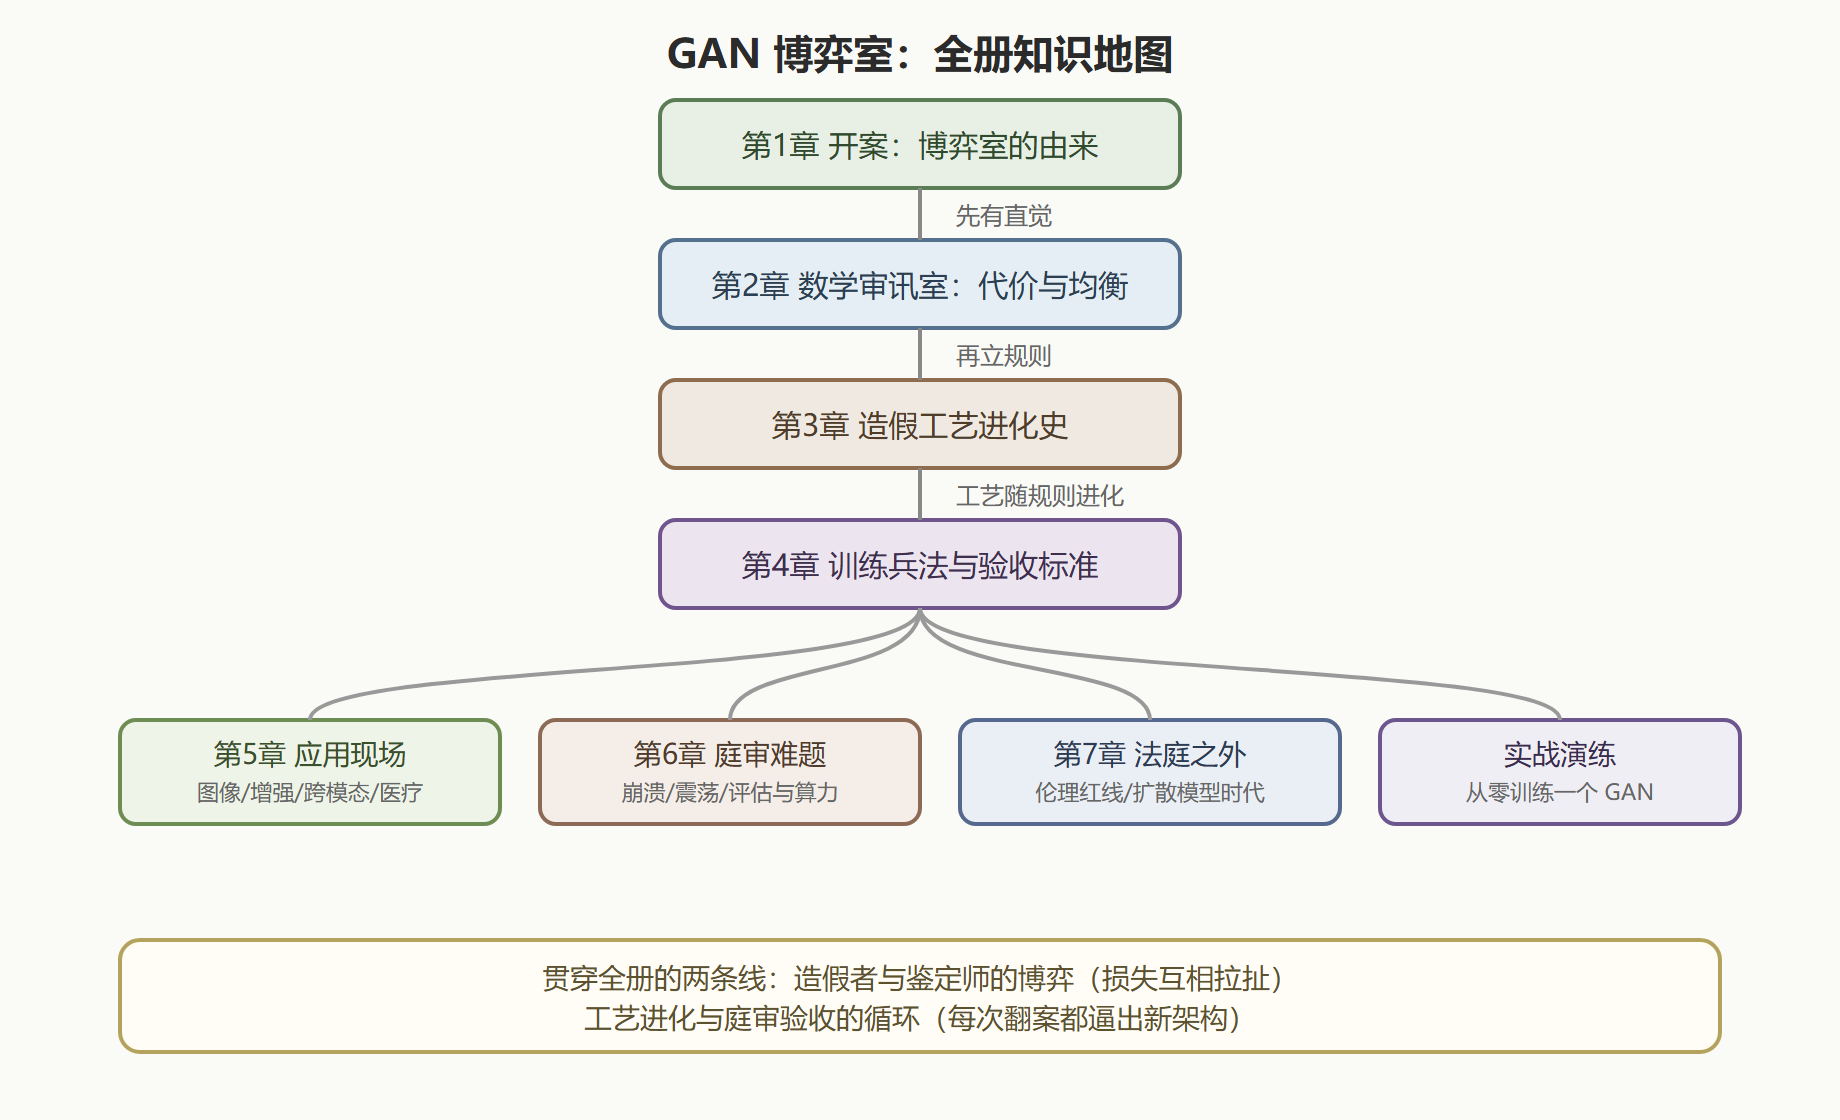
全册共七章,前三章建立"审理规则",后四章进入"实战与庭辩"。章与章之间的依赖关系见下面的知识地图:第一章立直觉,第二章给数学骨架,第三章沿着造假工艺的进化史展开架构家族,第四章把训练与验收变成可操作的清单,第五章走进应用现场,第六章集中审理几大疑难杂症,第七章走出法庭谈伦理与未来。建议按顺序读到第四章,之后五、六、七章可以按兴趣穿插。
全册知识地图
读法建议:三条入口
入口一:直觉派。如果你刚接触生成模型,从第一章开始老老实实读:博弈怎么开局、双方各自的账本(损失函数)长什么样,这两件事想通了,后面所有架构都只是"换工具不换行当"。
入口二:工程派。如果你已经写过一些深度学习代码,可以直接跳到第三章的 DCGAN 与 WGAN-GP,再配合第四章的实战演练节,把训练循环亲手敲一遍。数学审讯室那一章的数值演算建议回看,它能解释你训练时看到的一半怪现象。
入口三:应用派。如果你关心的是 GAN 能干什么,第五章按场景组织:图像合成、数据增强、跨模态生成、医疗影像。但请至少读完第二章的纳什均衡一节,否则很难理解为什么应用中会出现"生成器只会画一张脸"的模式崩溃。
本册的三个坚持
第一,数值可复算。全书的关键论断都配了可以在普通笔记本上复现的最小实验:JS 散度为什么会饱和、Wasserstein 距离怎么估、FID 对模式崩溃有多敏感,全部有代码与真实输出,不靠"据说"。
第二,案卷式组织。每个架构变体都当成一次"翻案"来讲:原判决(旧架构哪里出了问题)→ 新证据(新的度量或结构)→ 改判(新架构)→ 复核(代价与副作用)。读起来像审案,而不是背名录。
第三,直面失败。GAN 的训练以不稳定著称,本册不掩饰这一点:第六章整章都在审理崩溃与震荡,第四章的验收指标一节会告诉你"眼见为实"在生成模型里为什么靠不住。
准备好了就进屋吧,左边那位造假者已经开工了。
自查三问(读完导览即可回答)
GAN 与其他生成模型最根本的区别是什么? 大多数生成模型显式或隐式地优化一个"向真实分布靠近"的目标,GAN 的独特之处在于这个目标本身由另一个网络学出来——判别器就是那个可微的、随训练进化的"距离函数"。好处是不必手写似然,代价是训练变成博弈、稳定性成为长期议题。
本教程为什么反复出现"审讯、翻案、宣判"这类词? 这不只是修辞。GAN 十年的发展史几乎每一步都是"发现问题、定位病因、提出对策、付出新代价"的循环,用庭审隐喻组织内容,是为了让这条因果链始终可见——读者记住的不是名词列表,而是问题与对策的对应关系。
学完本册需要什么基础? 会读基础 Python 与 NumPy 代码、了解神经网络的基本概念即可。全书的关键数值演算(损失、距离、指标)都在一维或低维合成数据上完成,秒级可复现,不依赖 GPU。
术语速查
| 术语 | 本册用法 |
|---|---|
| 造假者 | 生成器 Generator,把噪声加工成样本 |
| 鉴定师 | 判别器 Discriminator,给样本打真假分 |
| 账本 | 损失函数,记录双方的代价 |
| 回合 | 一轮交替训练(先判别器后生成器) |
| 翻案 | 新架构对旧架构某条缺陷的针对性改进 |
| 验收 | 用 IS/FID 与人检给生成质量定标 |
目录大纲
最新文档
知识宇宙
正在加载知识图谱...