3.6 从低清到高清:PGGAN 与 StyleGAN
3.6 从低清到高清:PGGAN 与 StyleGAN
PGGAN 用"渐进增长"解决高分辨率不稳:从 4×4 起训,逐级加倍到 1024×1024;StyleGAN 在 PGGAN 骨架上重造噪声入口——用映射网络生成样式向量、逐层注入并自适应调制,实现属性解耦与可控编辑。 两代工艺把人脸生成从"能看"推到"以假乱真"。
翻案第六桩:分辨率罪。DCGAN 到 64×64 就到顶了——直接训 1024×1024 的 GAN,初期判别器轻松识破大堆低级伪影,梯度信噪比惨不忍睹。NVIDIA 的两代工作接续把分辨率推上 1024,并在StyleGAN 手里顺带完成了"可控编辑"这件事。
PGGAN:先学会爬再学跑
渐进增长的思路朴素得近乎老实:先训 4×4 的粗图(双方在小空间里博弈,信号干净),收敛后把生成器与判别器同步"长高"一级到 8×8,新层用淡入系数从零慢慢接管,如此爬到 1024×1024。每一级都站在上一级的肩膀上,判别器面对的永远是"当前级别还算像样"的对手,而不是从噪声里硬啃全分辨率。
配套还有两件小工具值得一提。小批量判别:在判别器里加统计模块,让各样本互相看得见——直接反制"生成器只会画一张脸"的模式崩溃(第 6.1 节的主题)。学习率逐级减半:分辨率翻倍后梯度噪声变大,步子相应放小。渐进增长的副产品同样重要:训练全程都能产出"当前分辨率"的可用样本,这在工程上比最后的 1024 结果更早创造价值。
StyleGAN:重造噪声入口
StyleGAN 的手术刀落在两个位置。第一,映射网络:原始噪声 z 先经一个 8 层 MLP 映射成"样式向量 w",再分发到生成器各层——w 空间比 z 空间的纠缠少得多(同样的"年轻"属性在 z 里可能和"性别""发型"搅在一起,在 w 里被摊平)。第二,自适应实例归一化(AdaIN):每层特征先做实例归一化(去掉原统计量),再用 w 的各分量重设均值方差——样式直接"调音"每一层的风格。用最小数值演示这种分层控制的分工:
import numpy as np rng = np.random.default_rng(5) # 16 维样式向量: 前 8 维作用于低分辨率层(4x4~16x16), 后 8 维作用于高分辨率层(32x32~1024x1024) coarse = rng.normal(0, 1, 4) # 粗层样式源: 控姿态/脸型等大结构 fine = rng.normal(0, 1, 4) # 细层样式源: 控发色/肤色/纹理等细节 w = np.concatenate([np.repeat(coarse, 8), np.repeat(fine, 8)]) print(f"样式向量 w: 形状 {w.shape}") # 输出: 样式向量 w: 形状 (16,) # AdaIN 数值演示: 某层特征 (2 通道 x 4 空间位置), 用 w 的两个分量重设统计量 feat = rng.normal(0, 1, (2, 4)) # 层特征 style_2ch = w[:2] # 该层分到的 2 个样式分量 normed = (feat - feat.mean(1, keepdims=True)) / (feat.std(1, keepdims=True) + 1e-8) out = normed * style_2ch[:, None] + style_2ch[:, None] # 缩放=分量, 平移=分量 print(f"重设前通道均值 {np.round(feat.mean(1),3)} -> 重设后 {np.round(out.mean(1),3)}") # 输出: 重设前通道均值 [0.237 -0.027] -> 重设后 [0.657 1.698] # 样式分量直接成为该层输出分布的均值——换分量即换风格
StyleGAN 样式注入分层图
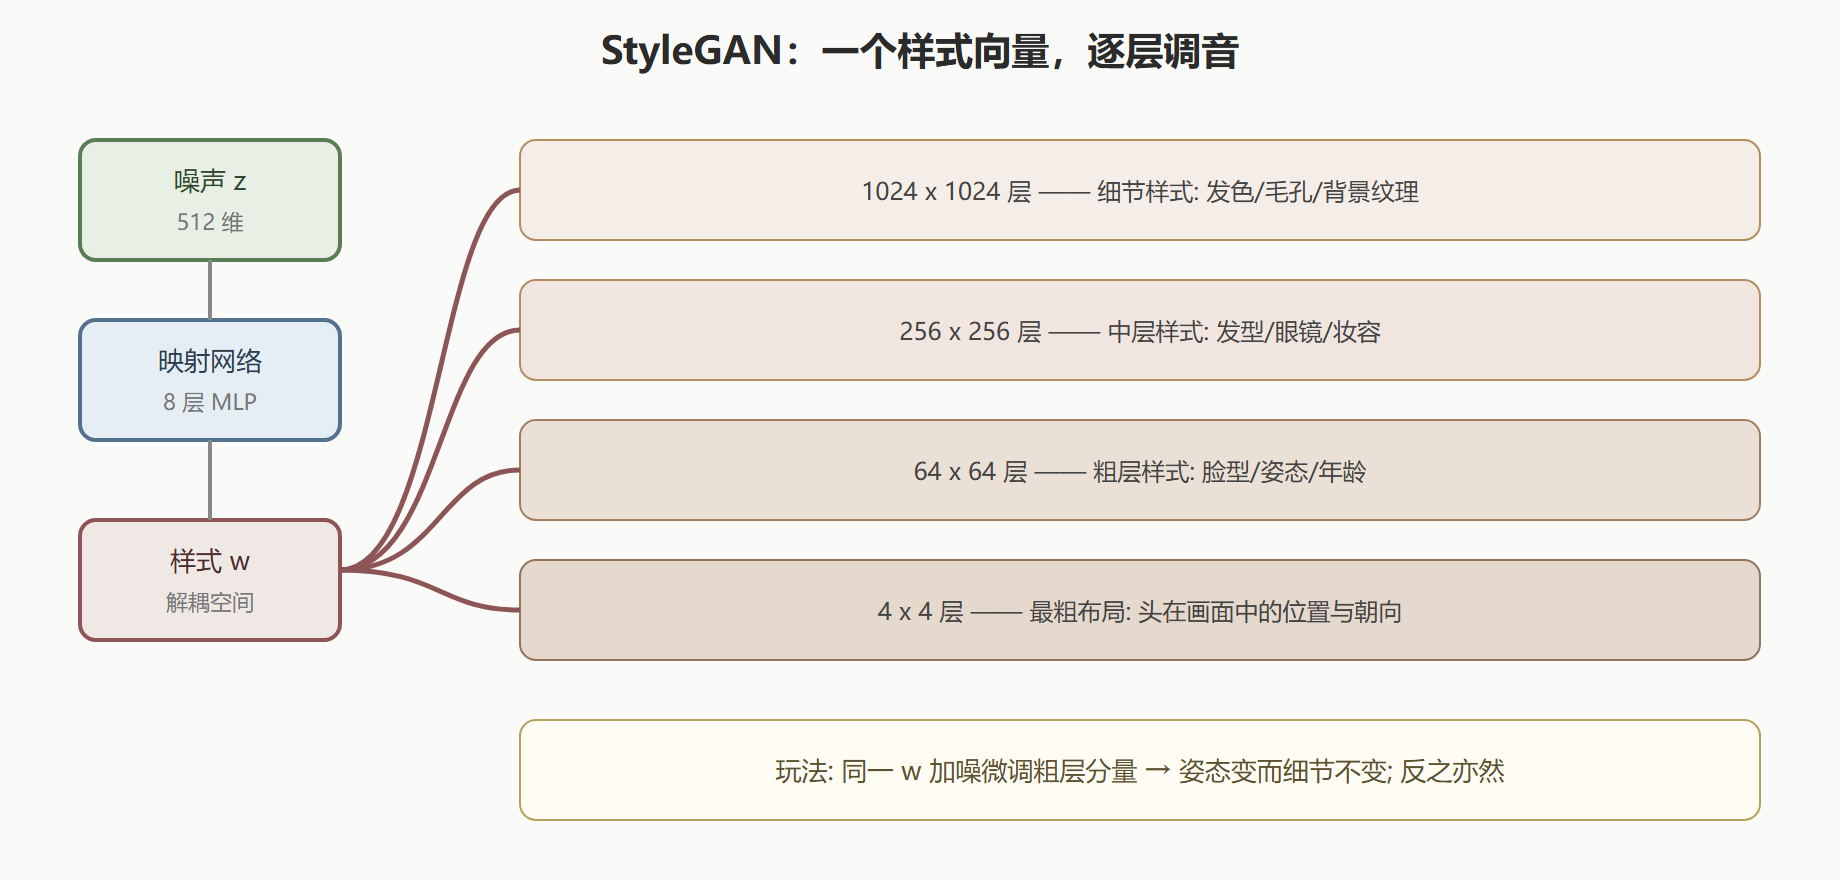
可控编辑:解耦带来的账面收益
样式空间的解耦直接兑换成编辑能力:在 w 空间沿某个方向平移,只动对应属性。StyleGAN2 进一步修掉了 AdaIN 的"水滴伪影"(把归一化引起的信息泄漏修成基于调制的权重修正),StyleGAN3 解决了"像素网格粘连"(特征与像素网格的相位绑定),让动画连续帧不再抖动。三代演进每一步都由具体的伪影证据驱动,是"翻案规律"(1.1 节)最连贯的注脚。
编辑能力到什么程度?定性地说:年龄、表情、发色、光照可以分开拧旋钮;混合两张图的 w 粗层与细层,能产出"甲的姿态 + 乙的发色"的合成脸。这类操作在 z 空间几乎做不到——属性纠缠,动一发牵全身。
⚠️ 常见坑:在人脸数据上训好的 StyleGAN 被直接拿去生成其他领域(产品图、风景),效果骤降。映射网络的解耦是相对训练分布学到的,换域要重训或微调,没有免费午餐。
本节要点回顾
- PGGAN 渐进增长:从 4×4 逐级爬到 1024×1024,判别器永远面对"当前级别像样"的对手;
- 两件配套:小批量判别反模式崩溃、学习率逐级减半抗梯度噪声;
- StyleGAN 两把刀:映射网络造解耦的 w 空间,AdaIN 逐层注入样式(数值演示:分量直接成为层输出均值);
- 分层控制:粗层管姿态脸型、细层管发色纹理,可分开编辑;
- 后续两代:StyleGAN2 修水滴伪影、StyleGAN3 修相位粘连,翻案规律继续生效。
案例展开:把 StyleGAN 用在人像之外的尝试
背景。某工业质检团队看中 StyleGAN 的可控编辑能力,想用它生成"指定角度、指定光照"的产品缺陷图,扩充检测器的训练集(5.2 节的增强场景)。直接拿开源人像权重换数据微调。
操作。第一步在自家数据(约四万张工件照片)上微调映射网络与生成器;第二步试图用样式向量控制缺陷类型——把不同缺陷类别的样本编码到 w 空间,取类间均值差当作编辑方向。
结果。分辨率与真实感很快达标(渐进策略的功劳),但编辑方向失灵:沿"划痕方向"移动 w,生成的图同时改变了工件角度与光照——属性没有解耦,映射网络学到的是自家数据里的纠缠表示。
解读。StyleGAN 的解耦是在人脸数据上学出来的副产品,不是架构的自动赠品:人脸数据里姿态与纹理天然弱相关,而工件照片的拍摄角度与光照高度相关(产线相机固定),纠缠是数据决定的。换域不是调参问题,是要重新审视数据的独立性结构。
变式。团队的修正路线:先做数据侧的解耦(多角度采集补齐,打破角度与光照的相关),再重训映射网络,编辑方向才开始起效。另一条路是放弃精细编辑、只用无条件生成加后期筛选(3.3 节条件化反而更直接:把缺陷类型当条件标签)。两条路线的成本差异与数据现状有关——这又回到"能配对就别绕路"的选型铁律。