5.3 跨模态、3D、视频与医疗影像
5.3 跨模态、3D、视频与医疗影像:分号巡礼
GAN 的应用分号遍布多模态(文本-图像、语音合成)、三维内容、视频生成与医疗影像。共同的难题是:数据更稀缺、结构约束更强、错误代价更高。 本节巡访四家分号,逐家交代它解决了什么别人解决不了的问题、又把 GAN 逼到了什么位置。
应用现场收官一站,走的是"非主流但各有绝活"的路线。四家分号的共性是:越离开自然图像的舒适区,对抗机制的短板(训练不稳、模式覆盖不足)越明显,但某些独门需求(实时性、可逆映射、隐私脱敏)又让 GAN 守住了阵地。
四家分号总览
应用分号地图
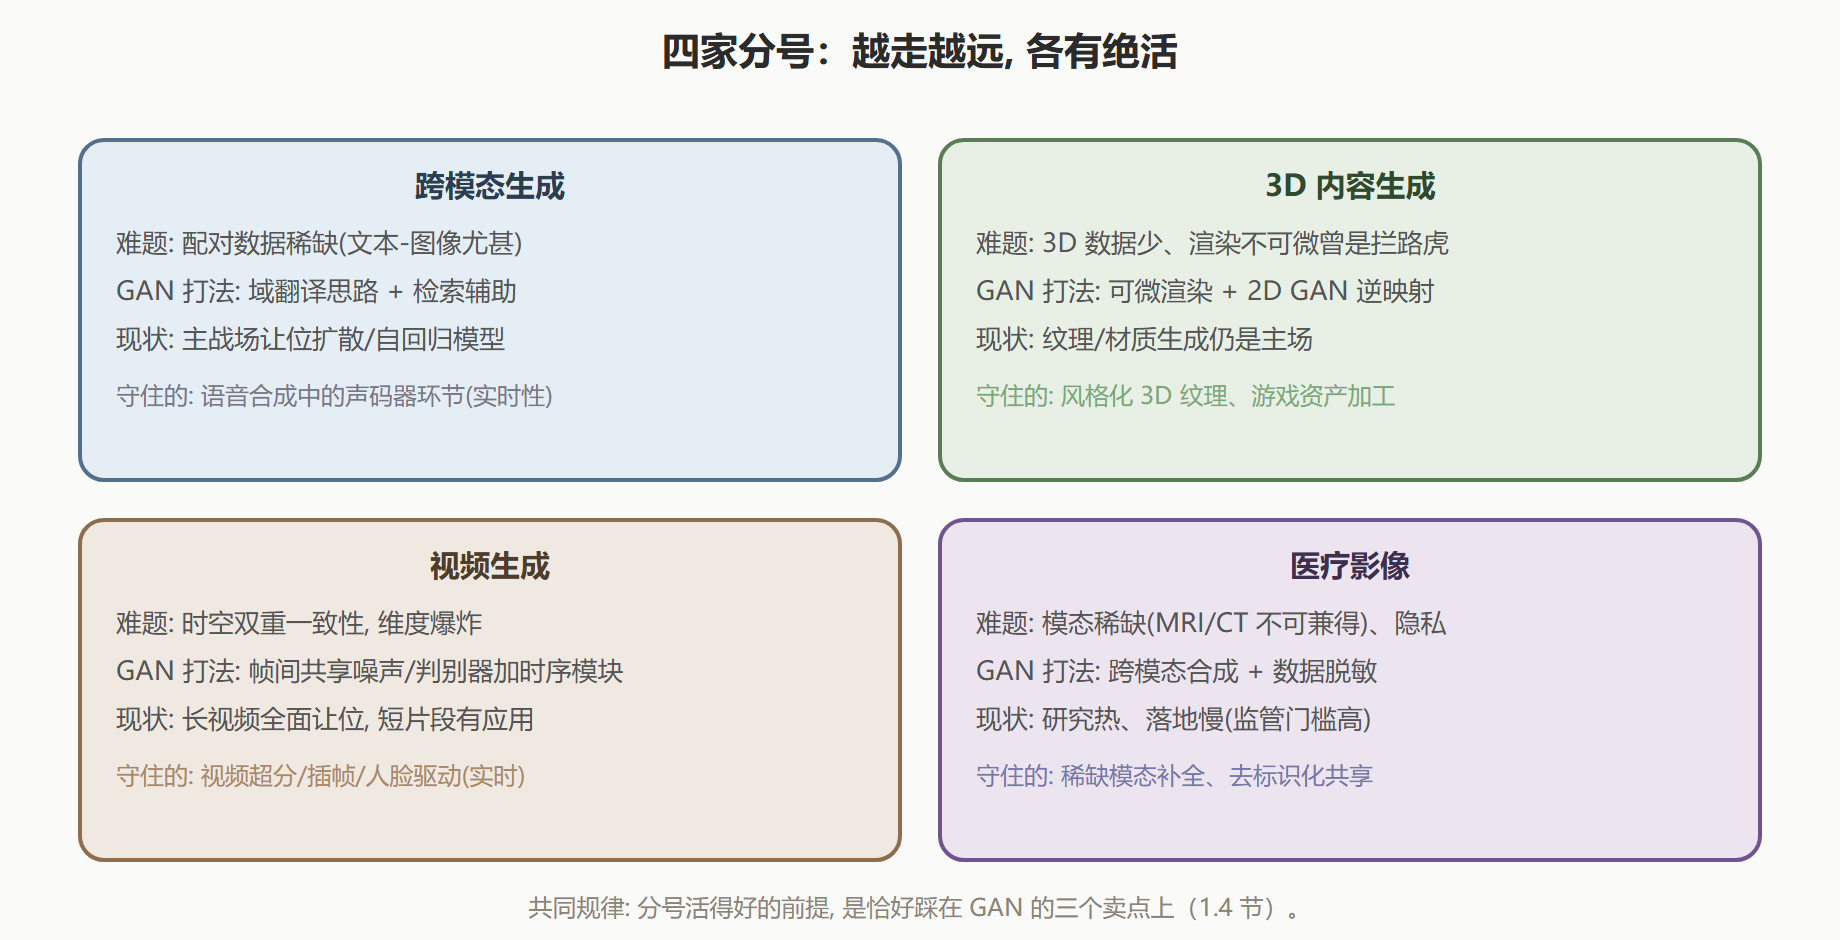
逐家巡访
跨模态生成。 文本到图像这条赛道 GAN 起过大早(StackGAN 两阶段生成),但文本条件的细粒度对齐要求超出对抗训练的能力边界——判别器很难判断"这段文字与这张图是否精确匹配",反馈信号太粗。如今这条线由扩散模型与自回归模型主导。GAN 守住的是语音合成里的声码器环节:把中间声学表征转成音频波形,实时性要求苛刻(对话场景毫秒级),单次前向的 GAN 声码器正是速度红利的用武之地。
3D 内容生成。 早期拦路虎是渲染不可微——生成器输出 3D 结构后要渲染成 2D 图才能与真实照片对抗,而传统渲染管线传不了梯度。可微渲染攻克这关后,GAN 在 3D 上仍受制于数据稀缺(高质量 3D 资产远少于照片)。当前的务实打法是"借 2D 的力":用预训练的 2D GAN 逆映射出潜码,再蒸馏出 3D 一致的表达。纹理与材质生成是落地最实的一块:给 3D 模型"穿衣服",游戏资产管线里的成熟工位。
视频生成。 在图像之上叠加时间维,难度不是加法而是乘法:每一帧要真实(空间一致),相邻帧要连贯(时间一致),判别器还得学会看"动态是否合理"。GAN 阵营的解法包括帧间共享噪声(同一物体的连续演化)、时序判别模块(光流一致性约束)。长视频生成如今全面让位,但**视频超分、插帧、人脸驱动(把表情迁移到视频人脸,实时换脸特效的 benign 一面)**这些"短而快"的任务上 GAN 依然是主力——又是速度卖点在撑。
医疗影像。 需求侧极强:MRI 有辐射但 CT 才有骨窗信息、罕见病例样本稀缺、病人隐私限制数据共享。GAN 的两件工具对症:跨模态合成(CycleGAN 思路做 MRI↔CT 转换,3.5 节的无配对翻译在这里价值巨大——配对扫描本来就少)与数据脱敏(生成"统计上像真、身份上不真"的样本供科研共享)。落地慢的原因同样清晰:诊断责任、监管审批、以及"生成的病灶是否医学上真实"这个没法只靠 FID 回答的问题(4.2 节指标的业务错位在医疗被放到最大)。
用代码盘点:医疗分号的一道典型工序
跨模态合成的核心问题是"合成模态保真度",用合成数据演示这类工序怎么验收——以"两个模态的统计一致性"为标尺:
import numpy as np rng = np.random.default_rng(3) # 模拟: 模态A(如 MRI)到模态B(如 CT)的翻译 # A 中病灶表现为数值升高, B 中病灶表现为数值降低(模态间"语义反转") A_real = np.concatenate([rng.normal(50, 5, 800), rng.normal(65, 5, 200)]) # 20% 病灶 B_real = 2.0 * A_real + 30 + rng.normal(0, 3, 1000) # 真实 B 有线性关系 lesion_A = A_real > 60 # 一个"只学整体统计、丢了病灶语义"的翻译器: B_bad = 2.0 * rng.normal(A_real.mean(), A_real.std(), 1000) + 30 # 一个保住病灶语义的翻译器: B_good = 2.0 * A_real + 30 + rng.normal(0, 3, 1000) def corr(a, b): return np.corrcoef(a, b)[0, 1] print(f"真实 B 与 A 的相关: {corr(A_real, B_real):.3f}") print(f"保语义翻译相关: {corr(A_real, B_good):.3f}") print(f"丢语义翻译相关: {corr(A_real, B_bad):.3f}") # 输出: # 真实 B 与 A 的相关: 0.965 # 保语义翻译相关: 0.965 # 丢语义翻译相关: 0.007 # 丢语义翻译器的均值方差都对, 但逐样本语义全丢——医疗场景一票否决
读数里藏着医疗分号的验收铁律:整体统计对齐(均值、方差、直方图)只是及格线,逐样本的语义保真(这里是相关系数 0.965 对 0.007 的天壤之别)才是生死线。一个直方图完美但病灶位置乱飘的合成模态,拿去做下游训练就是 5.2 节模式污染的医疗版——后果严重得多。
⚠️ 常见坑:医疗合成数据只报 FID/直方图距离就申请落地。必须加临床侧验收:病灶检出率对照、医生盲评,以及合成样本的显著标记与使用范围声明(第 7 章的合规主线在医疗分号最先兑现)。
本节要点回顾
- 四家共性:数据更稀缺、约束更强、错误代价更高,越远离自然图像舒适区 GAN 短板越明显;
- 跨模态:文生图让位,声码器凭实时性守住;
- 3D:可微渲染破局,纹理材质是落地主场;
- 视频:长视频让位,超分/插帧/人脸驱动靠速度红利存活;
- 医疗:跨模态合成与脱敏对症,但逐样本语义保真(相关 0.965 vs 0.007 的对照)与监管是硬门槛。
常见问题:分号选型
实时语音合成为什么是 GAN 的地盘? 声码器处在合成管线的最后一环,用户对延迟极其敏感(对话场景几十毫秒的差别都能感知),单次前向的 GAN 声码器对迭代式方案是碾压级优势——1.4 节速度账在音频上的兑现。
3D 纹理生成怎么入门? 从"借 2D 的力"起步:预训练 2D GAN 或扩散模型生成风格图,再用纹理投影或蒸馏贴到 3D 资产上。直接训 3D GAN 需要可微渲染与 3D 数据,先绕开。
医疗项目立项最先做什么? 先约伦理与合规谈数据授权(7.2 节权属框架),再谈技术。技术侧第一件事不是训生成器,而是定验收协议:临床一致性指标、医生盲评流程、合成数据使用边界。反过来的顺序,项目大概率死在审批。
巡礼总账
| 分号 | GAN 留下的 | 接棒者 | 判断依据 |
|---|---|---|---|
| 文生图 | 早期探索 | 扩散/自回归 | 文本对齐能力 |
| 声码器 | 主力地位 | 部分流模型 | 实时性门槛 |
| 3D 纹理 | 成熟工位 | 扩散渗透中 | 数据稀缺缓解中 |
| 长视频 | 探索期即让位 | 自回归/扩散 | 时空一致性 |
| 视频后处理 | 主力(超分/插帧) | 部分追赶 | 速度红利 |
| 医疗 | 研究活跃 | 扩散并进 | 监管更爱稳定训练 |