6.1 模式崩溃:只画一张脸的造假者
6.1 模式崩溃:只画一张脸的造假者
模式崩溃指生成器收敛到数据分布的一小部分模式:它能产出极逼真的样本,但翻来覆去只有那几类,分布多样性大幅缩水。 其博弈论根源是"局部最优的生存策略"——死磕一个能骗过判别器的模式,比分散兵力更安全。本节完成验尸(覆盖率诊断)、查动机(崩溃的博弈动力学)与宣判(三类干预手段)。
庭审难题第一案,也是 GAN 最著名的病。症状极具迷惑性:单看每张生成样本都挺好,判别器也挑不出毛病,损失曲线一片祥和——直到你批量采样才发现,一千张"人脸"其实是同一张脸的五十个变体。
验尸:用覆盖率指标确诊
诊断金标准是模式覆盖率:把数据分布划成若干模式(或聚类中心),看生成样本实际覆盖了几个。在四模式合成数据上做一个完整验尸:
健康生成器 vs 崩溃生成器
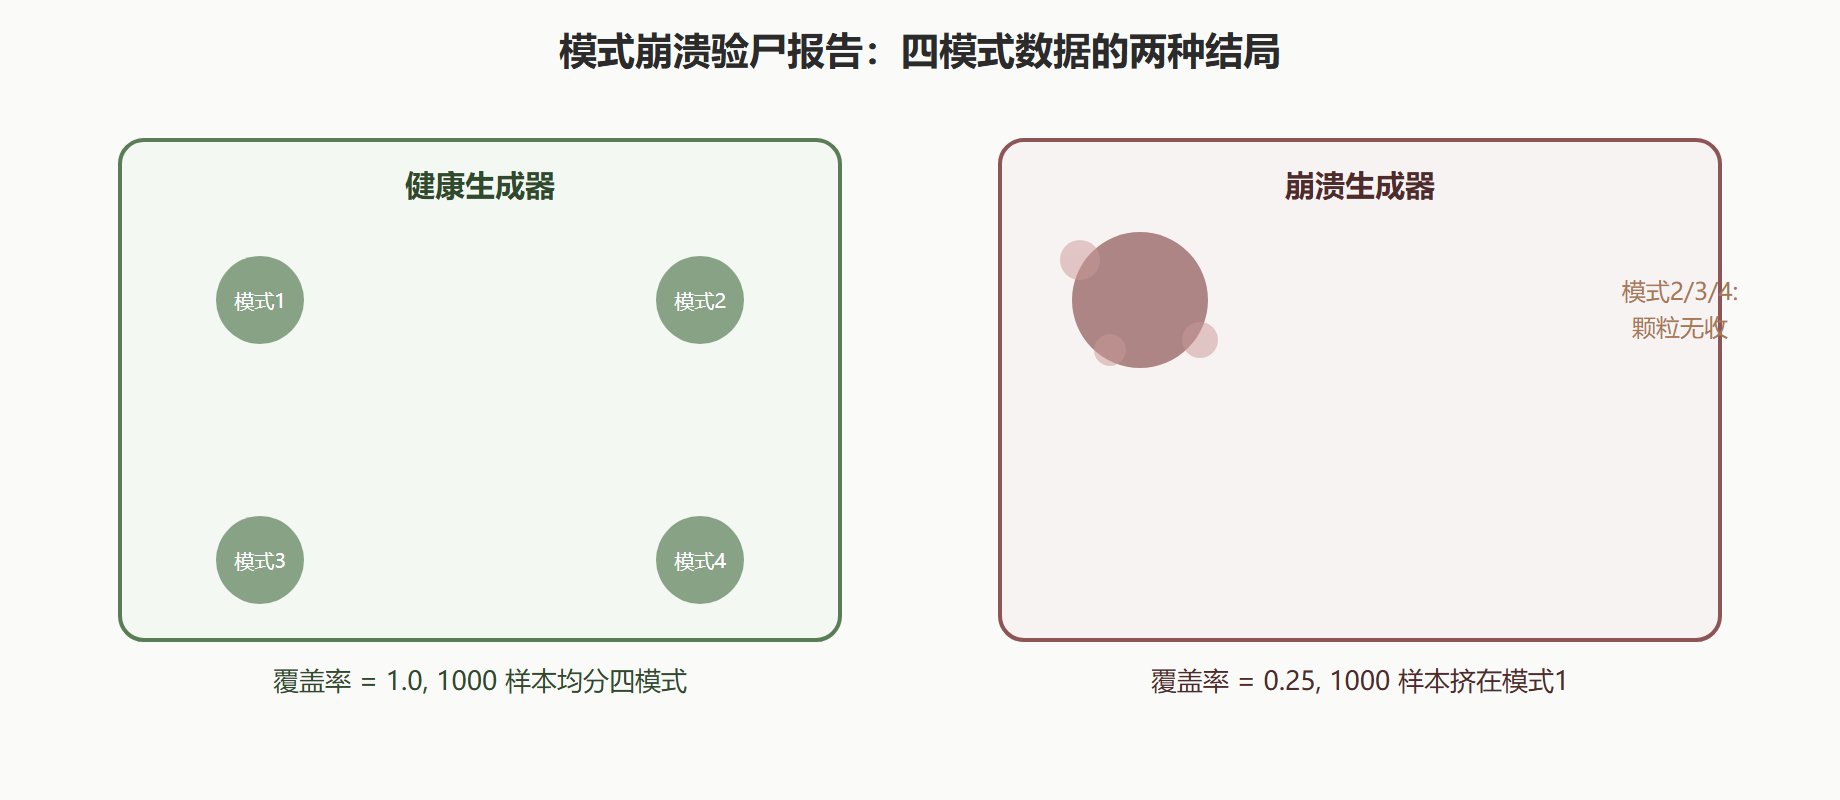
import numpy as np rng = np.random.default_rng(42) modes = np.array([[-2, 0], [2, 0], [0, 2], [0, -2]], float) # 崩溃生成器: 无论噪声如何, 输出都聚在模式 0 附近 gen = modes[0] + 0.2 * rng.normal(0, 1, (1000, 2)) # 诊断: 每个生成样本归属最近模式, 统计覆盖 assign = np.argmin(((gen[:, None, :] - modes[None]) ** 2).sum(-1), axis=1) counts = np.bincount(assign, minlength=4) print("各模式样本数:", counts) print(f"覆盖率(样本数>50 的模式占比): {(counts > 50).mean():.2f}") # 输出: # 各模式样本数: [1000 0 0 0] # 覆盖率(样本数>50 的模式占比): 0.25 # 对照: 健康生成器 idx = rng.integers(0, 4, 1000) gen_ok = modes[idx] + 0.2 * rng.normal(0, 1, (1000, 2)) assign_ok = np.argmin(((gen_ok[:, None, :] - modes[None]) ** 2).sum(-1), axis=1) print("健康生成器覆盖率:", (np.bincount(assign_ok, minlength=4) > 50).mean()) # 输出: 健康生成器覆盖率: 1.0
验尸结论清晰:崩溃生成器覆盖率 0.25,健康生成器 1.0。这个诊断脚本可以直接搬进项目——把 modes 换成训练集的聚类中心,就是生产环境的崩溃哨兵。再配合 4.2 节的 IS(崩溃时跌向 1.0)双指标交叉确认,误诊率很低。
查动机:为什么"只画一张脸"是理性选择
崩溃不是 bug,是造假者的理性生存策略。博弈动力学如下:判别器逐批见到真假样本,对高频出现的生成模式反应最快;生成器若同时维护四个模式,等于四线作战、处处被针对;若死磕一个模式做到极致,判别器在这个模式上被反复糊弄,生成器局部收益更高。等判别器终于识破这个模式,生成器往往不是"拓宽产品线",而是整体迁移到下一个能骗住的模式——于是训练曲线上看到生成结果周期性地"换一张脸",每个周期内都高度单一。
这个动机分析直接指向干预方向:想让生成器不走捷径,就得让"只画一张脸"变得不划算。
宣判:三类干预手段
第一类:让判别器看见"批次"而不是"单样本"。 小批量判别(PGGAN 配套,3.6 节)给判别器加一个统计模块——计算批内样本间的中间层距离并拼接进判决。效果:一批 64 张一模一样的脸在判别器眼里自动"露馅"(批内统计异常),死磕单一模式的收益暴跌。这是对症下药最直接的一类,代价是判别器变慢。
第二类:让生成器预知未来。 Unrolled GAN 让生成器更新时把"判别器接下来 k 步会怎么应对"算进梯度——相当于下棋看三步。死磕单一模式在两步之后就会被识破,短期收益的诱惑消失。代价是计算图变深、训练变慢,实际用得不多,思想很漂亮。
第三类:从损失侧分兵。 特征匹配(生成器不再追求骗过判别器,而是追求特征统计量对齐真实批)、多样性正则项、或直接换 WGAN-GP 度量(EM 距离对每个模式分别计费,丢一个模式就丢一份距离,作弊无利可图——3.4 节换尺子的又一重红利)。
| 手段 | 干预位置 | 代价 | 适用 |
|---|---|---|---|
| 小批量判别 | 判别器看批统计 | D 变慢 | 图像任务标配备选 |
| Unrolled GAN | 生成器看 k 步未来 | 计算图深 | 研究场景 |
| 特征匹配/多样性正则 | 生成器目标改造 | 实现改损失 | 通用 |
| WGAN-GP | 度量衡更换 | 插值求导开销 | 通用首选之一 |
💡 关键直觉:模式崩溃的本质是"梯度信号只奖励眼前收益"。三类干预殊途同归——都是把"长期与全局"的信息塞回给生成器,让作弊变得无利可图。
本节要点回顾
- 症状迷惑性:单样本逼真、损失祥和,批量采样才见真章——覆盖率诊断是哨兵;
- 验尸读数:四模式数据崩溃覆盖率 0.25 对健康 1.0,可聚类复用于生产;
- 动机:单模式死磕是博弈的理性捷径,判别器逐批反应速度是共犯;
- 三类干预:批统计(小批量判别)、预知未来(unrolled)、损失分兵(特征匹配/换度量);
- 与 4.2 节联动:覆盖率 + IS 双指标交叉监控,是崩溃的早期预警组合。
常见问题:崩溃诊断与治疗
崩溃与"截断技巧"怎么区分? 一个是病、一个是旋钮。截断是主动收窄噪声换保真(3.7 节),随时可逆且过程平滑;崩溃是生成器走捷径,把噪声旋钮调回去也不恢复。诊断金标准仍是覆盖率:截断下各模式比例均匀缩小,崩溃下模式数量直接消失。
部分崩溃(丢一半模式)怎么发现? 批量采样至少几百张做聚类统计,样本少了统计不稳。也可以用 IS 做哨兵:覆盖缩水会压低边缘分布多样性,IS 缓降是部分崩溃的早期信号,覆盖率骤降是确诊。
干预手段可以叠加吗? 可以但要有顺序:先上便宜的(特征匹配、多样性正则只改损失),不行再上小批量判别(判别器改造),Unrolled 这类重型手段最后考虑。每种干预引入后都要重跑覆盖率诊断,防止按下葫芦浮起瓢。
演算自测
八模式数据上,某生成器采样一千张,聚类统计为每模式 125 张上下浮动 10。覆盖率是多少?健康吗?答案:八模式全部超过阈值(比如 50),覆盖率 1.0;各模式占比约 0.125 且波动小,属于健康。若统计变为四个模式各 250、四个模式为零呢?覆盖率 0.5,半崩溃——恰好对应"部分崩溃"的典型形态,该启动干预流程了。
案例快照:一次崩溃的完整时间线
某手写数字训练日志:第 12 个 epoch,覆盖率从 0.9 缓降到 0.7(IS 同步从 6.1 掉到 4.5);第 15 个 epoch 采样出现"三个数字消失";第 17 个 epoch 覆盖率 0.4,固定噪声批里同一样本占比过半。干预:第 17 个 epoch 起启用特征匹配(损失层最便宜的一刀),第 22 个 epoch 覆盖率回到 0.85,IS 回到 5.8。这条时间线的教训有二:覆盖率缓降先于明显崩坏三到五个 epoch,哨兵指标给足了反应窗口;而损失曲线在整个过程中"风平浪静"——又一次证明崩溃要从采样侧看,不能从损失侧看。