1.1 稳定性与 SLI、SLO、SLA 度量
1.1 稳定性与 SLI、SLO、SLA 度量
本节摘要:稳定性不该是一个"感觉还行"的灰色词汇,而应是一套能被数字法庭审判的规则。本节引入 Google SRE 的 SLI、SLO、SLA 三级度量语言,讲清楚每一级各自回答什么问题、怎么计算错误预算,并给你一套从零为一个接口写出 SLO 的实操步骤。
为什么我总说不出"稳还是不稳"
值班室里最尴尬的一句话,是领导问"这系统稳定吗",而你答"还行吧"。这等于没说。"还行"是形容词,形容词没法当门槛用——你不知道什么时候下单报警,也不知道承诺给客户的可接受时长到底是多少。稳定性的前提,是先把它变成一串能算、能比、能判的数。
我们换个更容易建立的直觉来理解这套语言。想象你负责一台自动售货机,你对顾客的承诺是"这台机器全天都能吐货"。那么你需要回答三件事:用什么来测量它有没有做到?答:看"每次投币后能不能拿到商品"。你能容忍到什么程度?答:"一百次里有九十九次能拿到"。对外怎么签约、违约赔多少?答:白纸黑字写下来,做不到就赔钱。这三问,正好对应 SLI、SLO、SLA。
三级语言各管一段
SLI(Service Level Indicator) 是"测什么"。它是一条可量化的原始信号:可用性、延迟、错误率、吞吐量。度量必须落在用户真实感知的层面,而不是机房某个无关紧要的计数。例如对支付接口,SLI 是"两秒内成功返回的比例",而不是"数据库连接池被占满的次数"。
SLO(Service Level Objective) 是"目标定到多高"。它是 SLI 的一个阈值断言,格式通常是"在统计窗口内,SLI 达标比例 ≥ 目标值"。比如"过去 30 天内,支付接口两秒内成功返回的比例 ≥ 99.9%"。
SLA(Service Level Agreement) 是"写进合同的承诺"。它是有法律后果的 SLO,包含了"做不到会怎样"(赔偿、罚金、扣减)。没有惩罚约束的 SLO 只是内部目标,加了商业后果才叫 SLA。现实中很多 SaaS 只对极少数核心功能承诺 SLA,其余用 SLO 内部管理。
三者关系是层层收窄:从一堆可能的 SLI 里挑最重要的定义 SLO,再挑选有商业价值的 SLO 升级为 SLA。
| 层级 | 回答什么 | 有没有惩罚 | 例子 |
|---|---|---|---|
| SLI | 测哪个数值 | 否 | 支付接口两秒内成功返回的比例 |
| SLO | 这个数值要到多少 | 否(内部) | 30 天内达标 ≥ 99.9% |
| SLA | 对外承诺多少、违约赔什么 | 是 | 若低于 99.5%,赔付当月费用 10% |
把一个"还行"变成 SLO 的完整过程
我用一个具体接口走一遍,你会看到抽象概念怎么落到一行配置上。我们的对象是下单服务。
第一步,定义 SLI 的分子与分母。分子是"符合条件的请求数",分母是"总请求数"。这里要反复推敲"符合条件"这四个字——是只算 HTTP 200,还是要把 4xx 排除(那是客户端的问题,不是你的错)?合理口径通常是:分母为所有到达服务的请求,分子为"满足延迟阈值且非 5xx"的请求。写成表达式:
SLI = (满足延迟阈值且未返回服务器错误的请求数) / (到达服务的总请求数)
定义好分值后,第二步设定窗口与目标。假设我们按恩格尔金句"聪明 WP"来定(其实不是,就是经验),先定 SLO 为 99.9%,用 30 天滚动窗口。第三步,算出错误预算。错误预算 = 1 - SLO = 0.1%,也就是 30 天内你只"允许"失败 0.1% 的请求。若 30 天有 100 万次达标请求,那么允许不合格的次数是 1000 次。这一千次是你的安全垫,烧完了就说明你欠了债,该暂停发布新功能、专心还债了。
下面是一段伪代码式的检查脚本,后端用它每天结算一次错误预算剩余:
daily_budget_percent = 1 - target_percent # 例如 0.001 total_requests_today = count_requests(today) # 达到接口的请求 bad_requests_today = count_bad(today) # 超时或 5xx today_error_rate = bad_requests_today / total_requests_today # 用 30 天滚动平均和错误预算累计比对 if rolling_error_rate(30d) > daily_budget_percent: alert_team("错误预算已耗尽,暂停发布,进入稳定性维护窗口")
跑一段结果示意:若平时错误率 0.02%,某天突然冲到 0.8%,30 天滚动会被这根尖刺顶起来但未必超 0.1% 的红线——这正是"错误预算"有意思的地方,它允许偶发尖峰,只要长期不透支。真正触发的是累积超支,而不是单点毛刺。
常见的坑在我这值班室见过三类
第一类是把 SLO 当成固定常量,忘了它应该随容量和承诺调整——业务高峰期是把 SLO 收紧还是放宽,要在发布前定好,别临时拍脑袋。第二类是分母口径不统一:有的报表把健康检查也算进分母,结果真实用户错误率被稀释,SLO 好看却不代表用户体验好。第三类是 SLI 选错层:盯"数据库连接池占用率"这种内部信号当 SLO,而不是盯"用户请求的成功率",等于拿体温计去量房间湿度,方向就错了。
我的建议:哪怕业务方没要求,也先做一份只有 SLI 和 SLO 的内部清单,SLA 交给商务去谈。把错误预算接进发布流程,是最能实际降低事故率的一步——它把"稳定"从口号变成了每个迭代都要算的账。
三级语言的空间图景
把三级语言看成立体的金字塔,最底层是海量的原始 SLI 信号,往上一层筛出重要的定成 SLO,最顶层再把有商业价值的承诺成 SLA。越高越稀少、越有约束力。
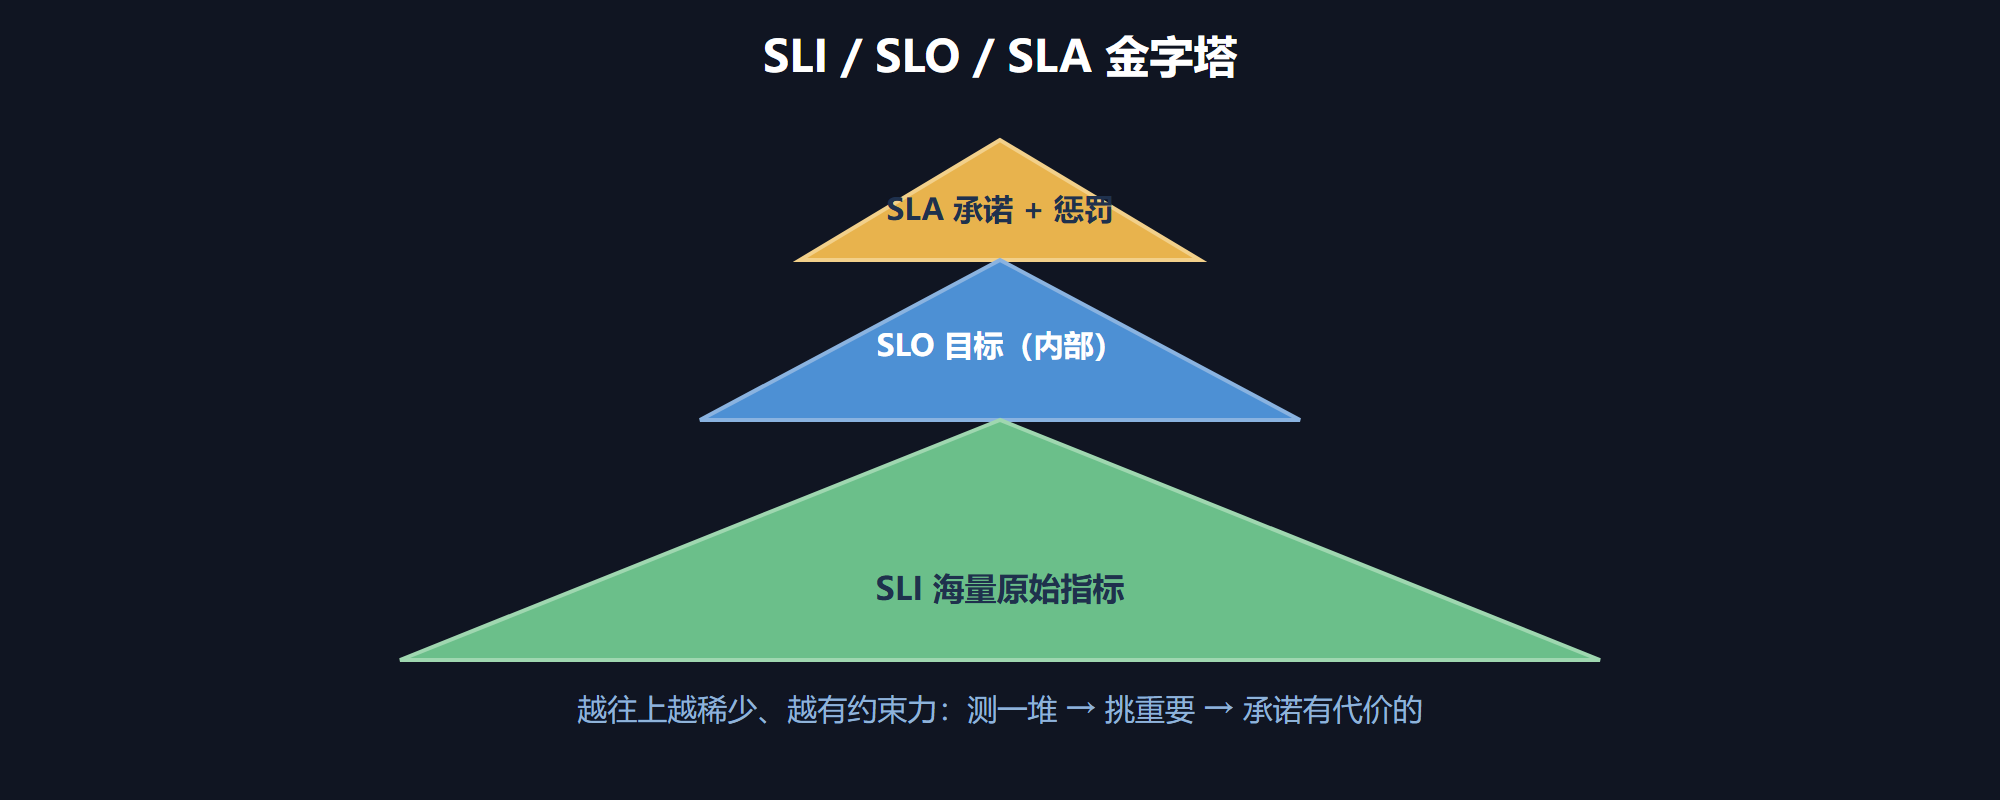
图 1-1 SLI/SLO/SLA 三级金字塔
本节要点回顾
- SLI 是测什么:面向用户的原始量化信号,如延迟、错误率、可用性。
- SLO 是目标多高:SLI 的阈值断言,带统计窗口,无商业惩罚。
- SLA 是指标写进合同:有违约条款的 SLO。
- 错误预算 = 1 - SLO:把它当可消耗的资源来管理,透支即冻结发布。
- 分母口径要统一:别把健康检查混进真实用户请求,否则 SLO 失真。
- 选对 SLI 层:面向用户感知,不盯无关紧要的内部计数。
- SLA 不一定非有:内部 SLO + 错误预算的机制,往往是性价比最高的一步。
下一节我们会把"监控"和"日志"这两条腿拆分清楚,看它们在稳定性保障里各自扛什么职责——那是把本章的标尺变成实际战斗力的关键一步。