1.2 监控与日志在稳定性中的分工
1.2 监控与日志在稳定性中的分工
本节摘要:监控和日志是两条腿,但很多人把它们当同一种东西替换着用。本节讲清它们在一次事故里截然不同的角色——监控是提前放哨的前哨,日志是事后破案的战史,并给出"为什么告警不可信于日志、为什么日志替代不了监控"的判断依据,附一个前后端配合的完整排查案例。
一个把日志当监控用的失败现场
先说反例。有个团队觉得"我们日志打得够多了,不需要监控",于是在流量高了才知道有问题,还是因为用户投诉。等他们被叫起来看日志,才发现 CPU 已经烧了两小时。为什么日志没提前提醒他们?因为日志是被动记录,你来查询才知道有问题;而且日志量大到要捞半天才能拎出关键行。这就是"日志当监控用"的代价:它不是实时报警器,是事后才能翻的账本。
反过来还有一个反例:认为"有监控就不需要日志了"。监控告警说"内存涨了",但说不出为什么涨、是哪个对象在涨、用户受影响的是哪一笔请求——这些信息监控给不了,只有日志里的堆栈、错误码、请求上下文能给。两条腿必须分开理解,才能合着装。
它们是两种完全不同的信号
监控的本质是一组持续采样的量化流。它把"系统健康"压成一条随时间变化的曲线,适合回答"趋势、速率、阈值",能在问题冒头的第一秒就给你打铃。代价是它丢弃了细节——你只知道曲线拐了,不知道拐弯背后的具体原因。
日志的本质是一系列离散的结构化事件。每一条都是"某一时刻、某一进程、发生了什么"的定格,保留了上下文、报错、堆栈。它能帮你在监控喊停之后做根因分析,但它是被动等待查询的,本身不懂预警。
一句话分功:监控负责"什么时候报警",日志负责"报警之后查什么"。
| 维度 | 监控(前哨) | 日志(战史) |
|---|---|---|
| 数据类型 | 采样后的数值流 | 离散事件记录 |
| 核心问题 | 现在哪里不对劲 | 为什么变成这样 |
| 主动性 | 主动告警 | 被动查询 |
| 粒度 | 聚合、趋势 | 单条、上下文 |
| 主要载体 | 指标的时序库 | 日志的检索平台 |
一场完整事故里它们怎么接力
我把一场真实点到为止的排查走给你看,注意两条腿交替用。
背景:一个在线订座系统,凌晨分批任务跑批。监控面板上一根叫"批处理耗时"的指标在某天突然爬高两倍,但没有触发硬告警(阈值定在 3 倍)。第一步,我们用监控定位病区:细分到各个子服务的耗时曲线,发现只有"座位占用快照"子任务在爬。第二步,切换日志:去日志平台查这个子任务今天凌晨的 error 级记录,果然有一条"Redis 连接池取连接超时"反复出现。第三步,回看监控补一段关联:同一时间窗内"Redis 内存使用率"曲线冲到 92%,"每秒写放大"同步升高。于是根因链条清晰了:Redis 内存高水位 → 缓存淘汰频繁 → 快照任务写放大 → 连接等待超时 → 任务耗时翻倍。第四步,验证:扩容 Redis 后同一批任务次日回归正常。
这场接力揭示了轻重的次序:监控先把嫌疑圈到一个最小范围,日志在圈内给罪证。全程监控的"耗时指标"帮我们把 100 个服务缩到 1 个子任务,这是纯日志做不到的(你不可能把一百个服务的日志都翻一遍);而日志给了监控给不了的"为什么超时"——这是纯监控做不到的。
分工之外还有一条暗线:链路追踪
严格说不止两条腿,还有第三条——链路追踪。它把一次横跨多个服务的请求串成一条完整的调用记录,相当于给"战史"每一条事件都贴了同一笔交易的路由号。这样当监控告警"下单失败率升高"时,日志平台里同一根 trace ID 能一口气捞出这笔请求在每个环节的耗时与状态。它在本章三支柱里有专门一节,这里先点明:它是让监控和日志"对得上号"的胶水。
我的经验:新团队最容易出错的地方是让监控做了日志的事(把每个模块的细节指标全堆上去,面板爆炸),或者让日志扛监控的责任(报警靠人去翻日志)。先把分工图钉死,再谈深度。
分工的昼夜时间线
把这场事故摊到一条昼夜时间线上看,监控每天在暗处持续放哨,日志在每笔经过时留档,真出事那刻,两个渠道同时被点亮。
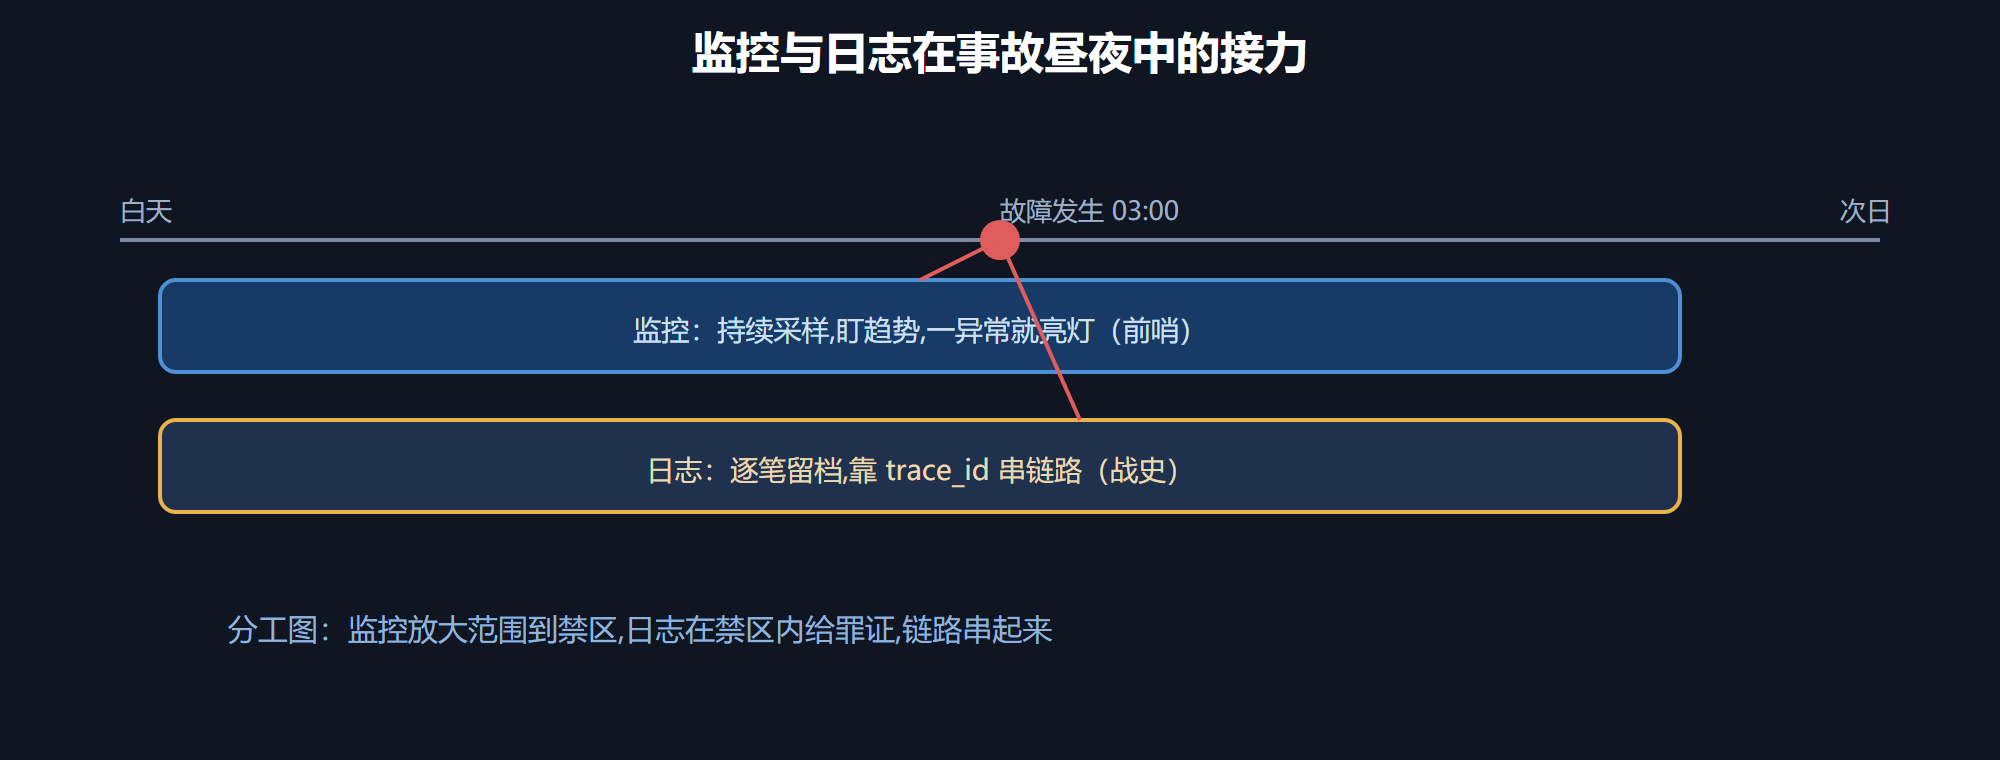
图 1-2 监控与日志的昼夜接力时间线
最容易踩的两个分工坑
第一个坑叫"日志当告警线":运维人员觉得日志里都有了,没必要再搭指标和告警,结果出问题全靠用户投诉。用户已经骂上门,你才翻日志找线索——这种时差对于支付、交易这类核心业务,真扛不起。
第二个坑叫"把细节全压去指标里":每个函数、每个模块都加一个指标,结果 Prometheus 内存直接爆了,面板上堆着几千个指标,真出问题值班人一眼找不到谁红了。正确做法,就是把"聚合、趋势、阈值"留在指标层,把"具体细节、上下文、堆栈"扔给日志层——各归其位,别跨界抢活。
第三个小坑:不同步 trace ID。指标说错了率,日志说堆栈在哪,但不知道这堆错对应哪一批请求、哪一笔业务,拼不起来就是一盘散沙。所以哪怕早期链路没铺开,也得给每个请求打一个统一的 trace ID 同时落进日志和指标标签里。这个小习惯,关键时刻能省你两小时排查。
本节要点回顾
- 监控是前哨:持续采样的数值流,主动告警,回答"哪里不对劲"。
- 日志是战史:离散事件记录,被动查询,回答"为什么变成这样"。
- 推荐次序:监控缩范围,日志给罪证,链路串全链路。
- 监控告警有限:只能告诉你曲线拐了,给不了拐弯的原因。
- 日志无法预警:它是事后账本,不能替代实时报警。
- 链接是胶水:让告警和日志能对得上同一笔请求。
- 别互相替代:两条腿是配合关系,不是二选一。
这一章第三节要做的,是把"前哨 + 战史"升级成"可观测性三支柱",讲清为什么在大型分布式系统里只有两腿不够,还需要一根追踪的脊梁。