1.3 从传统监控到可观测性三支柱
1.3 从传统监控到可观测性三支柱
本节摘要:传统监控的局限在于它只防"你预先想到的故障",对"未知未知"无能为力。可观测性(Observability)则是一整套让系统自我解释的能力,由指标、日志、链路追踪三支柱构成。本节用区分"输入输出"与"内部状态"的思路,讲清它们的采样差异、互补关系,并给一张三支柱的取值预算分配表。
监控的盲区:它只会查你想问的问题
传统监控的运作方式是"先列一张清单,再对着清单查"。你预判 CPU 可能爆、内存可能涨、磁盘可能满,于是给它们各画一条阈值。这套思路在十年前够用——故障就那么几十种,预判能覆盖大半。但今天微服务拆到几十上百个,故障往往来自你从没列入清单的组合:某个依赖在特定流量下才出现的内存抖、某个竞态只在大促时触发。你没法把没想过的问题写进告警规则,这正是传统监控的结构性盲区——业内叫"已知的未知"。可观测性要解决的,正是"未知的未知":你并不知道该问什么问题,但数据已经躺在那里,只是缺少把它问出来的通道。
用一套更直白的对比来锚定差异:传统监控是"你来提问它来答",可观测性是"它始终把能答题的原始资料摊在桌上"。前者把系统压成几条曲线,后者尽量保留判断上下文所需的真相。
三支柱:三种看世界的棱镜
可观测性公认的三支柱是 Metrics、Logs、Traces,中文即指标、日志、链路追踪。它们不是三种多余的格式,而是观察同一个系统的三种棱镜,侧重点完全不同。
指标 Metrics 是聚合后的数值流(QPS、延迟分位、错误数)。它采样成本低、存储紧凑、适合做成曲线和告警。代价是丢了单个事件的上下文——你知道延迟 P99 是 500 毫秒,却不知道是哪一个请求这么慢。
日志 Logs 是离散事件(每一条带时间戳、级别、内容的记录)。它保留了细节和上下文,能还原"那一刻发生了啥",但量巨大、检索慢,且只有你主动查它才开口。
链路追踪 Traces 是一个请求横跨多服务的完整路径(一串 span 组成一条 trace)。它把散落在各服务的日志、指标按同一笔业务串联起来,最适合回答"这笔请求到底卡在哪个环节"。
三者常被姓名的长度排序(Tracing > Metrics > Logging 的体积量级),但更重要的是它们的互补:指标告诉你"系统整体在恶化",日志告诉你"具体症状是什么",追踪告诉你"这笔特定的交易葬在了哪"。真正的最佳实践是让三者的采样相关(同一个 trace ID 同时出现在日志与指标里),这样从任意一方都能起手,顺藤摸瓜到其他两方。
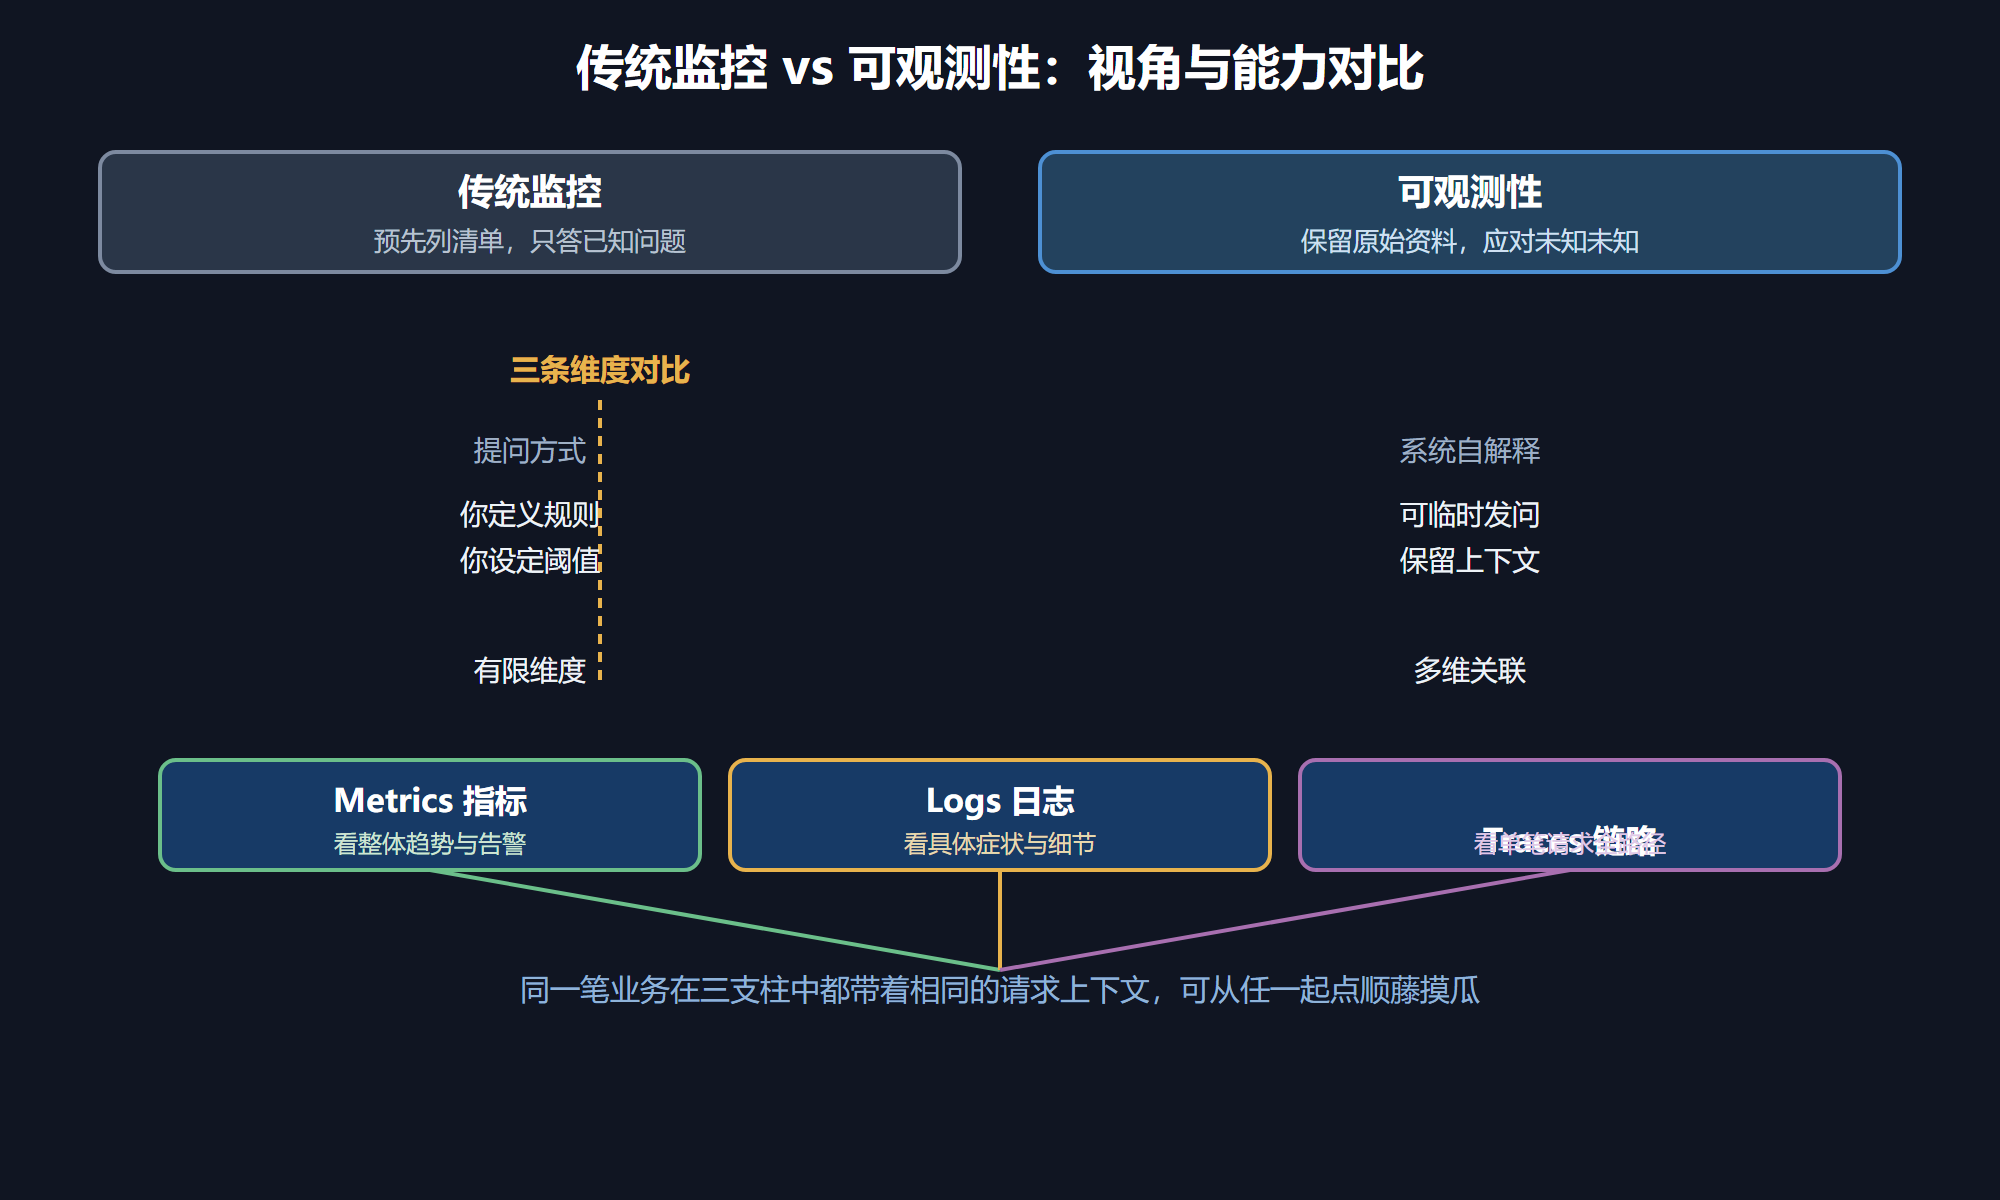
图 1-1 传统监控与可观测性视角对比
三支柱的采样本钱怎么分配
真正落地时,三支柱不是平均用力,而是按成本与回报配比。我给一个可复用的取值方法(当然,具体数字要按你的数据体量微调)。
指标:全量采样,存储最省。因为指标本身就是聚合,几百万个时间序列也就几个 TB。链路:采样一个比例,通常是全量"给错误和慢请求、节流给正常请求"——即对 P99 以上的慢请求和错误请求必采,对外围高速请求按比如 1:100 抽取,否则拿数据的成本会吃掉收益。日志:全量保留业务关键日志,运维/DEBUG 日志按滚动窗口保留并设配额,防止野日志把存储打爆。
| 支柱 | 采样策略 | 存储量级 | 主要用途 | 起手时的典型样例 |
|---|---|---|---|---|
| 指标 | 全量 | 小 | 告警、趋势、容量 | QPS、P99、错误率 |
| 日志 | 分级别配额 | 中到大 | 根因、审计、业务洞察 | 下单失败堆栈 |
| 链路 | 错误必采+高速抽采 | 中 | 定位瓶颈、跨服务诊断 | trace ID 完整调用链 |
我的判断:别一上来就追求"全可观测",那是存储与成本的灾难。先保证指标全量、错误与慢请求的链路必采、业务日志全量,这条起步线已经能覆盖 80% 的排障需要。等系统稳定、预算宽裕,再逐步放大正常请求的链路采样率。
一个"未知未知"的真实剧本
讲个比 CPU 爆更能说明问题的例子。某次大促,下单接口偶发超时,但 CPU、内存、QPS 全部正常,惯例里那些告警一个都没响。值班人愣在原地——他不知道该监视什么,因为问题不在任何一张预先列好的清单里。后来靠链路追踪,发现慢的请求都经过了一个"库存预占"的远程服务,而对这类依赖,团队压根没配指标。它平时贡献不到 1% 的流量,大促时才被放大。这正是可观测性的意义:不是多配几条规则,而是让"你没预见到的那类故障"也能在数据里被看见、被追问。这与传统监控"我预判什么才能看到什么"构成最本质的分野。
三条支点怎么相互"对表"
三支柱能协同,靠的是同一套坐标。时间戳要对齐到毫秒级, trace ID 要贯穿日志与指标,服务的节点标识(labels/服务名)要统一。我见过一个"指标和日志口径对不上"的团队:指标的"下单失败"包含了限流失败,日志的"下单失败"却只算业务异常,两边数字永远差一截。这就是没有统一口径。落地建议:在写入阶段就约定一套 skel字段清单,指标、日志、链路必须共用同一套业务字段(订单号、trace ID、节点),这样任何一方起手都能顺藤摸到另外两方。这套清单别等系统大了再补,越小越早定,后期对齐的改造成本就越低。它也意味着,你开任何一个观测入口,其余几个都能作为旁证跟上,排障时就不必在一堆孤岛里反复横跳。
本节要点回顾
- 传统监控的边界:只答预先列好的问题,对付不了未知未知。
- 可观测性的核心:系统具备自我解释能力,数据随取随用。
- 三支柱互补:指标看整体、日志看症状、链路看单笔路径。
- 指标最省:全量采样,存储紧凑;链路与日志是大头。
- 链路采样有讲究:错误与慢请求必采,正常请求节流。
- 日志按级别配额:业务日志保全量,DEBUG 日志滚动限流。
- 起步配比:指标全量 + 关键链路必采 + 业务日志全量,先求够用再求全。
概念地基打到这里。下一章我们要把"监控前哨"做实——指标怎么分层、怎么收集、存到哪、怎么摆上仪表盘,正是第二章的责任。