2.2 关键指标与黄金信号
2.2 关键指标与黄金信号
本节摘要:指标类型有很多——性能、资源、错误、吞吐量、延迟,但真正面向用户的系统只需要四个黄金信号:延迟、流量、错误、饱和度。本节先给出指标的五种分类直觉,再聚焦黄金信号与 RED 方法,最后用"如何给一个支付服务选四个黄金信号并写告警阈值"做完整演练,附分位延迟的正确读法。
不要被指标数量压垮
一上来就全量堆指标是监控建设的第一大忌。当我建议某团队上线时才几十个指标,他们要塞进两三百个,结果面板挤成马赛克,每个阈值都是拍脑袋,运营一个月把值班人折腾到离职,最后不得不全部砍掉重来。真相是:大多数服务,真正扛起责任的关键指标不超过二十个,而其中最能反映健康的是四个玩家:延迟、流量、错误、饱和度。它们来自 Google SRE 的黄金信号(Golden Signals),适用于任何面向用户的系统。
在进入黄金信号前,先建立指标类型的地图。指标分为五类,各有各的性格:
- 性能指标:描述"快不快、顺不顺",如响应时间、吞吐量、GC 停顿。
- 资源指标:描述"够不够用",如 CPU、内存、磁盘、连接池。
- 错误指标:描述"坏了多少",如错误率、异常次数、失败比例。
- 吞吐量指标:描述"干了多少活",如 QPS、RPS、并发数。
- 延迟指标:描述"等了多久",如 P50、P95、P99 分位延迟。
黄金信号:系统的四个基本面
Google SRE 告诉我们,黄金信号用来在高层级上评估系统是否健康,四个信号分别是:
延迟 Latency:请求花多久才被处理完。永远用分位,不要用平均值。平均值会把一个"偶发 P99 十秒"稀释成"均值三百毫秒"的好看数字,而真实用户正卡在十秒上。正确读法:看 P95 和 P99,它们是真实长尾用户的体验。
流量 Traffic:系统承载了多少业务负载,最常见是 QPS(每秒请求数)。流量反映系统在承受多大压力,也常是判断"这是故障还是高峰"的第一手证据——流量翻了十倍,告警多半来自过载而非代码坏了。
错误 Errors:请求失败的占比与数量。要分两类统计:显式失败(HTTP 5xx、应用抛异常)和隐式失败(返回 200 但内容不对、副本超时但重试成功掩盖了)。隐式错误最阴险,因为它不触发普通告警,但真实影响用户。
饱和度 Saturation:系统还有多少余量。通常看资源利用率逼近上限的程度,CPU 使用率、内存占用、连接池占用率、磁盘延迟的上升都是饱和度信号。核心洞察:饱和度接近 100% 时系统进入退化模式,性能崩塌往往不是线性而是断崖,所以要在离上限还有距离时就动手扩容。
RED:微服务的三件套
如果只给微服务里的单个服务设定告警,还有一个简化版叫 RED 方法,三个信号各取一字:速率 Rate(每秒请求量)、错误 Errors(每秒错误数)、时长 Duration(请求持续时长)。它其实就是黄金信号砍掉了"饱和度"(因为单个服务的饱和度可以从资源层看),专注三个直接可测的行为信号。
| 方法论 | 关注信号 | 适合场景 |
|---|---|---|
| 黄金信号 | 延迟+流量+错误+饱和度 | 面向用户的高层系统健康 |
| RED | 速率+错误+时长 | 单个微服务行为观测 |
| USE | 使用率+饱和度+错误 | 资源/硬件角度观测 |
USE(Utilization、Saturation、Error)是又一个常用方法论,它更适合从资源角度观察:某个资源用了多少、饱和了没、有没有出错。三种方法论不是互相打架,而是视角不同,实践中常常组合用:业务看黄金,单服务看 RED,资源看 USE。
演练:给支付服务挑四个黄金信号
我们把理论做成一次完整的选信号演练,对象是一个支付网关。
第一步,确定延迟信号:取"支付请求从进入服务到返回"的 P99 延迟,阈值设为 2 秒——超过即为目标破坏。为什么用 P99 而不是 P95?支付是用户感知极强的业务,长尾体验必须锁死。用一段 PromQL 风格表达(不纠结语法,看逻辑):
# 支付请求处理时长 P99,指标维度 label user_endpoint=pay histogram_quantile(0.99, sum(rate(http_request_duration_seconds_bucket{...}[5m])) by (le))
第二步,确定流量信号:取"支付请求 QPS",不设硬告警而是设变化率告警——比如 QPS 五分钟内的相对变化超过 200% 才告警。这样既能发现流量突变(可能是刷单、攻击、渠道异常),又不至于在正常双十一高峰误报。
第三步,确定错误信号:取"支付失败率",阈值 5%。失败率一跳过 5% 说明支付链路出了问题,这是最该被凌晨叫醒的信号之一。
第四步,确定饱和度信号:取"支付服务所在主机的 CPU 使用率"与"数据库连接池占用率",CPU 阈值 80%、连接池 85%。这两个是预警信号,早于用户可感知的延迟恶化。
把四个信号连同阈值随手算一遍,给它一条结论:这套三件套能在"流量突变、声音异常、资源吃紧、长尾变慢"四类问题刚露头时就把值班人叫起来。剩下的则是锦上添花。
分位延迟的正确读法
最后补一个高频易错点。分位延迟取法有讲究:P99 含义是"99% 的请求比这个值快",它滤掉了最慢的 1% 里那种极端噪声样本;但即便这样,P99 也可能被个别天价慢请求抬高。更稳的方法是与 P95、P50 一起画,观察三者是否同步抬升——如果 P50 和 P95 都在涨,那是有普遍性的退化;如果只有 P99 突兀地立起来,多半是个别异常请求在干扰,不必过度紧张。
我的建议:指标宁少勿滥,黄金信号四件套必须先建立,再谈锦上添花。一次只为一个核心业务路径上桩,验证阈值会叫而且不误叫,再向其它路径铺开。
黄金信号的四角桅杆
把四个黄金信号想象成给一艘船立起的四根桅杆,任何一根断裂都意味着船要失控。
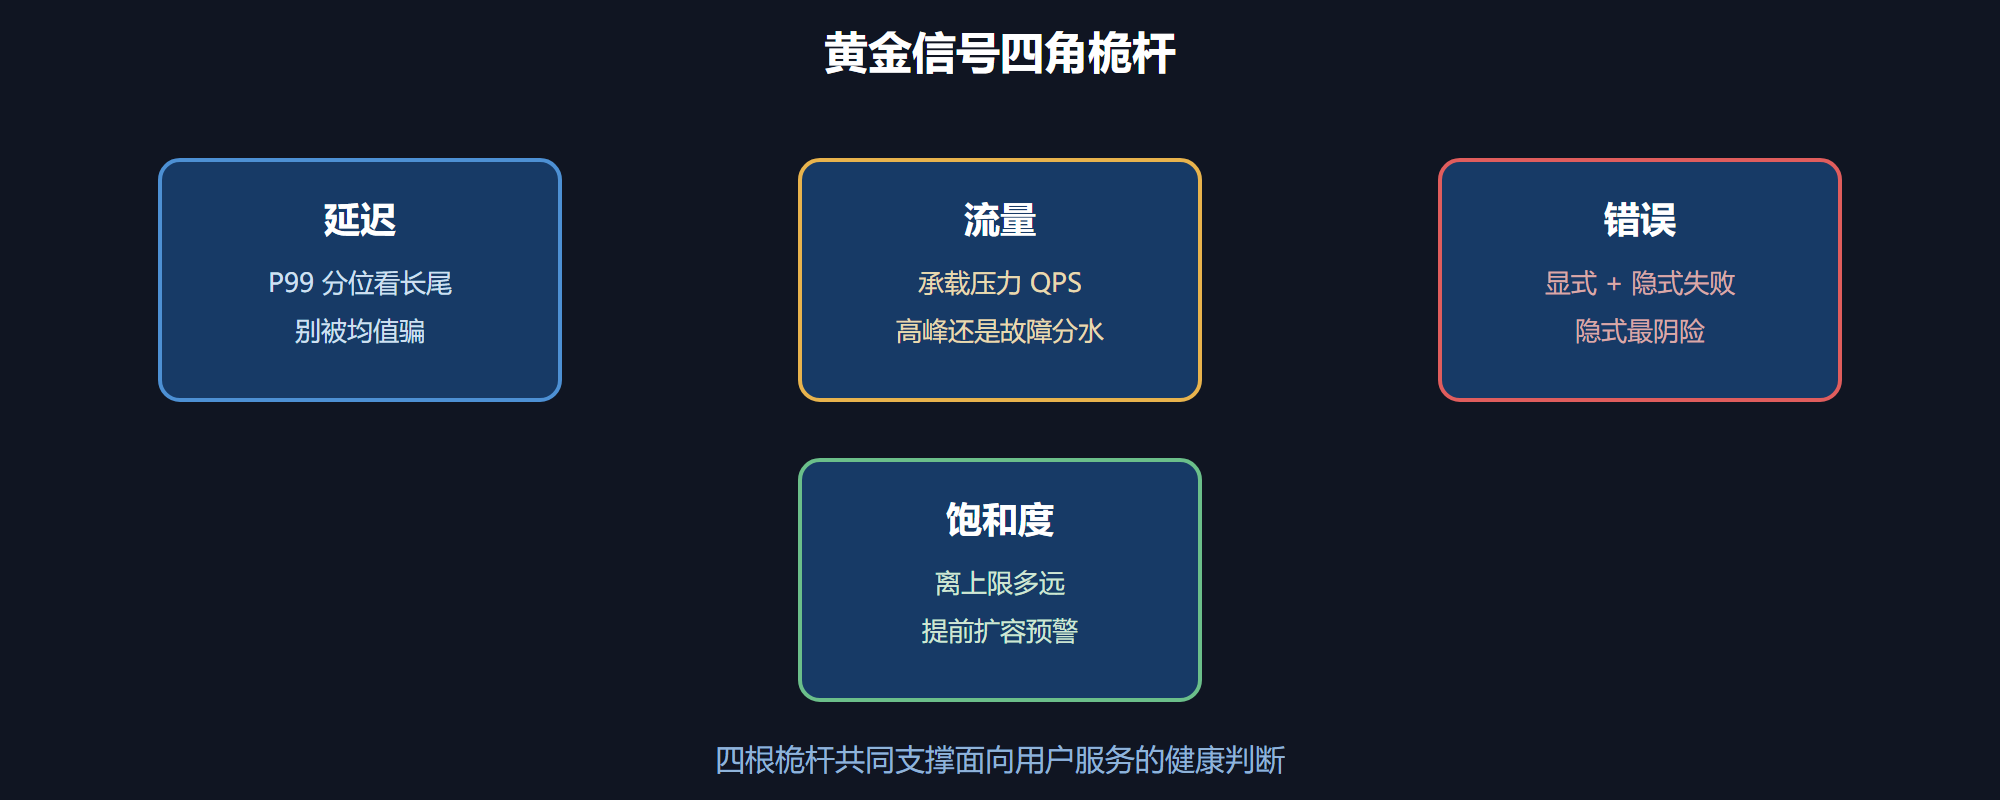
图 2-2 黄金信号四角桅杆
本节要点回顾
- 指标五类:性能、资源、错误、吞吐量、延迟,各有分工。
- 黄金信号四件套:延迟、流量、错误、饱和度,高层判断健康。
- 延迟永远看分位:P99 反映真实长尾,别被均值欺骗。
- 错误分显隐:隐式错误最阴险,检测不能只看状态码。
- 饱和度是预警:接近 100% 才 action 就晚了,留足余量。
- RED/ USE 补充视角:单服务看 RED,资源看 USE,组合使用。
- 阈值要会叫且不误叫:一个核心路径一次只上四件套,验证后再铺开。
这一节把"看什么"定死了。下一节回答"怎么把这些数值拿到监控系统手里"——采集方式的选择,是从思路走向落地的第一块砖。