2.3 指标采集方式:Agent、Exporter、SDK、API
2.3 指标采集方式:Agent、Exporter、SDK、API
本节摘要:指标要被系统看见,总得有一条路从进程内存走到监控系统。走哪条路取决于你采什么对象:从操作系统拿指标走 Agent,从第三方服务拿指标走 Exporter,从应用内拿深度指标走 SDK,最后 Push 拉 Pull 两种采样模式各有适用场景。本节把四条采集路径拆解清楚,每种给一个例子,最后对比 Pull 与 Push 的优劣,让你选路不纠结。
一句话给四条路划边界
我整理一句让你十秒选对路的总结:
- Agent:宿主机/容器侧跑,主动扒拉操作系统和基础设施的指标,推给后端。适用:CPU、内存、磁盘、网络这类基础设施层采集。
- Exporter:独立进程,专门扒拉第三方服务(数据库、缓存、消息队列)的指标,把它们转成标准格式暴露给 Pull。适用:MySQL、Redis 这类你没改代码的第三方服务。
- SDK:嵌在你自己的应用代码里,直接生成并暴露指标。适用:应用内的业务、性能指标。
- API 拉取:后端监控系统直接调用服务暴露的 HTTP 接口拉指标,不需要额外进程。适用:服务本身已经能输出标准格式指标。
下面逐个拆开讲,每个都给真实例子。
Agent 采集:操作系统与基础设施的主力
Agent 跑在每台主机/每个节点上,它的任务就是爬操作系统的 proc 文件系统、读取各种 stats 文件,把 CPU、内存、磁盘这些底层指标给摘出来,发给监控系统。这是最成熟的路线,几乎所有成熟监控系统都这么做。
举个例子:Prometheus 生态里最常用的 Node Exporter,本质就是一个 Agent,它监听 HTTP 端口,把节点上所有的 CPU、内存、磁盘、网络指标都用 Prometheus 格式暴露出去,让 Prometheus 定时拉。传统监控如 Zabbix 也有 zabbix-agent 做一样的事。
优点:不需要改应用代码就能拿基础设施指标;统一采集路径,不用每个服务自己处理网络和推送;节点挂了能从采集超时直接判断节点不可达。缺点:得在每个节点跑一个进程,多一个维护项;容器环境需要处理容器隔离维度,不然拿到的是宿主机总和。
我的判断:基础设施层必用 Agent/Exporter,不要让应用代码去爬 proc——代码耦合不说,权限也难控。
Exporter 专项采集:第三方服务指标转换器
第三方服务比如 MySQL、Redis、Elasticsearch,它们本身不会暴露 Prometheus 格式的指标,所以需要一个"翻译"把内部状态翻成标准指标。这个翻译就是 Exporter。
例如 mysqld_exporter,它会连你的 MySQL,定期跑 SHOW GLOBAL STATUS 拿各种 internal 状态,把它们转成 Prometheus 能拉的指标格式。Redis 有 redis_exporter,MongoDB 有 mongodb_exporter,依此类推。每个主流服务都有现成 Exporter,不用自己写。
Exporter 和 Agent 的区别:Agent 管操作系统,Exporter 管某个特定服务。很多时候 Exporter 跑在和服务同节点,也可以集中跑(比如你有一堆 MySQL,一个 Exporter 搞定所有),看你架构怎么选。
SDK 嵌入:应用自己曝指标
如果指标是应用内部的,比如你想曝自己业务的支付成功率、用户下单量,那最好的办法就是在应用代码里嵌 SDK,SDK 负责生成指标、维护维度,然后暴露给 Pull。
Prometheus 官方对各种语言都有 client SDK,Go、Java、Python、Node.js 一应俱全。你只需要在代码里定义一个 Counter 或者 Histogram,请求进来调用一下 Inc(),SDK 自动累加和分桶。最后暴露一个 /metrics HTTP 端点,Prometheus 定时拉就行。
优点:拿到最细粒度的业务指标,什么维度都能加;不用额外进程,和应用生命周期绑定;格式标准,不用自己处理。缺点:需要改应用代码,要发布才能加新指标;语言依赖,每个语言一套 SDK。
采集模型:Pull vs Push
关于 Pull 和 Push,行业打了很多年,各有各的道理,记住适用场景就行:
Pull 拉模式:监控系统(比如 Prometheus Server)主动定时到每个目标端点拉指标。典型代表就是 Prometheus。优点:监控中心统一控制采集节奏,知道哪些节点活着(拉不到就是死了);不用配置对监控中心的网络出口(只要监控中心能进来就行)。缺点:如果端点在 NAT 后面,监控中心连不进来就得打洞;大规模场景下,拉的并发压力都在中心。
Push 推模式:采集端主动把指标推给监控中心。典型代表就是 Pushgateway、Graphite、InfluxDB。优点:不用监控中心连进来,端点在私有网络也能推;采集端自己控节奏。缺点:监控中心没法通过"收不到"判断端点挂了(端点可能网络断了推不出来)。
什么时候选什么?
- 长期稳定运行的服务/节点:用 Pull,监控中心知道谁死谁活。
- 批处理任务、短生命周期任务:任务跑完就没了,用 Push 把最后的指标推走,不然 Pull 还没拉任务就结束了。
- NAT 后面、私有网络里,监控中心连不进来:用 Push。
Pull 是常态,Push 是例外。绝大多数生产环境都以 Pull 为主,特殊场景补 Push。
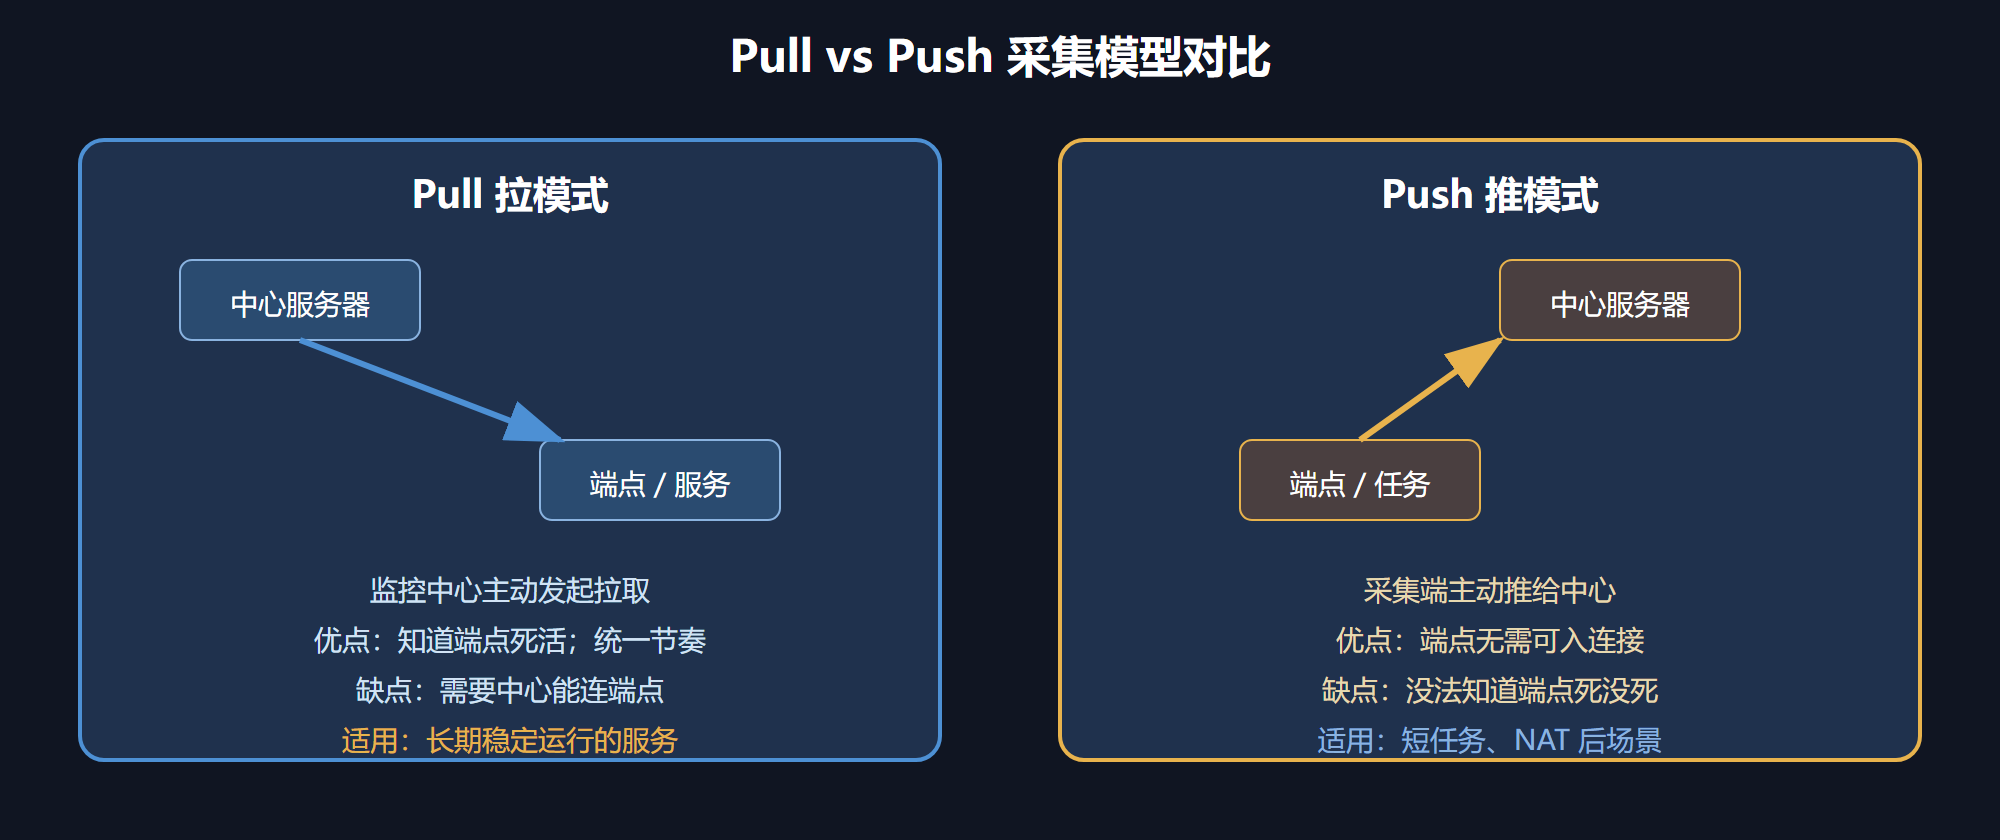
图 2-1 Pull 与 Push 两种采集模型流向
本节要点回顾
- 四条采集路:Agent 管基础设施,Exporter 转第三方,SDK 嵌应用,API 直接拉。
- Agent 天生适合基础设施:不用改代码,统一爬底层。
- Exporter 是翻译官:把第三方服务的指标转成标准格式。
- SDK 拿最细业务指标:嵌到代码里,想加什么维度加什么。
- Pull 主动拉是常态:适合长期运行服务,能判断节点死活。
- Push 主动推是例外:适合短任务、NAT 后,不能靠它判断死活。
- 场景说话:大部分环境以 Pull 为主,特殊场景补 Push。
拿到指标就得存下来。下一节讲时序数据库——这是指标的最终归宿,为什么普通关系数据库存不了时间序列,时序库做了什么优化。