4.1 告警规则设计
4.1 告警规则设计
本节摘要:告警规则是"异常对应处理"的翻译器,但绝大多数系统败在规则设计瞎拍脑袋:阈值拍死、趋势被周期性骗到、基线没跟上业务。本节给出从阈值告警、趋势告警、基线告警到异常检测的递进方法论,附三种典型告警规则的写法与适用场景,并用"给接口延迟设计告警层次"做完整演练。
为什么拍脑袋的阈值总在演戏
我接手过一个系统的告警,它有两条规则:CPU 大于 90% 告警、错误率大于 5% 告警。结果呢?业务系统凌晨两点准时因为批处理跑满 CPU 而告警,值班人一周内被同一根曲线叫醒三次,从此对这条告警免疫。这就是"拍脑袋阈值"的典型死法:它不对准真实故障模式,而是对准一个拍出来的数字,于是"狼来了"。
告警规则的真正作用不是让系统在你设的阈值上响,而是让它在用户可感知的伤害出现之前提前响。设计的第一步是抛弃"给个数字"的思维,改成"对准用户可感知的症状"。
四种告警规则的演化
规则设计是从粗到精的演化,四种手段一层套一层:
阈值告警:定义一个固定阈值,超了就叫。最简单也最粗糙。适合那些"数值超过就是问题"的铁律型指标,比如磁盘使用率超过 90%、连接池占用率超过 95%。问题在于它不懂动环境——早晨九点的 80% 和凌晨两点的 80% 意义完全不同。
趋势告警:看的是"变化",不是"绝对值"。比如"请求量五分钟内增长 200%"或者"延迟持续上升达十几分钟"。趋势告警能抓住"缓慢爬升"这种阈值盯不出的钝刀子杀人,也能区分"流量高峰"和"故障"(看的是变化斜率而非绝对值)。代价是有延迟:它要累积一段时间才能判断,没法像阈值那样即时。
基线告警:用历史数据算出一个"这个时段本该是什么样",然后看实际偏离基线多远。比如"当前请求量相比同时段历史均值偏离超过三倍标准差"。基线的优势是能适配周期性业务——双十一和平日、白天和晚上的正常值都不一样,基线能自己调整。代价是维护:业务改版、人群突变会让基线失真,需要滚动更新。
异常检测:用统计或机器学习对指标做模型,检测出"不符合规律"的点,即使你从没定义"什么是正常"。它是最智能的,也是第五章 AIOps 的主场。代价是黑盒、可能漏报或误报,需要验证期内的人工校正。
| 规则类型 | 判断依据 | 优点 | 缺点 | 典型适用 |
|---|---|---|---|---|
| 阈值告警 | 固定数值 | 即时、简单 | 不懂动态环境 | 磁盘、连接池等铁律 |
| 趋势告警 | 变化率/斜率 | 抓缓慢爬升 | 有判断延迟 | 请求量突增、延迟缓增 |
| 基线告警 | 偏离历史 | 适配周期性 | 要维护基线 | 高峰/平峰差异大的业务 |
| 异常检测 | 统计模型 | 无需定义正常 | 黑盒需校正 | 复杂长尾、难定义阈值 |
给接口延迟设计一组告警
用"给接口 P99 延迟"做一次完整设计,你会看到四种手段怎么配合成台阶状。
第一步,为即时故障设阈值:P99 超过 2 秒且错误率超过 5%,告警级。这是强信号,即时触发,叫醒值班。
第二步,为钝刀子爬升设趋势:P99 连续 5 个采集周期持续上升 60% 才告警。有 5 分钟延迟换精度——因为真正的故障总会持续爬,而噪声往往是单个尖刺,5 分钟持续上升能滤掉大半噪声。
第三步,为周期业务设基线:用过去 30 天同时段的 P99 作为一个滚动基线,当前值偏离基线超过两倍标准差告警。这样早晨高峰正常的高延迟不会误报,因为基线本身就是高峰期水平。
第四步,再叠加:当 P99 阈值触发的告警,自动带出这段的原因分析和 trace 链接(能查到调用链里的慢环节),让值班人一接警就能开始排查而不是先找方向。
写出来就是一个伪代码的规则集:
rule latency-p999-threshold when histogram_quantile_p99(delay) > 2000ms and error_rate > 5% for 3m severity crit rule latency-p99-trend when rate_of_change(p99, 5m) > 60% for 5m severity warn rule latency-p99-baseline when p99 > rolling_baseline(30d, p99, same_hour) * (1 + 2std) for 5m severity warn
三条合起来你得到:即时强故障秒叫、慢性爬升准叫、周期性业务不误叫。同事再也不会在凌晨被同一根双十一正常曲线叫醒。
规则数量与阈值验证的运维功课
规则不是越多越好。我的建议是"宁少勿滥",一次只为一个核心业务路径设计几条关键规则,跑通验证后再铺开。日常要做的三件事:
- 定期复盘:每月的告警清单里,把"没导致任何处置动作"的告警挑出来,它们要么阈值失效要么该删。
- 验证阈值会叫且不误叫:找个低峰期故意触发一次,确认商品能到账;同时观察一周请假期,确认没有误报。
- 区分 P0/P1:规则背后要标注影响级别(下节讲),不同级别决定叫醒范围。
我的倾向:规则体系的成功不在于"多",而在于"每一刀都砍在真问题上"。把拍脑袋的规则删掉,把每一条规则的"它到底保护哪个用户可感知症状"写清楚,你就能慢慢攒出一套信得过的告警网。
四种规则的台阶布置
把四种规则摆成一级一级上升的台阶:从最贴地的阈值,到高中生鞥的趋势,再到自适应的基线,最高是模型化的异常检测。台阶越高越聪明,也越需要维护。
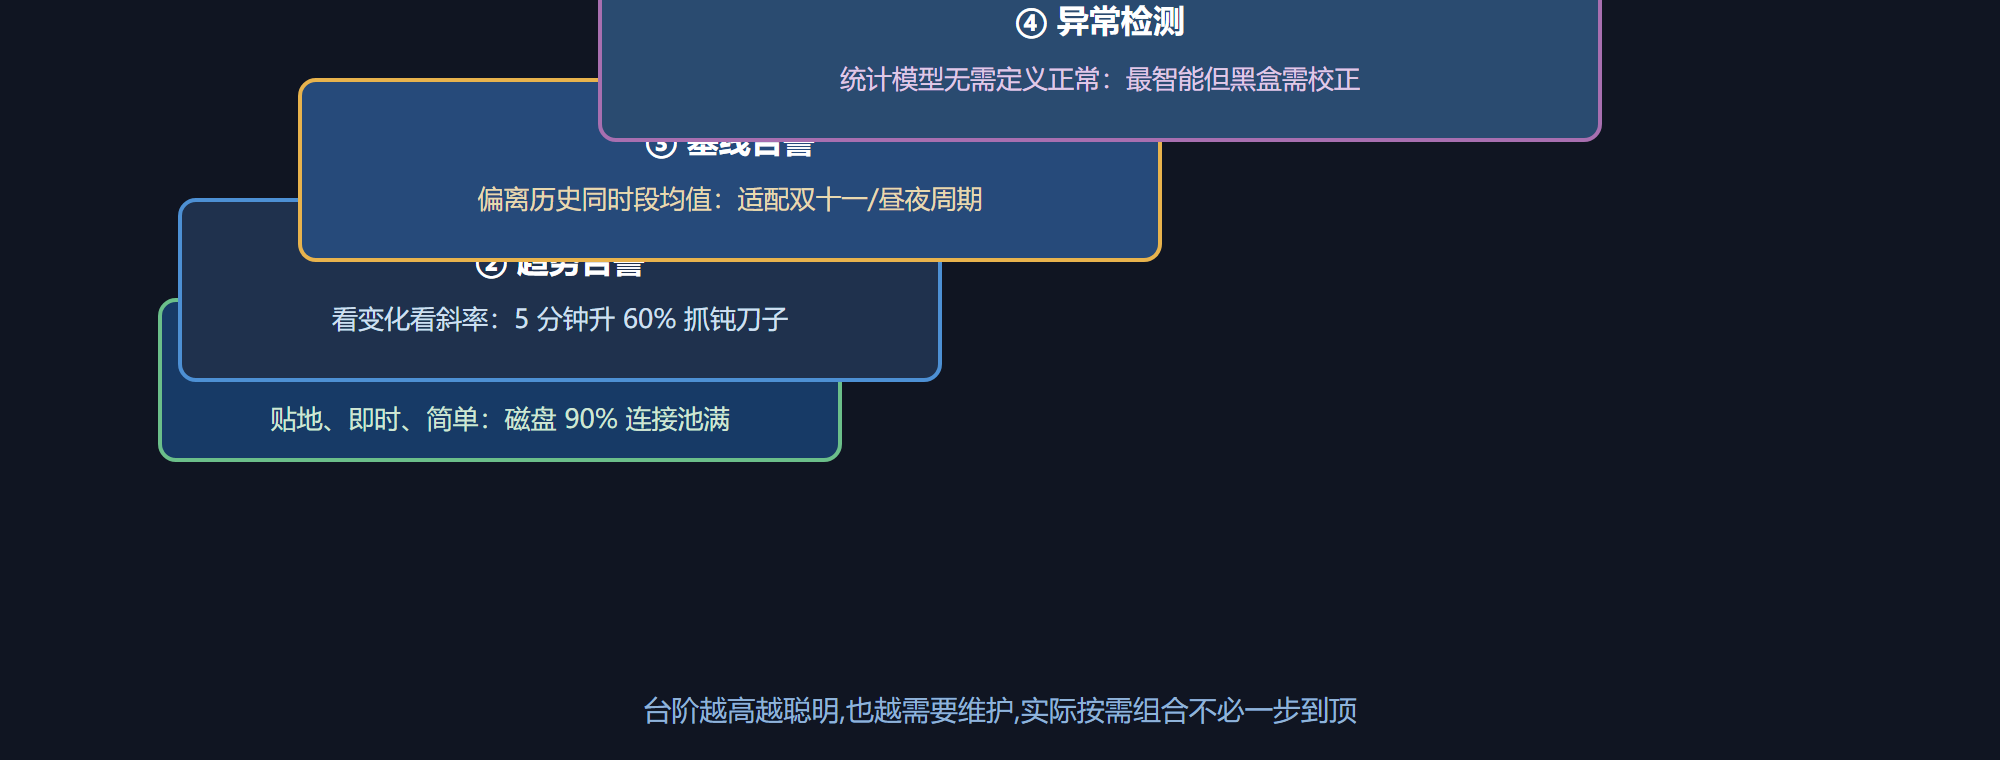
图 4-2 告警规则四级台阶
本节要点回顾
- 规则是对准症状,不是对准数字:保护"用户可感知的伤害"。
- 阈值贴铁律:磁盘、连接池这类超了就是问题。
- 趋势抓钝刀子:变化率能抓缓慢爬升,但有延迟。
- 基线适配周期:双十一、白日黑夜正常值不同,基线自己调。
- 异常检测最智能:无需定义正常,但黑盒需人工校正。
- 台阶式组合:即时阈值 + 慢性趋势 + 周期基线,一级一级补齐盲区。
- 宁少勿滥:定期复盘,删掉不干实事的告警,验证会叫且不误叫。
规则造出来了,要给它配上一个"多严重、谁来响应"的定性,那就是下一节讲的分级与优先级。