4.2 告警级别与优先级
4.2 告警级别与优先级
本节摘要:一条告警如果不说清楚"多严重、该谁处理、得多快处理",就只是一句无用的打扰。本节给出先按"影响范围 × 严重度"定级别、再按"级别 + 值班排班"定优先级的两步法,并拆解告警触达渠道(电话、IM、邮件、Webhook)与沉默期的设计。一个「同一事件 vs 共同调度」的编排点会帮你理顺不同级别该用哪种触达。
无级别的告警等于没有级别的打扰
有个真实对照:团队 A 的告警不分级,不管磁盘剩 10% 还是磁盘满 100%,全都往同一个 IM 群轰炸;团队 B 分级,只有 P0/P1 才打电话 P2 才进群。一个月下来,团队 A 的告警群被全体静音,真出事反而没人看见;团队 B 的关键告警,每个人都第一时间回应。差别就在"级别是否把噪音隔开"。
所以告警分级的本质是给每条告警配上一个明确动作:我该被吵醒吗、紧急到哪种程度、谁负责、去哪个门户处理。而不是一句"提醒你一下"。
第一步:用影响范围 × 严重度定级别
分级的依据是两个独立维度,合起来判断:
- 影响范围:坏了多少用户、多大业务。单机临时波动 vs 全站不可用,优先级天上地下。
- 严重度:坏到什么程度。轻微降级 vs 完全不可用,处置节奏完全不同。
把两者交叉,告警落进以"Priority"标号的级别。给一套常见口径(各团队可改名但思路通用):
| 级别 | 典型语义 | 处置时限 | 例 |
|---|---|---|---|
| P0 | 严重影响用户,需要立即介入 | 立即 | 全站不可用、核心交易中断、数据损坏 |
| P1 | 大范围降级或部分不可用 | 15 分钟 | 主打接口错误率大幅上升、缓存雪崩 |
| P2 | 局部受影响但可控 | 工作日当天 | 单个节点异常、个别租户慢 |
| P3 | 已知隐患、可选处置 | 排期 | 磁盘 80%、证书将过期 |
级别不是工作量的标签,而是"该多快响应"的共识。P0 意味着值班人必须被叫醒;P3 意味着你可以在正常工作时间排期,不用为它子夜爬起。
第二步:按级别 + 值班排班定优先级
级别定的是"多严重",优先级再叠一个"谁、在什么时间处理"的维度,合起来才是真正落地的动作:
把定级和响应动作画在同一张图上,这条"升阶梯"一眼就能明白——级别越高,响应越急、触达越强、升级越快。
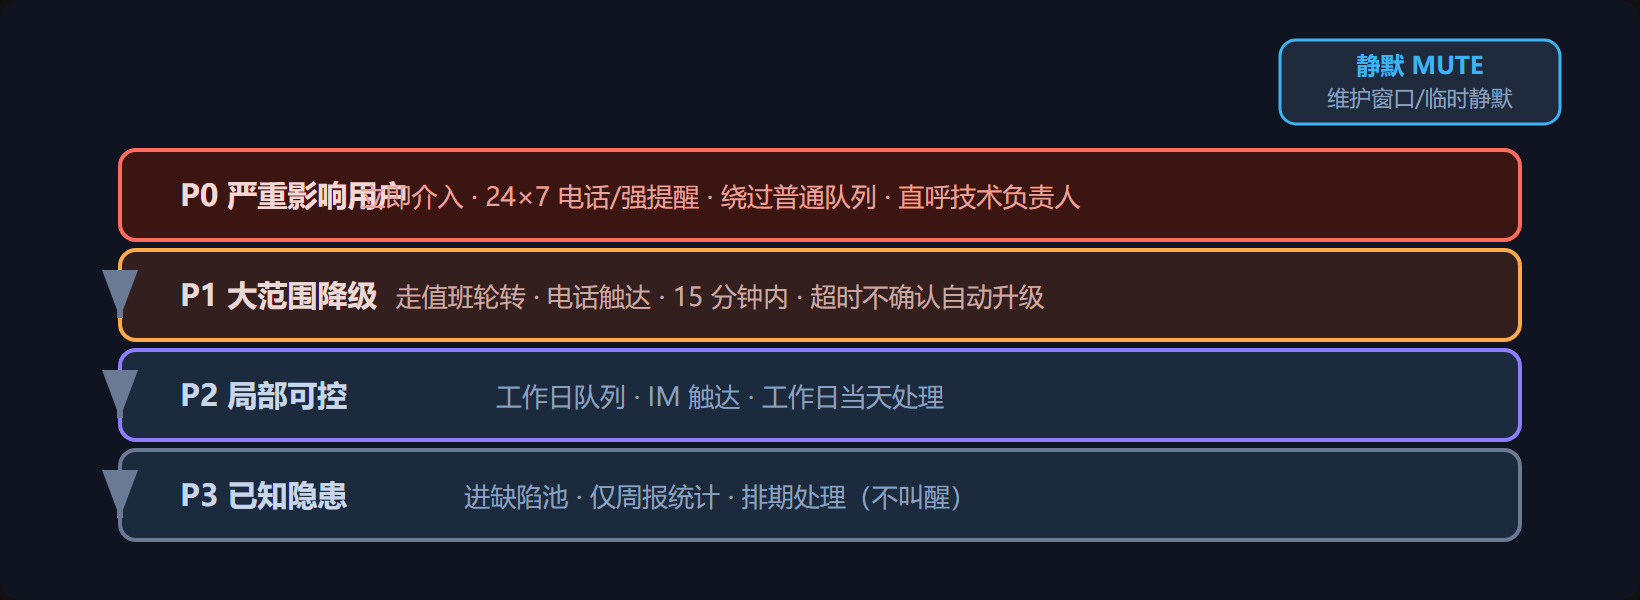
从底层走到顶层,响应动作从"排期"一路升到"立即打断值班人"。真正的纪律在于:级别越高,升级链越要自动接住,第一棒没人接,下一棒自动顶上——这才叫把级别落实成动作,而不是标签。
- P0 永远最高:无论何时,立即 24×7 叫醒负责的技术负责人,绕过普通队列。通道用电话或强提醒 IM,且要有升级链——第一人没接自动升级到下一人。
- P1 走值班轮转:当前 on-call 的同事处理,触达用电话,超时不确认自动升级。
- P2 走工作日队列:白天处理,夜间只进 Slack 到第二天排期。
- P3 进缺陷池:不进告警叫醒体系,只做周报统计。
值班排班决定了"谁"来处理——所以各负责人的联系电话、IM、交接规则都必须完整。轮转交接的断裂,是 P1 级告警没人应的最常见原因。交接尤其要留一个"当前谁 on-call"的实时清单,并且和排班表联动,否则人换了班、告警还是找旧人,等级再清晰也落不了地。
一个升级链,保证"没人接"也不漏
升级链是分级里最后一道保险。它解决的是"第一责任人正好没看见/没接"的真空:给每级告警设好一级、二级、三级响应人,第一棒在限定时间内没确认,系统自动升级到下一棒,一直升到有人接手。这条链不是可有可无的排班表,而是把"一定有人会应"变成制度。我见过一次 P0,值班人恰好在电梯里没信号,靠升级链自动打给了技术负责人,才算没让故障等了三小时没人看。没有升级链,分级再细也只是一张没人执行的表。
触达渠道,一个事件一条龙的编排
触达渠道的选择和前面级别强相关。常见渠道:
- 电话/强提醒:P0/P1,打断当前在做的事。配合 call 升级链。
- IM(企业微信/钉钉/Slack):P2 以及 P0/P1 的通知里也要有一条,作为共同可见的上下文。IM 强调"事件页/Thread",大家在一个上下文里协作,而不是群里刷屏。
- 邮件:只用于低优先级和事后记录,别指望用它叫醒人。
- Webhook:对接第三方系统做自动化流转(自动建单、自动重启、自动扩容),注意 Webhook 失败要有超时重试与失败告警。
现代编排更倾向"一个事件一条龙":让告警先落到事件追踪系统(生成事件单),再按级别触发对应渠道的通知,所有处置动作都附着在事件单上形成记录。这样既能叫醒人,又把整场处置串成一个可复盘的事件。
沉默期与运行维护窗口
还有一个常被忽略但很关键的设计——沉默期(MUTE)。当你已知某个时刻在做维护,或者已知某指标会因正常操作而波动,就该让相关告警提前静默,免得维护本身也把值班人吵起来。
实现上分两类:
- 计划维护窗口:提前排期静默。比如"每周三零点换批次跑批,给 batch 相关规则静默 1 小时"。
- 临时静默:主动运维时临时点响静默,设置自动恢复。危险在于"永久静默"——那是把告警关了就等于没了,必须用自动恢复的临时静默,避免一静默就再也不开。
我的建议:把"P0 必须叫醒、P1 走值班、P2 进工作队列、P3 排期"这四条铁律钉进团队协作规范,配合一个事件单系统。级别是共识,共识在事里才有效。维护静默务必带自动恢复,别开着静默忘了关。
本节要点回顾
- 级别是给告警配动作:告诉人该不该被吵醒、得多快处理。
- 双维定级:影响范围 × 严重度,交叉出 P0-P3。
- 优先级再叠排班:谁处理、什么时间处理、升不升级。
- 触达渠道按级别分:P0/P1 电话强提醒,P2 走 IM,P3 只进池。
- 事件一条龙:告警先进事件单,处置动作都附着在单上可复盘。
- 维护窗口要静默:计划维护和主动运维都有对应的 Muting。
- 静默务必自动恢复:永久静默等于关了告警,坚决避免。
级别和触达定了,下一个难题是告警太多——风暴、刷屏、狼来了。下一节讲噪声治理,把"叫得太密"的毛病治干净。