1.1 目标检测定义、任务与发展历程
1.1 目标检测定义、任务与发展历程
本节摘要:目标检测既要识别类别又要定位位置。本节讲清检测任务的形式化定义,以及从手工特征到深度学习的三段发展史。
学习目标
阅读完本节,你应当能够:
- 形式化描述目标检测任务
- 区分分类、定位、检测、分割
- 复述检测算法的三阶段发展史
概念脉络
一、目标检测任务的形式化
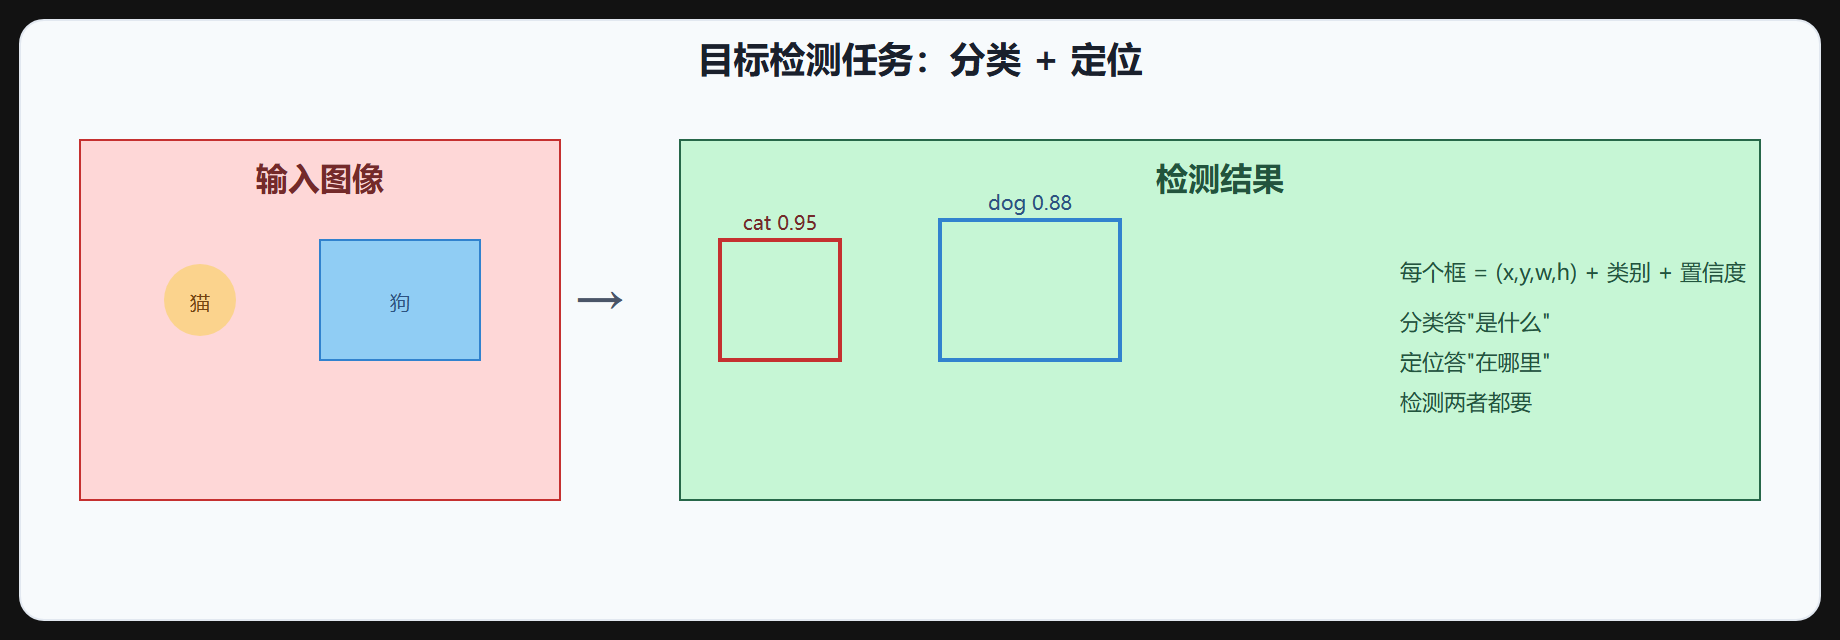
给定图像 I,目标检测输出一组检测结果 \{(b_i, c_i, s_i)\}:
- b_i = (x, y, w, h):边界框(中心坐标 + 宽高)
- c_i:类别标签
- s_i:置信度分数
简单说,检测 = 给图里每个目标贴一个带类别的框。注意三点:目标个数 N 事先未知;位置 (x,y,w,h) 是连续值;同一张图可能同时存在多个不同类别的目标。这三个特性决定了检测不能退化成普通分类。
图 1-1 目标检测任务示意
用代码表达这个任务会非常直观:
# 一次检测前向的抽象描述 def detect(image): """输入图像,输出 N 个 (框, 类别, 分数)""" boxes = [] # 每个元素是 [x, y, w, h] labels = [] # 每个元素是类别 id scores = [] # 每个元素是置信度,0~1 # 传统方法:手工特征 + 滑动窗口 + 分类器 # 深度方法:CNN 特征 + 检测头,一次前向得到全部结果 return boxes, labels, scores
后续所有算法,本质都是在回答"如何得到这组 boxes/labels/scores,且又快又准"。
二、与相关任务的区别
| 任务 | 输出 | 难度 |
|---|---|---|
| 图像分类 | 整图一个类别 | 低 |
| 目标定位 | 一个目标的位置 | 中 |
| 目标检测 | 多个目标的类别+位置 | 高 |
| 实例分割 | 像素级类别+位置 | 更高 |
| 语义分割 | 像素级类别(不分实例) | 高 |
检测比分类难,因为目标数量未知、位置连续、尺度多变。比实例分割简单,因为分割还要区分同一类别的不同个体并给出像素级掩码。这条"难度阶梯"也是模型选型的参考:任务越复杂,对标注和算力的要求越高。
三、发展史:三个阶段
阶段一:传统方法(2012 前)
手工特征(HOG、SIFT、SURF)+ 分类器(SVM、Adaboost)。代表是 Viola-Jones 人脸检测(Haar 特征 + 级联分类器,实时人脸)。典型流程是滑动窗口:在图像每个位置、每种尺度取窗口,提取特征,用分类器判断窗口内是否含目标。窗口数量巨大,计算慢,且手工特征无法表达"自行车"这种结构复杂的目标。
痛点:手工特征泛化差,复杂场景崩盘。
阶段二:深度学习两阶段(2014-2015)
2014 年 R-CNN 用选择性搜索生成约 2000 个候选框,再逐个送进 CNN 提特征,配合 SVM 分类,把 PASCAL VOC 上的 mAP 从 35% 拉到 58%。随后 Fast R-CNN 用整图一次前向 + RoI Pooling 把速度提上来,Faster R-CNN 又用 RPN 把候选框生成也搬上 GPU,实现端到端。
特点:精度高,但两阶段流程慢。
阶段三:深度学习单阶段(2016 至今)
2016 年 YOLOv1 把检测当回归,一次前向直接出框;SSD 用多尺度特征图、RetinaNet 用 focal loss 分别解决小目标和正负样本不均衡。YOLOv4 之后进入工程优化融合期:数据增强、损失函数、部署优化成为新的性能增长点。
特点:速度快,精度逐步追上两阶段。
四、两阶段 vs 单阶段
| 维度 | 两阶段 | 单阶段 |
|---|---|---|
| 流程 | 候选框→分类 | 直接回归 |
| 精度 | 高 | 早期略低,现已追平 |
| 速度 | 慢 | 快 |
| 适合 | 高精度离线 | 实时 |
为什么两阶段早期精度占优?因为它把"在哪里"和"是什么"拆成两个专门步骤,每个步骤都用较充足的样本优化;单阶段要同时优化大量网格位置,正负样本严重失衡,早期难训好。RetinaNet 的 focal loss 正是针对这一点做的修正。
五、一个贯穿全书的思考角度
判断一个检测器好不好,可以从三个角度问:它在哪里找候选(滑动窗口、选择性搜索、RPN、网格、特征点)、它用什么特征(HOG、VGG、ResNet、Darknet、FPN 多尺度)、它怎么定损失(L1、IoU 家族、focal loss)。后面每讲一个模型,我们都用这组问题去拆解它,对比就自然出来了。
⚠️ 常见误区:以为单阶段精度一定不如两阶段。YOLOv4 之后,单阶段在 COCO 上已追平甚至超越两阶段,差距主要在工程优化而非范式本身。
💡 关键直觉:检测 = 分类 + 定位。发展三阶段:传统手工特征(泛化差)→两阶段深度学习(精度高慢)→单阶段深度学习(快,精度追平)。范式之争已淡化,工程优化成主战场。
要点速记
- 任务:输出 (b_i, c_i, s_i),每个目标一个带类别和置信度的框。
- 区别:分类答"是什么",定位答"在哪里",检测两者都要。
- 发展三阶段:传统方法(HOG+SVM)→两阶段深度学习(R-CNN系列)→单阶段深度学习(YOLO/SSD)。
- 两阶段 vs 单阶段:精度 vs 速度,现已融合,工程优化为主。
- 拆解角度:找候选的方式、用的特征、定的损失。
- 趋势:范式之争淡化,数据增强、损失函数、部署优化成关键。
下一节看目标检测用在哪里。