2.2 从 Sigmoid 到 Swish:常见激活函数全景
2.2 从 Sigmoid 到 Swish:常见激活函数全景
本节摘要:逐个拆解六类主流激活函数——Sigmoid、Tanh、ReLU、Leaky ReLU、ELU、Swish。每家都从公式、曲线形状、梯度行为、实现代价四个角度审视,最后汇成一张对比表。贯穿的衡量标准只有两条:能不能提供非线性,以及对梯度"供血"够不够稳。
上一节证明了非线性非有不可,这一节就来登台点名,看看台上有哪些候选,各自的长处和软肋在哪。我们盯着的始终是两个问题:它让天平的表达力增加了多少,以及它会不会在反向时把梯度这块砝码悄悄克扣掉。
一、曲线的形状就是梯度的性格
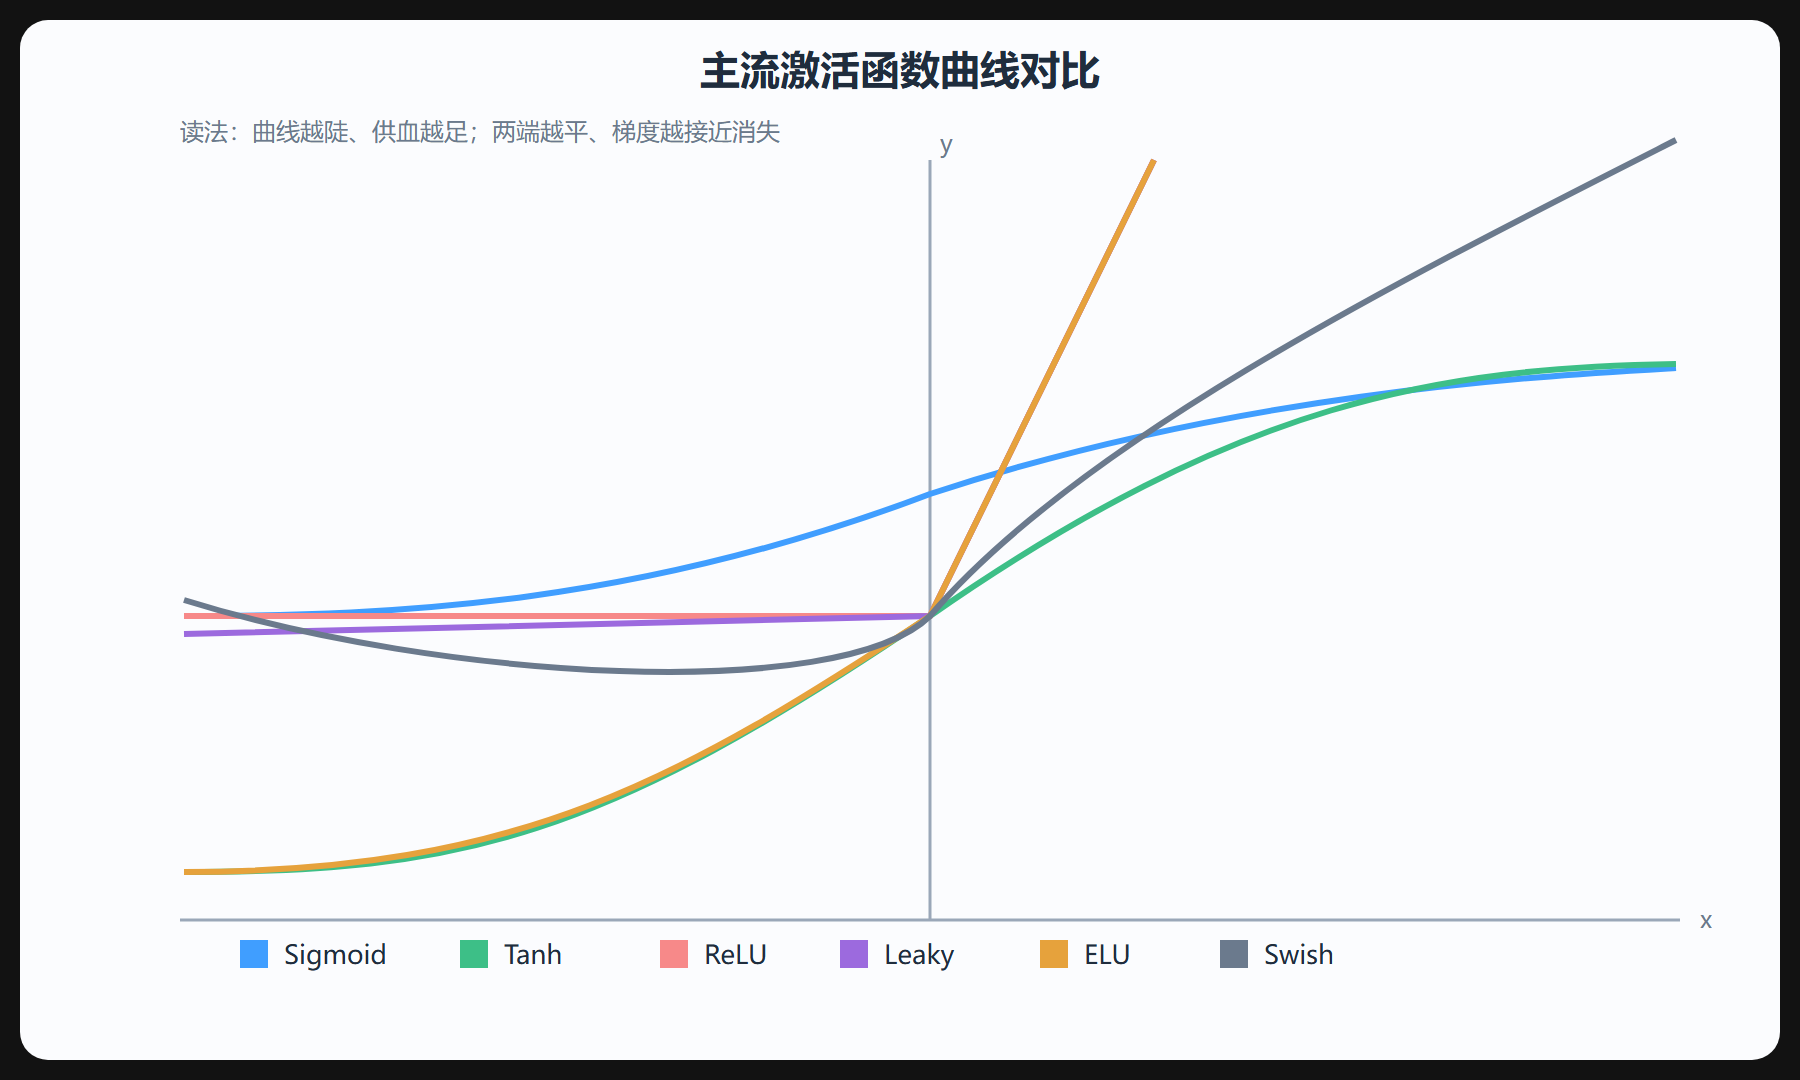
激活函数对优化器最大的"暗算"在于:它曲线的斜率,就是反向传播时待传的梯度。 斜率平坦,梯度就小;斜率归零,梯度直接消失。所以看一个激活函数,与其记它的优劣清单,不如先看它的形状。
Sigmoid
σ(x) = 1 / (1 + e⁻ˣ),把任何输入压进 (0, 1)。好处是输出能当"概率"来解释,坏处两条:一是有饱和区,输入过大或过小斜率都趋近 0,梯度被掐没;二是输出不以零为中心,导致后一层的梯度方向一致地偏,更新路径走出锯齿。
Tanh
tanh(x) = (eˣ − e⁻ˣ) / (eˣ + e⁻ˣ),输出落在 (−1, 1)。它修好了"不以零为中心"这个毛病,但饱和区的梯度消失依旧在。实践中经常用作"以零为中心、输出有正有负"的选择。
ReLU
f(x) = max(0, x)。正区间斜率恒为 1,负区间恒为 0。它的妙处是把梯度供血稳定在"要么满血、要么不放血",同时计算便宜到极致——一次比较就完事。代价是负区间梯度为 0,某些神经元可能永远触发不了更新,这就是下一节要聊的死亡 ReLU。
Leaky ReLU、ELU、Swish
它们是针对 ReLU 负区间"死"的改进:Leaky ReLU 给负区间留一个很小的固定斜率(如 0.01);ELU 让负区间用一个平滑的负指数渐近而不是直接归零;Swish 干脆用 x·σ(x),处处可导而且非单调,实验结果常压过 ReLU。自制改进的代价是计算略贵、多出少数可调参数。
二、六条曲线摆在一起看
直接上这张对比图,注意看每一条曲线在原点的转折和两端的斜率——转折越硬,供血越"决绝";两端越平,越容易断供。
三、一张表装下六家的账本
| 激活函数 | 表达式要点 | 输出范围 | 梯度行为 | 主要代价 |
|---|---|---|---|---|
| Sigmoid | 1/(1+e⁻ˣ) | (0,1) | 两端饱和趋零 | 梯度消失、非零中心、含指数 |
| Tanh | 双曲正切 | (−1,1) | 两端饱和趋零 | 无零中心问题但仍有饱和 |
| ReLU | max(0,x) | [0,∞) | 正区恒 1、负区恒 0 | 负区归零引死亡神经元 |
| Leaky ReLU | x 与 αx 分段 | (∞,∞) | 负区有微小斜率 | 多一个 α 要调 |
| ELU | 负区 α(eˣ−1) | (−α,∞) | 负区平滑不硬归零 | 含指数,略贵 |
| Swish | x·σ(x) | (∞,∞) | 处处可导、非单调 | 计算略高于 ReLU |
四、怎么把它们记住而不是背下来
一个助记办法:Sigmoid 和 Tanh 是"老一代饱和派",ReLU 是"一代断供派",Leaky/ELU/Swish 是"改良续命派"。 饱和派在深层网络里几乎退出隐藏层,只活在输出层当概率映射;ReLU 接管隐藏层成为默认;谁对负区间结尾心软、谁就可能反复在"死亡"与"不收敛"之间横跳。
⚠️ 常见坑:在输出层也顺手用 ReLU——回归要连续实数时输出层通常用线性激活,二分类用 Sigmoid,多分类用 Softmax;把 ReLU 直接用进这些场景并非好选择。评判激活函数永远要看它放的位置,而不是在抽象里打口水仗。
五、打开这几个函数逐个"说理"
把六家逐个念一遍重点,方便你日后隔着代码一眼认出它们:
- Sigmoid:σ(x) = 1/(1+e⁻ˣ)。它的"性格"是把一切压到 (0,1),作概率解释方便;可是当输入绝对值一大,曲线两端变得平坦,导数趋近 0。它适合输出层做二分类概率,不适合隐藏层堆很深。
- Tanh:本质是能把 Sigmoid "搬个心"得到零中心,输出 (−1,1)。它修掉了 Sigmoid 非零中心导致的 zig-zag,但两端饱和依旧,深层里仍是减法。
- ReLU:f(x)=max(0,x)。正区导数恒 1、负区恒 0,计算只需一次比较,训练又快又稳——代价是负区"死"神经元。
- Leaky ReLU:给负区一个穿细斜率的活口(常见 α=0.01),等于"负区不死但走很慢",用来治死亡 ReLU。
- ELU:负区用 α(eˣ−1) 平滑过渡到渐近线,负值保持一定的激活而不硬归 0,代价是含指数、略贵。
- Swish:swish(x) = x·σ(x)。它平滑、非单调,有个"略负的谷",实验里常在深层大模型里压过 ReLU,但算力略高。
如果要我把六家浓缩成一句顺口溜:"饱和两老退居输出,ReLU 接班作默认,负区留活口靠改良续命。" 记住这句,做题时你基本不会再乱。
六、别被"曲线光滑"骗了
一个常见误解是"越光滑的激活越好"。光滑(处处可导)确实是 Swish 的优点,但它不等于"一定比 ReLU 强"。光滑换来的是更少"撞墙"、更多细微调整,同时也可能带来更高算力和更小的涨跌。很多实际任务里,ReLU 的分段线性已经足够,光滑只是加分项而非必须项。
选型的正确姿势不是"挑最花哨的",而是"在便宜、稳定、够表达之间取平衡"(呼应第 1 章总纲"优化即平衡")。这也是下一节 2.3 要讲的落地原则——本节的账本只是素材,真正拍板靠任务与现象。
本节要点回顾
- 斜率即梯度:曲线斜率决定反向信号的强弱,是选型的核心判据。
- 饱和派:Sigmoid、Tanh 抗梯度消失弱,隐藏层基本退场。
- 断供派:ReLU 正区满血、负区归零,计算便宜、成为默认。
- 续命派:Leaky、ELU、Swish 针对死亡 ReLU 改良,代价是略贵多参。
- 位置别乱用:输出层按任务选线性/Sigmoid/Softmax,别随手塞 ReLU。
认识到负区间会"归零",你就该问:那什么时候真会死一批神经元?这正是 2.4 节要拆的雷,先从 2.3 的选型口诀往下走。