- 文集信息
- 目录大纲
- 最新文档
- 知识宇宙
文集详情
文集导读
教程导读:把网络的每一次学习当成一次称重
想想一个场景:你让一个小子刚学会走路就上台阶,你没法一次教会他。训练神经网络跟教会一个孩子迈步很像——每次走偏一点点,就轻轻把他扳回一步,走多了自然越走越稳。可问题来了:扳多少算多?往哪个方向扳?要不要在坏习惯上用力拽?这一连串的"怎么扳",就是神经网络的优化问题。激活函数决定了孩子能表达多复杂的花样,损失函数告诉你他错得有多离谱,优化器则决定每次该迈多远的步子。三者像一台天平的三个砝码,哪一个没放好,整架天平都晃。
本教程专为已会搭建简单网络的开发者而写,把"选什么激活函数、用什么损失函数、怎么调优化器"这三件事,从背公式串成一条能动手用得起来的主线。
这个教程解决什么问题
很多教程把激活函数、损失函数、优化器拆成三个孤立的清单,读者背完公式,回到自己项目里依然一头雾水——"Sigmoid 和 ReLU 我该用哪个?损失函数报错该怎么选?Adam 学习率设多少?"。
这本书想做的,是把你带到一个更高的视角:这三样东西从来不是孤立旋钮,而是同一台天平上的三块配重。理解了它们如何互相牵制,你才真正理解为什么换一种激活函数会让优化器收敛更顺,为什么改一个损失函数就能压住异常值的影响。全书用"天平桌"这个意象做主线,每一章都落到"这个选择到底在平衡哪两种力"上。
适合谁读
- 会用框架搭过至少一个模型的实践者,想搞懂训练为什么不收敛、性能上不去
- 从线性模型或浅层网络往深度学习进阶、开始被梯度问题劝退的新手
- 想系统整理散落知识点、并给团队讲清楚选型逻辑的技术同学
学完你能做什么
- 说清激活函数为什么必须引入非线性,并在项目里依据任务挑出适合的激活函数
- 区分回归与分类问题各自的损失函数选型,理解交叉熵为什么取代了平方误差
- 从梯度下降一路看清动量和自适应学习率的演进,给出选优化器的判据
- 把学习率调度、正则化、梯度裁剪组装成一套完整的训练策略,排查不收敛与过拟合
学习路线
下面这张图把全册的知识地图摊开:三根柱子和一个托盘,代表三要素,训练优化的循环绕在四周。
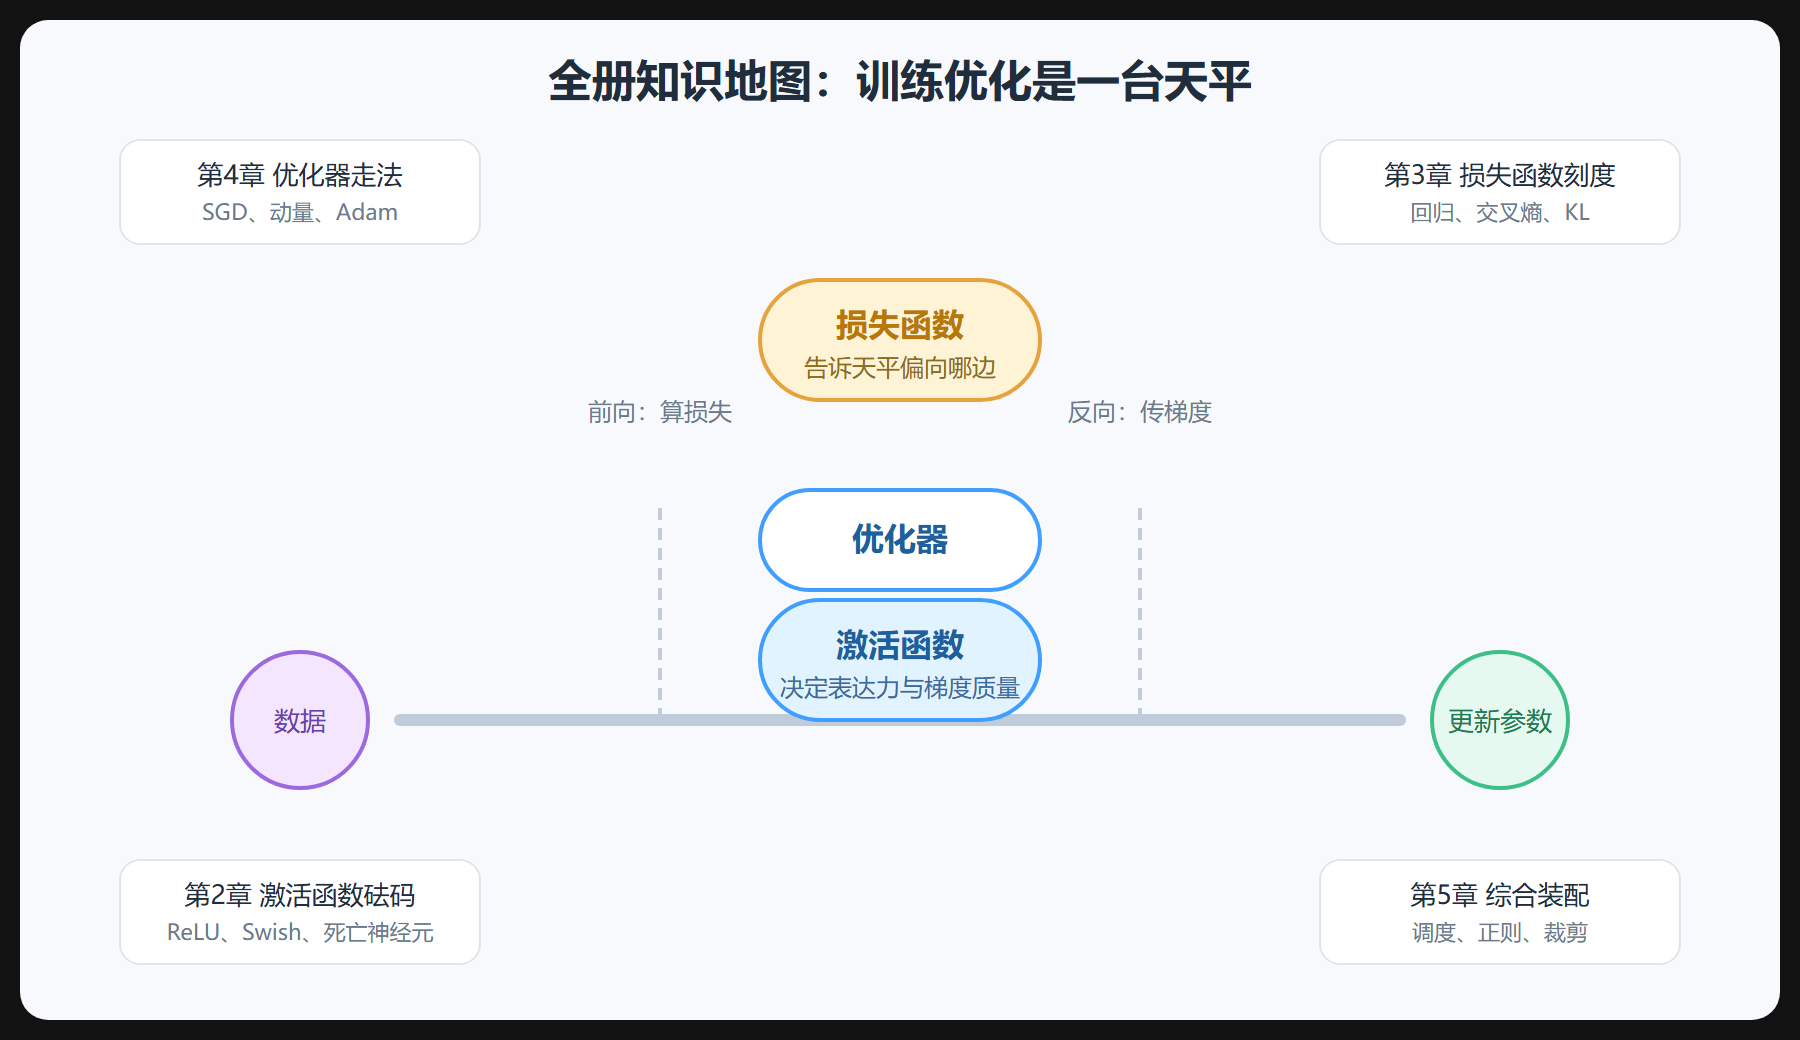
怎么用这个教程
不建议跳着读。第 1 章建立"天平"的整体观,第 2 到 4 章分别把三个砝码讲透,第 5 章教你如何组装,第 6 章收束并展望前沿。每章都配了全景图、知识点清单和可动手的小片段,最好在能跑代码的环境里边读边敲——优化这东西,光看文字记不住手感。
你可能会问的几个问题
门槛会不会太高? 不会。本书假设你搭过至少一个模型,但不要求你把反向传播的数学全推导一遍。遇到公式,我尽量先给你直觉再给形式,能跳过证明的绝不硬灌。
学完能立刻用在项目里吗? 能。第 2、3、4 章各有一节"项目里怎么挑",第 5 章直接给了能照抄的决策表与完整排查流程。你完全可以先把这几节当操作手册用,读懂了再回头补理论。
会不会讲得很"算法竞赛"、脱离工程? 这本书自始至终把"平衡、取舍、代价"放在公式前面。每一个选择我都尽量问"它省了什么、又代价了什么",而不是罗列术语——这正是全站把"优化技巧"拆成"激活、损失、优化器"三块的用意。
预期的阅读节奏
- 第 1 章:约 40 分钟,建立整体观,可略读。
- 第 2–4 章:每章约 60–90 分钟,是本教程的正文,建议边读边在代码里换参数观察。
- 第 5 章:约 60 分钟,实战性最强,最好跟着文档手敲一遍调参流程。
- 第 6 章:约 20 分钟,纯收束,不必动手。
如果时间紧张,请至少读完第 1 章和第 5 章——前者给你地图,后者给你可立即上路的工具。
目录大纲
最新文档
知识宇宙
正在加载知识图谱...