第3章 · 损失函数:标明训练的方向
第3章 · 损失函数:标明训练的方向
章节摘要:这一章跟着"刻度尺怎么给你的错打分"这条线走。先讲损失函数为什么把"模型差距"压缩成一个标量,再分别拆回归派(平方/绝对)与分类派(交叉熵)的来龙去脉,最后扩展到合页、KL 等特殊派,并给出一套选型标尺。读完你就能为任何任务挑对刻度尺。
一条主线
第 2 章把"表达力"砝码放上了天平,现在转到刻度端:损失函数是个函数,它把"网络预测"与"真实标签"之间的差距,压成一个越小越好的标量。这一章的主线用一句话串起来——损失函数是你的错被量化的方式,而量化方式直接决定了优化器往哪使劲。 我们沿"回归的刻度"走到"分类的刻度",再走进"特殊任务的刻度",最后回到选型的三个标尺。
沿途站点
3.1 损失函数如何表达"错得多深"
建立"预测对标签差距 → 一个标量"的抽象,说明这个标量为何同时驱动前向和反向。
3.2 回归任务:平方差与绝对差的取舍
推演 MSE、MAE,重点讲两者对异常值截然相反的敏感度。
3.3 分类任务:交叉熵是怎么长出来的
从"用概率惩罚错误"讲起,讲清二元与多类交叉熵、以及稀疏标签为何能省事。
3.4 其他派别:从合页到 KL 散度
合页损失、KL 散度、Huber 等特殊选型用于 SVM、生成模型与稳健回归。
3.5 损失函数选型的三个标尺
任务类型、数据分布、鲁棒性三把尺子,收网成一张选型决策图。
拐点与结论
本章的认知拐点在于:"交叉熵为什么取代了平方误差来做分类"是一道分水岭。 平方误差配 Sigmoid 在分类上收敛慢、容易瘫,而交叉熵与概率输出天生合拍、梯度更大——这个近乎"为什么默认"的问题一旦想通,你对整个刻度端的理解就通了。
读完你应该
- 用一个标量描述"差距",并说清它如何同时决定前向打分与反向梯度
- 区分 MSE 与 MAE 对异常值的敏感度,判断各自适用数据
- 说出交叉熵相对平方误差在分类上的优势,能写出二元与多类形式
- 识别合页、KL、Huber 各适合什么任务,并用三把标尺完成选型
下一章的接力
刻度定下来了,下一步轮到"搬砝码的手"——优化器怎么沿这条标注好的刻度,把参数一步步推到谷底。第 2 章的激活砝码与第 3 章的刻度,正好为第 4 章铺好全部接口。
下面这张 SVG 直接把损失函数选型的决策地图画出来,当作本章的索引。
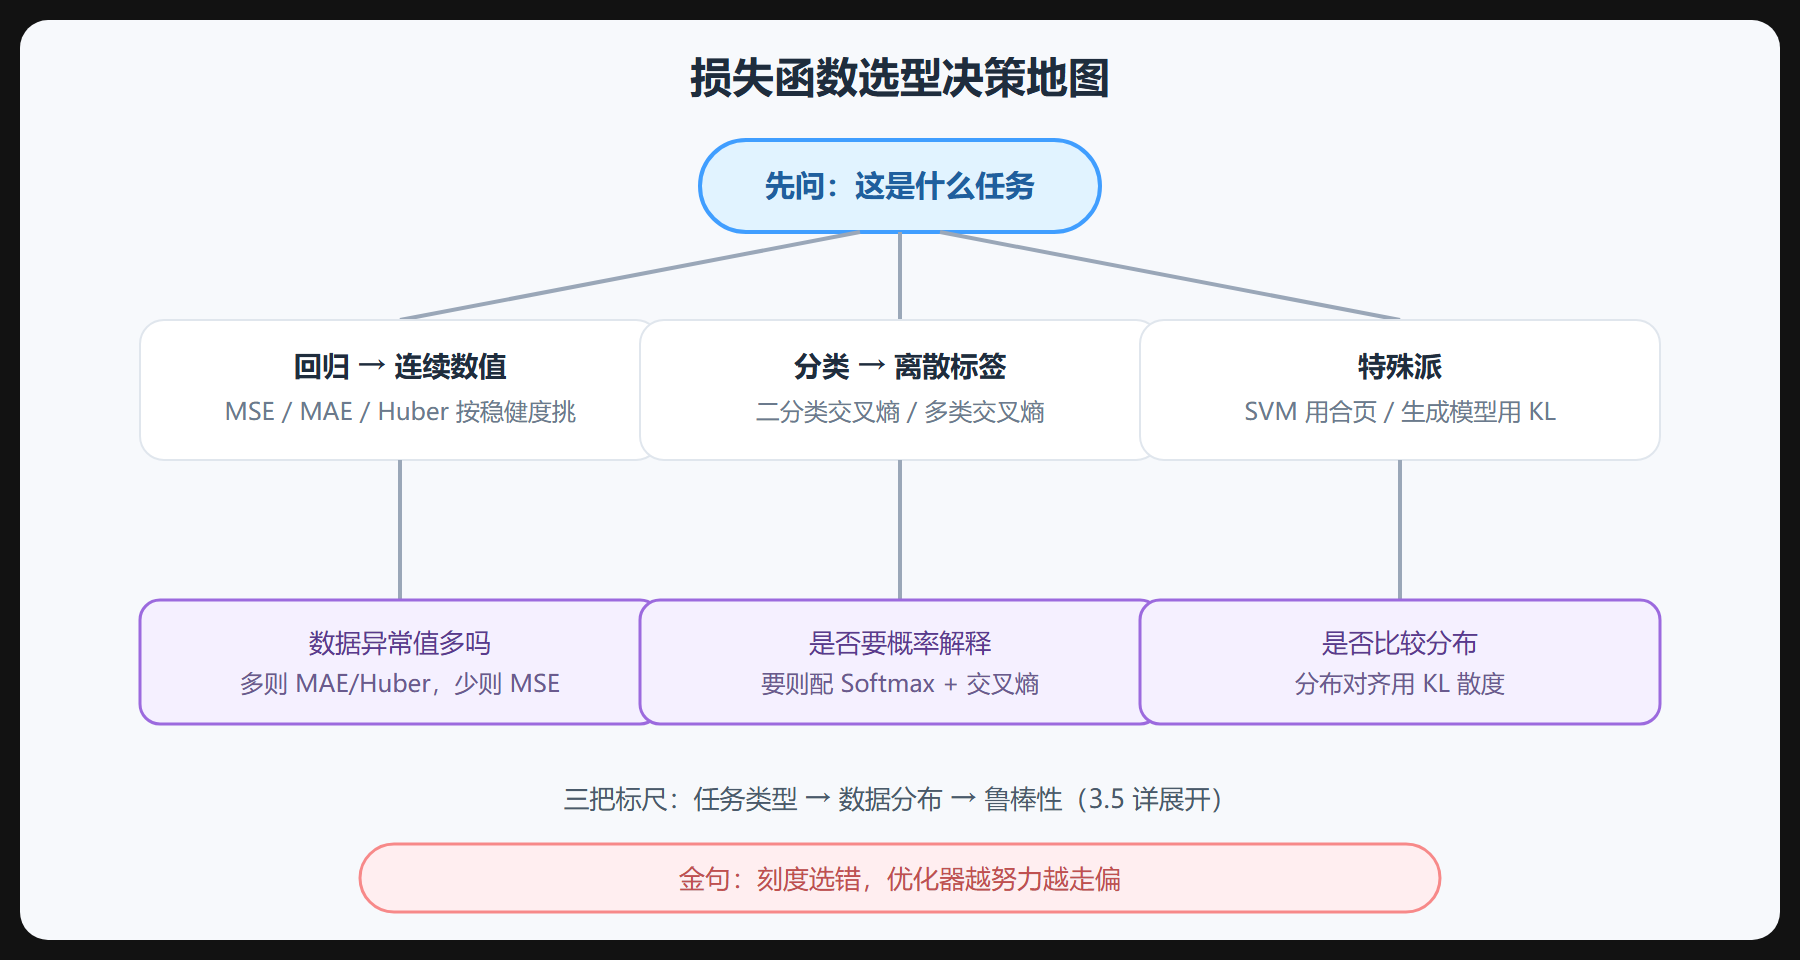
再补一张 mermaid 全景作为文字版的导航。
沿途主线:3.1 为什么要标量(没有它没有梯度下降)→ 3.2 回归刻度 → 3.3 分类刻度 → 3.4 特殊刻度 → 3.5 用三把标尺收网。
本章的知识点清单
读完本章,请对照确认你能逐条做到:
- 用一句话说清"损失函数输出一个标量"为什么是梯度下降的前提(3.1)。
- 对比 MSE 对离群点敏感的定量原因,能算出一个简单例子里两者相差的量级(3.2)。
- 用"惩罚自信的错"解释交叉熵的思路,写出二元与多类两种形式(3.3)。
- 说出合页、KL 散度各适合 SVM、生成模型的原因,并知道 KL 的非对称性(3.4)。
- 用"任务类型 → 数据分布 → 特殊约束"三把标尺,为一个新任务定出默认损失(3.5)。
如果逐条确认下来有卡壳,优先回读对应那一节再去第 4 章。
章内小结
损失函数是天平上的"刻度尺"——它定义了什么叫做错、错得多深,以及优化器该朝哪边使劲。刻度选错,后面手再快也是往错误的方向赶路。带着这把尺子,下一章去认识真正搬参数的"手"——优化器。