3.2 回归任务:平方差与绝对差的取舍
3.2 回归任务:平方差与绝对差的取舍
本节摘要:回归问题的两大主力——均方误差(MSE)与平均绝对误差(MAE)。本节用明显偏离的"离群样本"做定量推演,说明两者对异常值截然相反的敏感度,再介绍两者折中的 Huber 损失,最后给出数据在什么情况下该用哪把尺子。
上一节讲了损失的标量本质,这一节立刻把目光投到连续数值世界——回归。回归预测的是"多少",常用的量尺就两把:平方差和绝对差。它们长得像双胞胎,可对数据里某些"刺头样本"的态度,一个天上一个地下。
一、先把两个公式摆正
给定预测 y_hat、真实值 y,以及 n 个样本:
- MSE = (1/n) · Σ (y_i − y_hat_i)²,误差先平方再平均。
- MAE = (1/n) · Σ |y_i − y_hat_i|,误差取绝对值再平均。
一个平方、一个取绝对值,这个差别听起来小,造成的后果却天壤之别。关键在平方会放大大的误差。离群值是"很难买账"的一两个点,平方恰好把它们变成权重压倒性的存在。
二、一次定量推演:谁被一个离群点绑架了
我们用一个只有三个样本的玩具回归来看。真实值分别是 2、4、6,预测一律猜 4(模型还很粗糙)。
ys = [2, 4, 6] hat = 4.0 mse = sum((y - hat) ** 2 for y in ys) / len(ys) mae = sum(abs(y - hat) for y in ys) / len(ys) # 干净情形:mse = (4+0+4)/3 ≈ 2.67,mae = (2+0+2)/3 ≈ 1.33 # 现在混进一个离群点 ys_bad = [2, 4, 6, 100] hat = 4.0 mse_bad = sum((y - hat) ** 2 for y in ys_bad) / len(ys_bad) mae_bad = sum(abs(y - hat) for y in ys_bad) / len(ys_bad) # 离群情形:mse_bad = (4+0+4+9216)/4 ≈ 2306;mae_bad = (2+0+2+96)/4 = 25
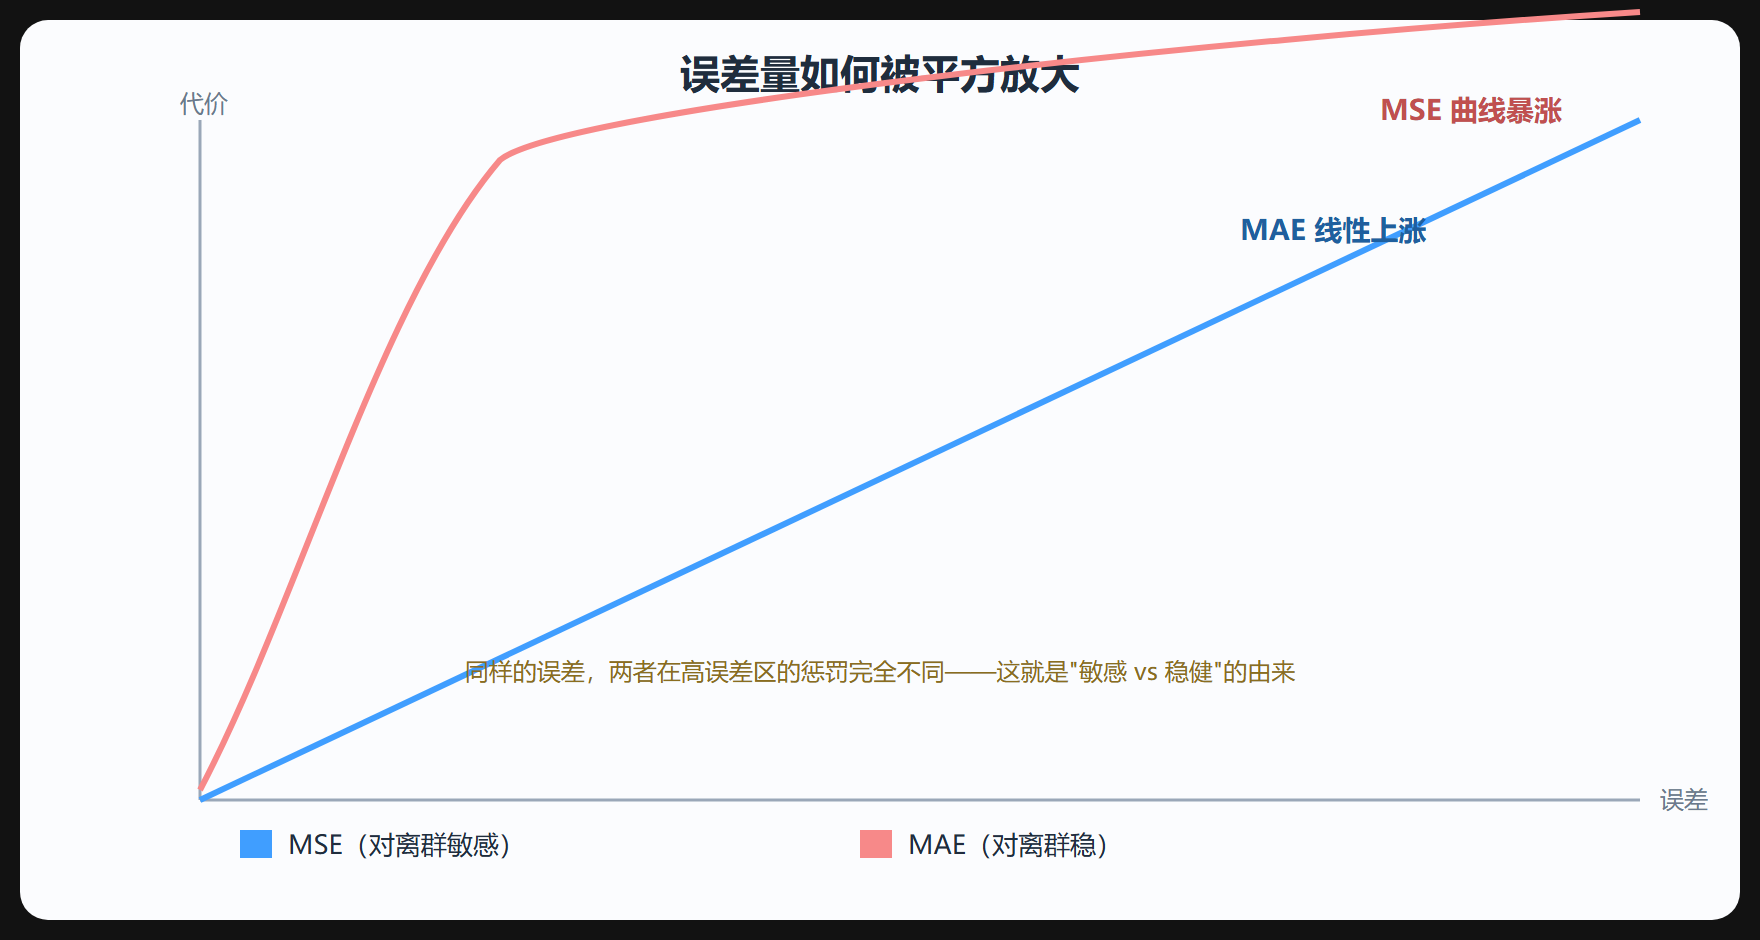
同一个预测,混进一个离群点后,MSE 从约 2.67 猛冲到约 2306,而 MAE 只从 1.33 涨到 25。平方误差被离群点拖着鼻子走,绝对误差稳得多。 原因很简单:平方让 100 与 4 的那 96 个单位的差变成 9216,占去绝对主导。
下面这张图把两种误差随误差量的变化画出来,直观看到平方印象在两端如何失控。
三、稳健性换来什么,代价又是什么
MSE 对离群点敏感,它有个"副作用"是做导游靠大误差拼命压低——如果你希望模型格外重视预测很烂的样本,这甚至是优点。MAE 稳健,代价祸根在于它在误差为 0 处不可导,而且对所有样本一视同仁,可能对"普通误差"没那么用力。
折中方案是 Huber 损失:小误差时表现如 MSE,给足细节;大误差时切换成线性,防止离群点主导。它多一个超参数 δ(临界点),介于两极之间,是很多回归问题里"既想要细节又不愿被离群绑架"的常态选择。
| 损失 | 异常值态度 | 主要特点 | 何时选 |
|---|---|---|---|
| MSE | 极度敏感 | 平滑、梯度大、易被主导 | 数据干净,希望强调大误差 |
| MAE | 稳健 | 不可导点、对离群一视同仁 | 数据多离群、要稳健 |
| Huber | 中间派 | 小误差类 MSE、大误差类 MAE | 兼顾二者时 |
四、一个真实决策
你在预测二手车价格。某天数据里混进几台价格离谱的拍卖记录。如果坚持用 MSE,那几台"一百万的神车"会把大多数正常车价的拟合带偏,模型宁可牺牲几十辆车的精度去讨好那几台。你切到 MAE,正常车价才重新被重视,但代价是小误差段不够细腻。
最后你上了 Huber,δ 设成一个合理的价格残差阈值:日常误差按平方精细处理,那几台离谱的车按线性处理,两者都不吃亏。这个权衡正是"刻度尺选型"的日常样例——没有绝对好坏,只有合不合适的任务语境。
⚠️ 常见坑:默认选 MSE 但从不统计你的标签有没有离群。回归前先看一眼目标值分布,是不是有几个尖峰,别让平方误差替你自作主张。
五、梯度性格差异:为什么敏感是双刃
回到天平总纲,MSE 与 MAE 的差别不只体现在"离群点权重",还体现在它们各自的梯度性格上。这对你的训练手感影响很大:
- MSE 的梯度:误差越大,梯度越大。也就是说"错得越离谱,模型越用力去改"。这对追求精确、越大的误差越该被优先修正是合理的。
- MAE 的梯度:对每个样本都是一个固定的大小(±1,忽略系数),不随误差变大而变大。它不会因为离群而发疯,但也意味着"改到一半就放软"——对误差减小的幅度不敏感。
可以这样记:MSE 是"越错越用力"的激进派,MAE 是"对远近一视同仁"的稳健派。 激进派怕被离群带偏,稳健派不讨好离群却也吊不住大误差。这也是为什么折中的 Huber 在现实中总受欢迎——它想两头都要。
六、什么时候该为"错得大的样本"特意用平方
如果你手上确实有"那个误差特别大、特别值得优先修正"的业务判断,那 MSE 的"双刃"恰好是你想要的那口刃。典型场景:测量精度要求高、某个大偏差会造成严重后果(如产量估算、定价差带来的利润差)。
反之,若大误差样本本身可能就是脏数据(传感器漂移、手工录入错误),用 MAE/Huber 才是对的——你不想让脏数据反过来主导整个拟合。判断标准永远不是"哪个函数高级",而是"那群大误差样本,到底是该被重视的信号,还是该被无视的噪声"。
七、一句话记住这对双胞胎的分工
把前面六节压成一句能带走的话:MSE 适合"每个点都重要、错得越大越要改"的干净数据;MAE 适合"数据里混着脏刺头、别让它们绑架你"的稳健场景;Huber 则是"想要前者的细致、又不想被后者带偏"时打出的组合牌。 选之前只看一件事——你的目标值分布里,那群大误差样本到底是该重视的信号,还是该无视的噪声。这一问定了,选平方还是绝对值几乎就不用再犹豫。
本节要点回顾
- 一个平方,一个绝对值:这看起来小,决定了离群点权重是天壤之别。
- MSE 被离群主导:平方放大大的误差,模型会讨好离群点。
- MAE 稳健但粗:在零不可导,对所有样本一视同仁。
- Huber 折中:小误差按平方、大误差按线性,加一个 δ 参数。
- 按数据分布选:先看标签有无离群,再定平方还是绝对值还是折中。
回归的刻度讲完了,下一站是分类世界——那里交叉熵是妥妥的主角,要仔细聊它为什么能取代平方误差。