5.1 学习率调度:让步伐随时间收放
5.1 学习率调度:让步伐随时间收放
本节摘要:学习率是优化器最重要的旋钮,调度则是"让这个旋钮随时间自动收放"。本节从"为什么不一直用一个学习率"切入,介绍步进衰减、指数衰减、余弦、热重启四种主流调度,配一张曲线对比图,并给出"先用什么、再换什么"的工程建议。
第 4 章把优化器的步长交给了学习率这个超参数。可问题来了:从训练开始到结束,同一个学习率真的合适吗? 早期你需要大步探索地形,后期希望在最优附近小步精修——一个固定的学习率两头都难讨好。这一节要上的"变速器"解决的就是这个问题。
一、为什么调度不是可有可无
想象一段下坡路:一开始坡陡、你对地形一无所知,恨不得大步冲;跑到坡脚时,你已经接近平底,再大步就容易在谷底来回晃。一个聪明跑者会自动收步。固定学习率则是"全程一个步幅"——起步若太大,后期就晃得停不下来;起步若太小,前期又慢得烦人。
调度就是让行程按"训练到哪个阶段"自动调整步幅,常见目标:前期保持较大,中后期逐步收小,让收敛既有速度又够精细。
二、四种主流调度
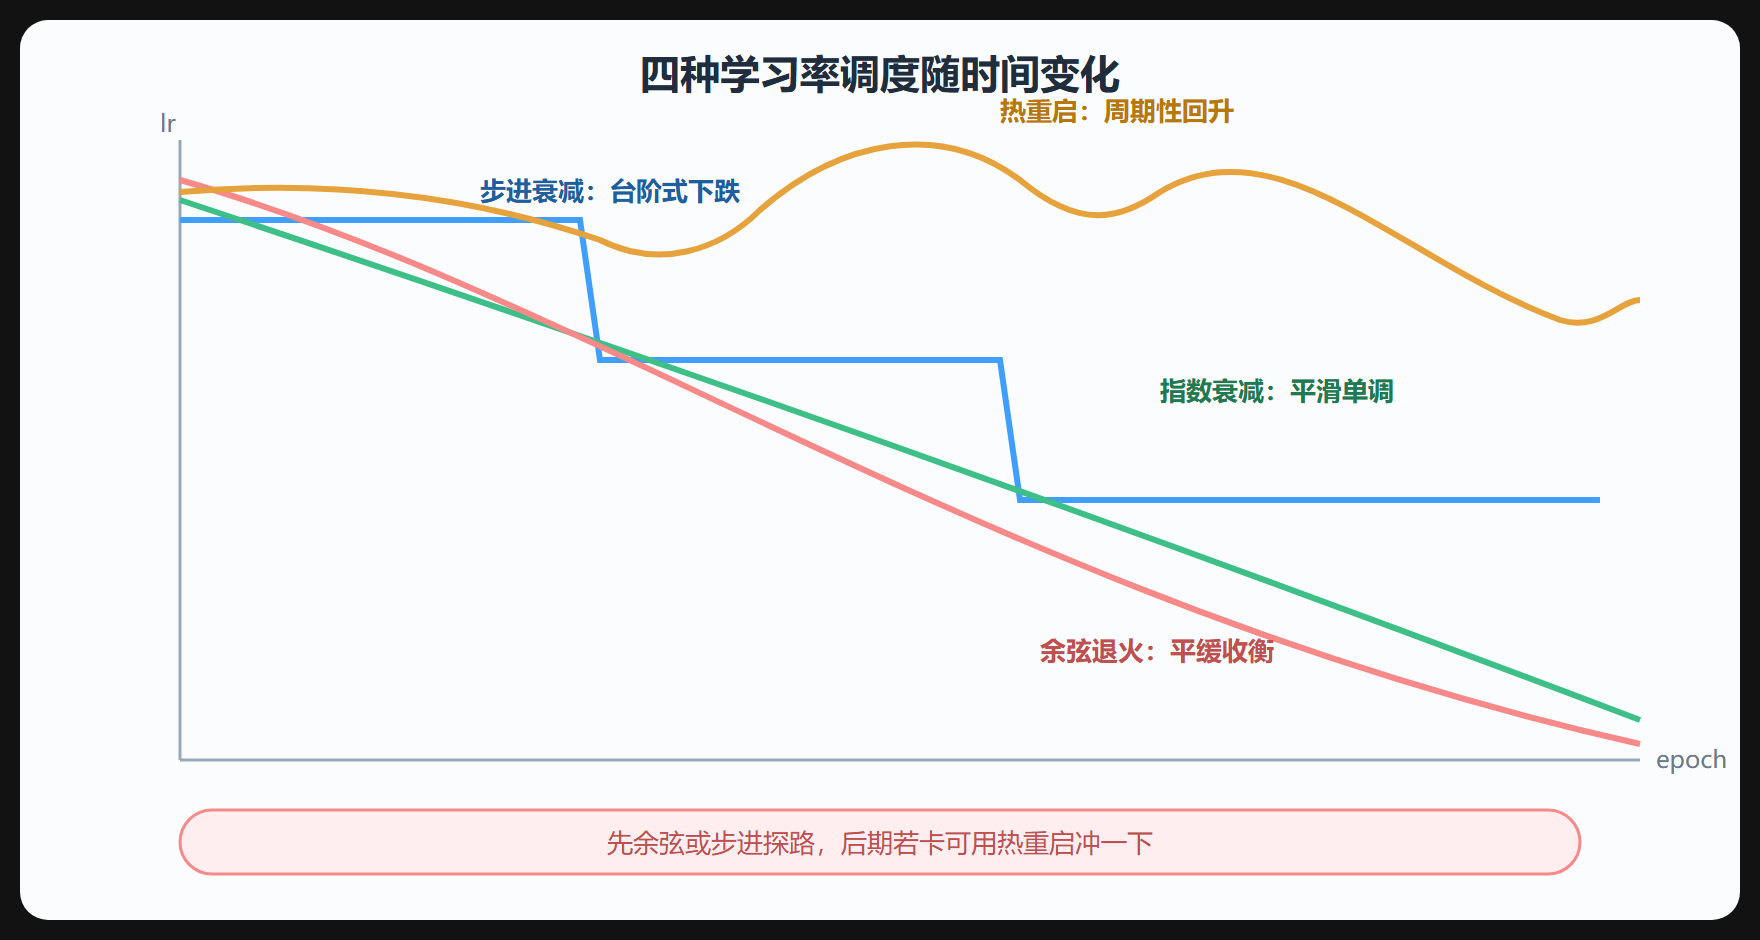
- 步进衰减(Step):每隔固定若干 epoch,把学习率按一个因子乘一下(如每 30 epoch 乘 0.1)。简单直观,配合"里程碑"设置。
- 指数衰减(Exponential):每步都以一个指数因子衰减,曲线平滑长期看是单调递减的直线(对数坐标下)。
- 余弦退火(Cosine):学习率沿半个余弦曲线从初值平滑降到接近 0。它比步进更平滑,经验上常更稳。
- 热重启(Warm Restart):降到很低后突然"热重启"回到较高的初值,周期往复。它能周期性跳出当前解、重新探索,深度模型常用。
三、一张图看四种曲线
下面把四种调度的学习率随时间的变化画在同一张图里,一眼看清"跌法"的区别。
四、怎么选、怎么配损失负交互
选调度的同时,要意识到它会跟其他旋钮咬合:
- 跟优化器咬合:Adam 自带自适应,调度的影响相对柔和;SGD 对学习率敏感,调度几乎必配。
- 跟热重启咬合:重启后损失会暂时跳高(它在重新探索),别误判为"变坏"。
- 跟早停咬合:若调度已把学习率降到极小,曲线基本平了,此时早停的判断会更容易。
工程公式:先用固定或步进衰减跑通 → 需要更好最终指标就把曲线换成余弦 → 探索性任务可试热重启。
五、一个真实决策
你在训一个图像分类模型,用 Adam,固定学习率 1e-3。前 20 epoch 一切正常,之后验证损失跌破不了某个平台。你把学习率改成余弦退火,让它在后段平滑收小,验证损失立刻掉了 0.8 个点。这个例子说明:一张好调度曲线,常常比反复调学习率一次性的数值更省事、更稳。
⚠️ 常见坑:把"学习率一直不变"当默认,殊不知在平坦的高维地形里固定学习率很容易"卡死"。训练中段损失不降,先别急着找模型问题,试着给它换一条带衰减的调度看看是不是"步幅太大撞不出微调"。
六、热重启:一次"故意回到大学习率"的冒险
热重启跟其他三个都不太一样——它不追求一条单调收敛的曲线,而是在把学习率降到很低后,故意猛地拉回一个较大的初值,重新开始一段"探索"。 它赌的是:前半段模型已经在某处聚过了一轮,回到大学习率后,它能靠这轮热身的质量逃出当前被网络嵌住的盆地,落到一个可能更泛化的新解。
可视化地看(回到第 5 章那张调度对比图),就是一条"下滑、跳回、再下滑、再跳回"的锯齿。它特别适合你初判"模型已经过拟合当前配置、但不知道往哪换"时的探索,代价是会牺牲一点前段已经稳定下降的平滑性。用不用它,取决于你更怕"找不到更好的解",还是更怕"训练曲线难看"。
七、调度和这几个旋钮连着咬合
调度从来不是孤立的,它和工程里的其他旋钮共享同一根传动轴:
- 和优化器咬合:SGD 对学习率最敏感,调度几乎必配;Adam 自带自适应,调度的影响相对柔和,但后期仍能补一刀。
- 和批大小咬合:批越大、每走一步越"重",往往需要更大的学习率,也因此需要更晚才衰减的调度,否则前期走得太肉。
- 和早停咬合:若调度已把学习率压到很小,曲线基本平了,这时候早停判断会更容易,也说明你该想想是不是换策略而不是继续干烧。
- 和动量咬合:动量大会让"过了大学习率那一段"时冲得过远,若调度在早期刻意放大学习率,动量系数在那一段该稍微收紧。
把这几条一起放进心里,你才不会在改了调度后惊讶"怎么别的东西也变了"。
八、一手数值:看一个余弦调度为何比"半路硬降"更省心
假设你训练 100 个 epoch,验证损失在 40 epoch 后进入平台。两条路:
- 路线一(硬降):在 40 epoch 手动把学习率从 1e-3 降到 1e-4。效果可能不错,但你得"守着曲线、掐准时机",且时机差一点点损失就忽上忽下。
- 路线二(余弦):从一开始就让学习率沿半条余弦从 1e-3 平滑滑向一个很小的末值,后 50 epoch 不需要你介入,曲线自动收小。
现实中大多数人会高估"手动掐时机"的准确性,转而偏好路线二。这不是说步进不能用,而是告诉你:当你没有确切的节奏经验时,余弦这种"自动收放"的曲线往往比"等我看到平台再手动降"更稳。 想省心,就优先给调度曲线多一点信任。
九、调度和"换优化器"往往是一起重置的配置组
第 4.5 节提醒你"换优化器 ≠ 改一行",调度也同理——它几乎总是跟着优化器选择的配套重定义。你用 Adam 时也许靠自适应就够了,调度只是锦上添花;你一旦切到 SGD+动量,调度就从"可选"变成"几乎必配"。所以如果你换优化器后忘了重新配调度,会发现 SGD 常见的"后段步幅太粗"问题又冒出来。
记住这个联动:优化器定"手感",调度定"手感随时间怎么变"。 两个一起想,你搭出来的训练配置才是自洽的整车,而不是把两件不配套的零件硬拧在一起。
本节要点回顾
- 为什么调度:前期大步探路、后期小步精修,固定学习率两边不讨好。
- 四种主流:步进(台阶)、指数(平滑单调)、余弦(平滑收小)、热重启(周期回升)。
- 跟其他旋钮咬合:SGD 几乎必配;热重启会让损失临时跳高,别当变坏。
- 工程顺序:固定/步进跑通 → 余弦求好 → 热重启探索。
- 一张曲线胜多次手调:很多后期瓶颈用调度就能解开。
变速器配好了,可一台车还会怕"记死训练集"。下一节上保险杠——正则化,怎么给过拟合上保险。