5.4 超参数调优:网格、随机与贝叶斯
5.4 超参数调优:网格、随机与贝叶斯
本节摘要:超参数调优是在超参数空间里"尝味道"的训练方法。本节对比网格搜索(排列组合却维度爆炸)、随机搜索(用更少成本覆盖更多维)、以及贝叶斯优化(把上一轮的教训沉淀成下一轮的挑选),配一张采样对比图,最后给出按预算选方法的建议。
前面的零件都装好了,可"手感好不好"还要调校。超参数(学习率、批大小、层数、正则强度、Dropout)不像网络参数那样靠训练自动学,它得靠调优方法去试。这一节把这套"调校车间"的几种主流流派讲清。
一、网格搜索:看似全但容易爆
网格搜索就是把每个超参数列一排候选,再排列组合,全都训一遍。听起来最"不漏",可维度一多立刻爆炸:5 个超参数、每个 5 个取值就是 5 的 5 次方 3125 组实验。且高维里真正有影响的参数往往只有几个,网格在"无关参数"上浪费了大量算力。
二、随机搜索:省很多但不慌
随机搜索不去穷举,而是把每个参数按概率分布随机取样组合来试。它的好处来自一个反直觉的观察:高维空间里,真正决定结果的往往只是少数几个关键参数。随机搜索恰好能更"均匀地"试到这些关键参数的不同取值,等量预算下往往比网格找得到更好的解。
三、贝叶斯优化:把教训沉淀下来
贝叶斯优化更聪明:它建立一个"哪块超参数域更可能让验证指标好"的代理模型(高斯过程等),每跑一次用结果刷新代理模型,再据此挑"最有希望、最不确定"的下一个点。前一坨失败的实验不会白跑,它融进了下一坨挑选。
代价是它的每一步不再傻试,需要一点计算维持代理模型,但从总实验次数看往往最省。
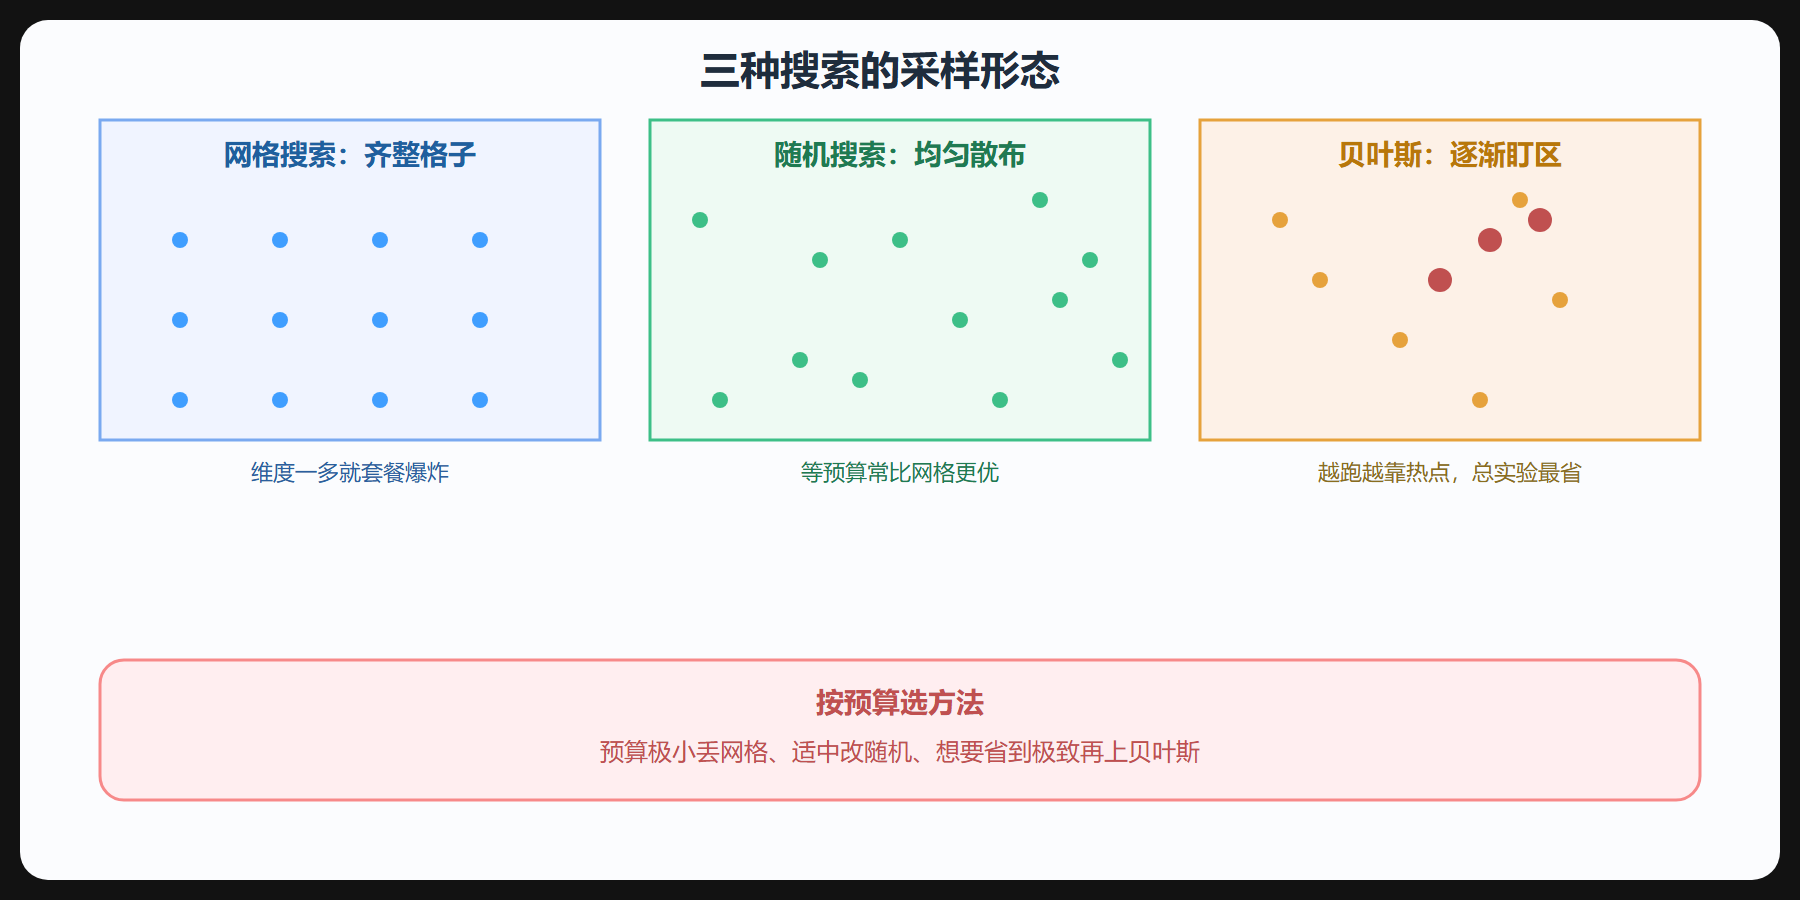
下面这张 SVG 用二维采样点对比三种搜索的抽样形态——网格聚成整齐格子、随机散布、贝叶斯则逐渐"盯上"某个高值区。
四、按预算选方法的决策
把这三种按投入产出排个序,按你的算力预算选择:
| 方法 | 成本风格 | 何时用 |
|---|---|---|
| 网格搜索 | 昂贵、全排列 | 参数少、预算足、要穷举 |
| 随机搜索 | 适中,省预算 | 参数多、高性能、第一轮探路 |
| 贝叶斯优化 | 逐步降总实验 | 单次训练贵、预算紧、要精准 |
实操建议:先用随机搜索探一圈摸清量级 → 在热点附近用小网格精找 → 若预算极紧再用贝叶斯放大搜。 这套组合拳远比一上来就网格稳妥。
五、调优里的"省"与"省"的坑
调优最容易踩的坑是把"验证指标",当全部真相,在不同超参数下反复用同一份验证集挑选,最后汇报的是"挑出来的"而非"真实泛化"。更稳妥的做法是调优用验证集、挑好后再拿一层别的划分(或交叉验证)确认没有过拟合到验证集。
⚠️ 常见坑:调优到"训练/验证都在涨"就收手。若你一口气把超参数搜到验证集上最优,很可能早已把它调"透"了,测试时跌得更难看——记得留一层干净数据做最终确认。
六、给你算一笔"预算账":为什么网格一上来就输
设你有 k 个超参数,网格给每个设 m 个取值,总共要训 m^k 组。k=6、m=5 就是 15625 次训练——一次若 2 分钟,就是二十来天起步。而同样预算,随机搜索能在"真正关键的那三两个参数"上换取更多不同的取值(其余参数随机器凑一个而已)。这是随机搜索在维度中等时就明显优于网格的经济学根源:**确定性 + 高维 = 组合爆炸;随机 + 稀疏覆盖 = 更便宜地找关键维。**
记住:网格不是不能用,它是"参数少、每个取值都想要、预算充足"时的选择,而不是默认。一上来就网格,多半是给算力打水漂。
七、贝叶斯优化的"不傻试"在哪
贝叶斯优化之所以省,在于它把每次训练的结果都当成"信息"喂回一个代理模型(比如高斯过程),然后用这个代理估计"哪里最可能让最终指标更高"。它下一次不是随机撒点,而是挑一个"既感觉有希望、又还没探明白"的点。效果是:同样的试验次数,贝叶斯更可能尽早把资源砸在大概率有戏的区域,少去那些摆明没戏的角落白蹚。
它的代价是重建代理模型要一点算力开销,且结果质量的确定性低于直接枚举。它在"单次训练特别贵"(比如大模型、大数据集)时最划算,因为省下的一次实验往往足以回报整个代理模型的成本。
八、超参数不是"越搜越多越对",先分清"量级"与"精细"
实践里搜参最常犯的一件事,是把"量级"和"精细"混在一起搜。比如学习率,它几乎都在 1e-n 这种量级上跑——你该先确定是 1e-3 还是 1e-4 这个"量级",而不是在 0.0012 和 0.0014 之间纠结。同理,正则强度、Dropout 也是先定量级、再在临近范围磨一小步。
所以在进入贝叶斯或网格之前,先用一次随机搜索把每个参数的"合理量级"探出来、把范围缩窄,再用小网格(或贝叶斯)做精调。先量级、后精细,能让你的预算花在刀刃上,而不是花在一堆根本没戏的细枝末节里。
九、警惕"搜到验证集最优"的自欺
调优最容易踩的暗坑,是用同一份验证集反复挑选,最后汇报的"最优"是对这份验证集的过拟合(你把它调"透"了)。表现就是:调参报告里验证指标亮眼,换到真正的测试或新数据就跌很多。稳妥处方:调优期间只用于验证,挑好配置后再留下一层从未参与挑选的干净划分做过最终评估,甚至考虑交叉验证去稳定估计那个指标的方差。这跟"治完调后再在新鲜数据上确认"是同一条纪律,第 5.5 节还会再强调一遍——别让自己的"最优"只是选出来的假高点。
十、一句话收束选方法
三种方法其实都很直白:网格给足预算求穷举,随机用更少成本半均匀覆盖,贝叶斯用教训聪明地挑选。先量级、后精细、留验证层,你大概能比大多数人少花一半试错。
十一、一个"少走弯路"的清单
把散落的要点收成能照做的清单,免得你一次次撞同一堵墙:
- 动手前先定量级:用一次随机搜索把学习率、正则、Dropout 的"量级"探明白,再进小网格精调。
- 一次只动一个:同一轮只改一个维度去观察它对验证指标的影响,否则改了两个参数根本不知道是谁起的作用。
- 留验证层:调参用验证集,但最终留一层从未参与挑选的干净划分做最终确认,防止"调透验证集"。
- 配一个记录的表格:把每次实验的参数 + 验证指标 + 一句结论记成表,翻看回比重跑便宜得多。
四件事单看都简单,但组合起来正是"调参不踩坑"和"调参全靠脸"的分水岭。把这四条刻进流程,你的搜索预算才算真正花在了刀刃上。
本节要点回顾
- 网格易爆:穷举组合在维度多时成本爆炸,把算力浪费在无关参数。
- 随机更划算:高维真正重要参数少,随机探得全面、等预算更优。
- 贝叶斯最省:用代理模型把前一轮教训沉淀进下一轮,总实验最少。
- 按预算选:置办极小用随机,精确用小网格,极紧再上贝叶斯。
- 留验证层:别把验证集当最终答案,挑好后再用留层确认泛化。
调校车间也见过了。最后一节把这些零件一起开上试驾场——完整地走一遍"从欠拟合到调稳"的实战排查流程。