2.2 语义分割 (Semantic Segmentation)
2.2 语义分割 (Semantic Segmentation)
本节摘要:语义分割把图像每个像素分类,告诉车"哪里能开"。本节讲它在自动驾驶的核心应用——可行驶区域识别。
核心问题
阅读完本节,你应当能够:
- 理解语义分割的作用
- 知道可行驶区域识别
- 了解代表模型
概念脉络
语义分割的作用
检测给框,分割给像素级精确边界。自动驾驶用语义分割识别:
- 可行驶区域:哪里是路能开
- 障碍物边界:精确轮廓
- 场景理解:道路、人行道、建筑、天空
可行驶区域识别
图 2-2 语义分割可行驶区域
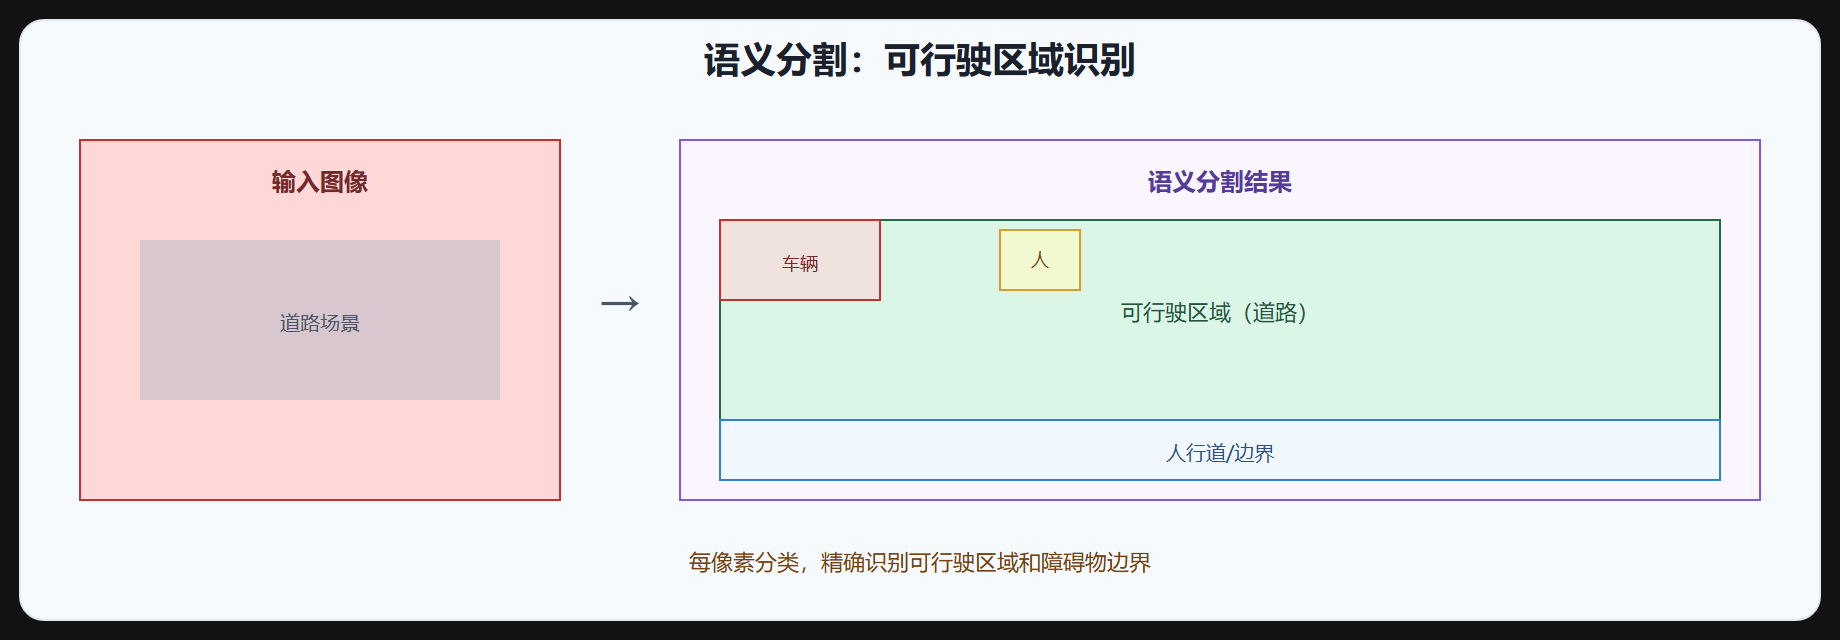
可行驶区域识别是语义分割在自动驾驶的核心应用:告诉车哪里是路能开,哪里是人行道/障碍。比检测框更精确。
代表模型
| 模型 | 特点 |
|---|---|
| FCN | 全卷积,语义分割开山 |
| U-Net | 编码-解码+跳跃连接,医学/通用 |
| DeepLab | 空洞卷积+ASPP,精度高 |
| SegFormer | Transformer 分割,现代 |
| BiSeNet/ENet | 实时分割,自动驾驶用 |
自动驾驶要实时,用 BiSeNet、ENet 等轻量分割模型。
语义分割 vs 实例分割
| 维度 | 语义分割 | 实例分割 |
|---|---|---|
| 粒度 | 每像素分类 | 像素+实例区分 |
| 同类多目标 | 不区分 | 区分 |
| 用途 | 可行驶区域 | 多目标跟踪 |
语义分割把所有"车"标一类,实例分割区分"哪辆车是哪辆"。
自动驾驶的分割类别
- 道路:可行驶区域
- 人行道:不可行驶
- 车道线:分隔
- 车辆/行人:障碍
- 建筑/天空/植被:场景
挑战
- 实时性:分割计算量大,要轻量模型
- 边界精度:像素级边界要准
- 小目标:远处行人像素少
- 天气:雨雪影响
BEV 分割趋势
现代自动驾驶把多摄像头分割结果统一到 BEV 空间,得到俯视图可行驶区域,更直观用于规划。
⚠️ 分割计算量大:语义分割是密集预测,比检测重。自动驾驶用轻量模型(BiSeNet)+量化,或只在特定场景用分割。
💡 关键直觉:语义分割每像素分类,核心应用是可行驶区域识别(哪里能开)。比检测框精确。实时用轻量模型(BiSeNet/ENet)。与实例分割区别在不区分同类实例。BEV 分割是趋势。
本章回顾
- 作用:像素级分类,精确边界,可行驶区域识别。
- 可行驶区域:核心应用,告诉车哪里能开。
- 模型:FCN、U-Net、DeepLab(精度)、BiSeNet/ENet(实时)。
- vs 实例分割:语义不区分同类实例,实例区分。
- 类别:道路、人行道、车道线、车辆、行人、建筑、天空。
- 挑战:实时性、边界精度、小目标、天气。
- BEV 分割:多摄像头统一 BEV,俯视图可行驶区域。
下一节讲实例分割。
分割网络的设计主线:上下文与分辨率
语义分割要同时保住两样东西:空间分辨率(每个像素都要分类)和语义上下文(远处的车和近处的车都属于"车")。全卷积 FCN 把分类网络最后的全连接层换成卷积层,第一次实现任意尺寸输入的分割,但连续下采样让输出分辨率变低、边缘粗糙。U-Net 的编码解码加跳跃连接,把浅层的细节特征与深层的语义特征拼接,解决了细节丢失。DeepLab 系列用空洞卷积在大幅增加参数的前提下扩大感受野——不做池化的情况下,空洞率 r=2 的 3×3 卷积等价于感受野 7×7 的普通卷积。
# 空洞卷积:扩大感受野而不损失分辨率 import torch.nn as nn conv = nn.Conv2d(in_channels=256, out_channels=256, kernel_size=3, dilation=2, padding=2) # 感受野从 3x3 扩大到 7x7,参数不变
分割损失与类不均衡
自动驾驶分割的类别分布极度不均衡:道路、天空占大部分像素,行人、自行车、施工锥桶只占极少像素。直接用交叉熵训练,模型会倾向把所有像素判成高频类别。常用对策有三种:加权交叉熵(给少数类更高权重)、Dice 损失(直接优化区域重叠)、Lovasz-Softmax(优化 IoU 的凸松弛)。实际工程常组合使用,比如交叉熵与 Dice 各占一半。推理端,整图分割对显存要求高,量产方案常用缩小输入分辨率、裁剪局部感兴趣区、或只对检测框内的区域做精分割,来平衡质量与延迟。分割输出的后处理也很关键:模型输出的软概率图要经过 argmax 取类别、再用连通域分析和形态学操作把碎块合并、去掉孤立噪点,最后才能得到干净的掩码;可行驶区域的边界还会再做一次平滑,避免规划模块拿到锯齿状边界。