2.1 目标检测 (Object Detection)
2.1 目标检测 (Object Detection)
本节摘要:目标检测是自动驾驶感知的基础——找出路上的车、人、自行车。本节讲检测在自动驾驶的应用、挑战和实时要求。
先说结论
阅读完本节,你应当能够:
- 理解检测在自动驾驶的作用
- 知道自动驾驶检测的挑战
- 了解实时检测要求
概念脉络
检测在自动驾驶的作用
自动驾驶要避让障碍物,先得检测出"有什么、在哪"。目标检测输出路上所有目标的边界框和类别,是感知的基础。
检测目标类别
图 2-1 自动驾驶目标检测
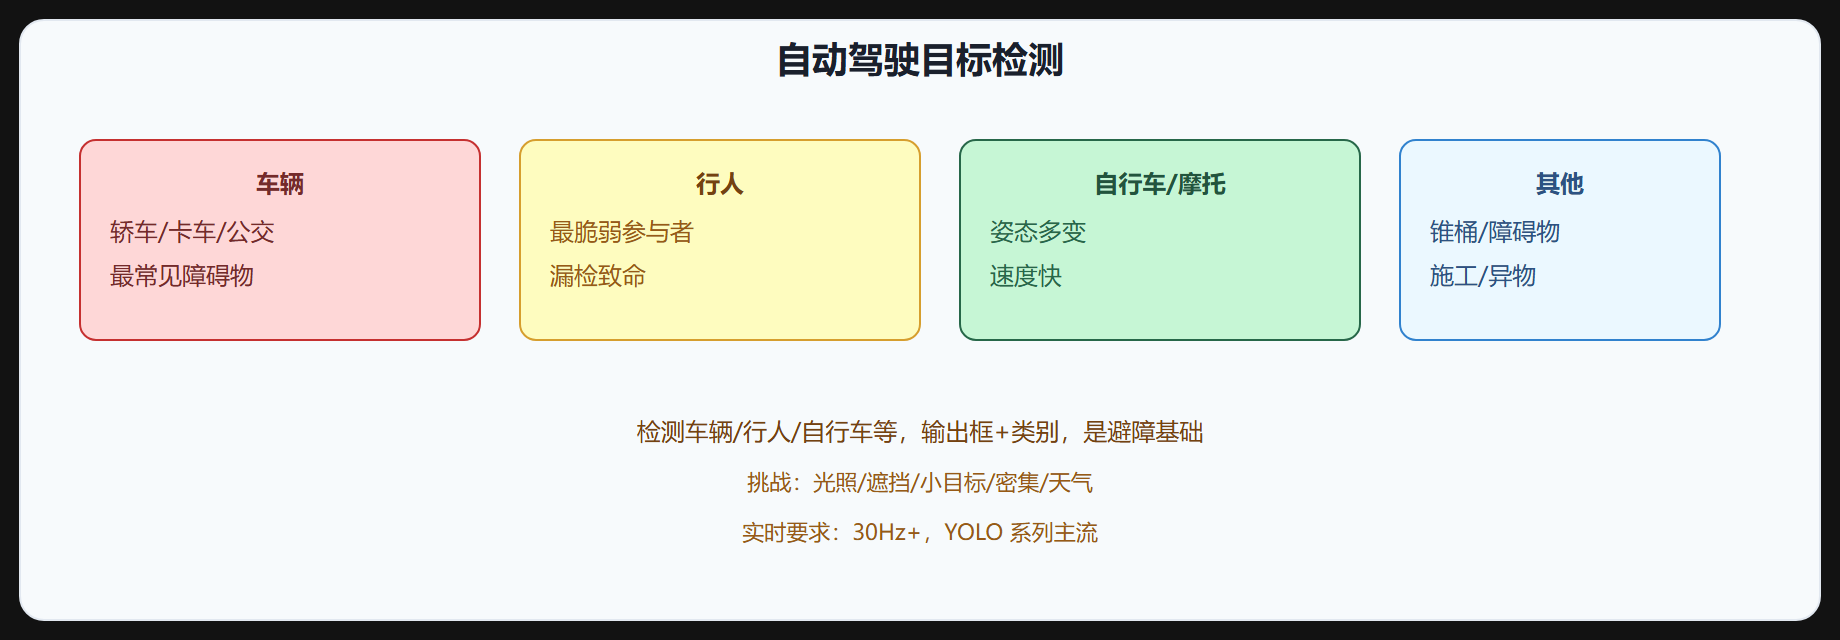
自动驾驶主要检测:
- 车辆:轿车、卡车、公交车(最常见障碍物)
- 行人:最脆弱,漏检致命
- 自行车/摩托车:姿态多变、速度快
- 其他:锥桶、施工障碍、异物
代表算法
- YOLO 系列:实时快,自动驾驶主流(YOLOv5/v8)
- Faster R-CNN:精度高但慢,离线标注
- DETR:Transformer 检测,端到端无 NMS
- BEV 检测:多摄像头统一 BEV 空间检测(BEVFormer)
自动驾驶检测的挑战
| 挑战 | 说明 |
|---|---|
| 光照变化 | 强光、阴影、夜间、逆光 |
| 遮挡 | 车辆互相挡、行人被挡 |
| 小目标 | 远处行人/自行车像素少 |
| 密集 | 拥堵场景多目标重叠 |
| 天气 | 雨、雾、雪降低可见度 |
| 长尾 | 罕见场景(如奇特车辆) |
实时性要求
自动驾驶检测必须实时:
- 延迟:每帧 <33ms(30Hz)
- 硬件:车载 GPU/NPU(如 NVIDIA Orin、地平线 J5)
- 模型:YOLOv5s/m、轻量化骨干+量化
精度和速度权衡,不能只追求精度。
3D 检测的需求
2D 检测只给图像框,自动驾驶要知道目标在 3D 空间的位置(距离、3D 框)。这催生 3D 检测(2.4 节)和 BEV 架构。
检测与其他任务协作
- 检测结果 → 跟踪(时序关联)
- 检测结果 → 距离估计(3D 位置)
- 检测+分割 → 精确边界
- 检测+预测 → 行为预测
⚠️ 漏检致命:自动驾驶检测漏检一个行人可能出事故,召回率比精度更重要。阈值设低,宁可误检不可漏检。
💡 关键直觉:检测找路上目标(车/人/自行车),输出框+类别,是避障基础。挑战多(光照/遮挡/小目标/天气),实时要求高(30Hz),YOLO 主流。漏检致命,召回优先。2D 不够需 3D 检测。
重点提炼
- 作用:找路上目标(车/人/自行车),输出框+类别,避障基础。
- 类别:车辆、行人(最脆弱)、自行车、其他障碍。
- 算法:YOLO 系列(实时主流)、Faster R-CNN(离线)、DETR、BEV 检测。
- 挑战:光照、遮挡、小目标、密集、天气、长尾。
- 实时:<33ms/帧,车载 GPU/NPU,轻量+量化。
- 召回优先:漏检致命,阈值设低宁误检不漏检。
- 协作:检测→跟踪/3D/分割/预测。
下一节讲语义分割。
YOLO 系列:从回归框到端到端
YOLO 的核心思路是"把检测当作回归问题一次性解决":输入整张图,输出所有目标的类别概率和边界框。第一代 YOLO 把图像分成 S×S 网格,每个网格负责预测若干个框,速度远超两阶段方法,但精度一般、小目标差。后续版本持续改进:YOLOv3 引入多尺度特征金字塔,在每个尺度分别检测不同大小的目标;YOLOv5 在工程上做了大量优化(自适应锚框、数据增强、模型缩放),成为社区应用最广的版本;YOLOv8 转向 anchor-free,直接用中心点加宽高的方式预测。
# 伪代码:一个简化的 anchor-free 检测头 for scale in [P3, P4, P5]: # 多尺度特征 for (i, j) in all_cells(scale): # 每个位置 cls = classifier(scale[i, j]) # 类别置信度 box = regressor(scale[i, j]) # (cx, cy, w, h) keep_topk(cell) # 每位置保留 TopK # 后处理:非极大值抑制,去掉互相重叠的低分框
从损失函数看检测的难点
检测的损失通常分三块:分类损失、定位损失、目标存在性损失。分类用交叉熵;定位常用 IoU 家族的损失(GIoU/CIoU),它不只惩罚框的位置偏差,还考虑框的重叠程度,训练更稳定;目标性损失解决"背景像素远多于目标像素"的不平衡。评价指标上,mAP 是主流——先按置信度排序,画出 PR 曲线,计算各 IoU 阈值下的平均精度。自动驾驶还特别关注两个衍生指标:小目标召回率(远处行人)和 3D 框的朝向平均相似度,这两个指标直接对应实际路测中的危险场景。
再补充训练层面的细节。检测模型在小目标上的表现很大程度上取决于特征金字塔的浅层特征质量——小目标在浅层特征上像素多、语义弱,很多方案会加大浅层特征在损失里的权重,或者在浅层额外加深特征融合(如 BiFPN 反复双向融合高低层特征)。另外,训练时的多尺度采样也很关键:把输入图按 0.5 到 1.5 倍随机缩放,能让模型对目标大小更不敏感,是提升小目标召回性价比最高的手段之一。数据层面,长尾类别(锥桶、施工机械、罕见车型)要专门做类别均衡采样,否则模型在它们上的召回会很低,而恰恰是这些类别在真实路测里最容易引起接管。