2.4 3D目标检测与感知
2.4 3D目标检测与感知
本节摘要:2D 检测只给图像框,自动驾驶要知道目标在 3D 空间的位置。本节讲 3D 检测——从图像/点云预测 3D 框,自动驾驶的关键能力。
上手前先明确
阅读完本节,你应当能够:
- 理解 3D 检测的必要性
- 知道单目/双目/LiDAR 3D 检测
- 了解 BEV 检测趋势
概念脉络
为什么需要 3D 检测
2D 检测给图像框 (x,y,w,h),但自动驾驶要知道目标在 3D 世界的位置(距离、3D 尺寸、朝向),才能规划避让。3D 检测输出 3D 框 (x,y,z,w,h,l,\theta)。
3D 检测的输入
图 2-4 3D 检测方法
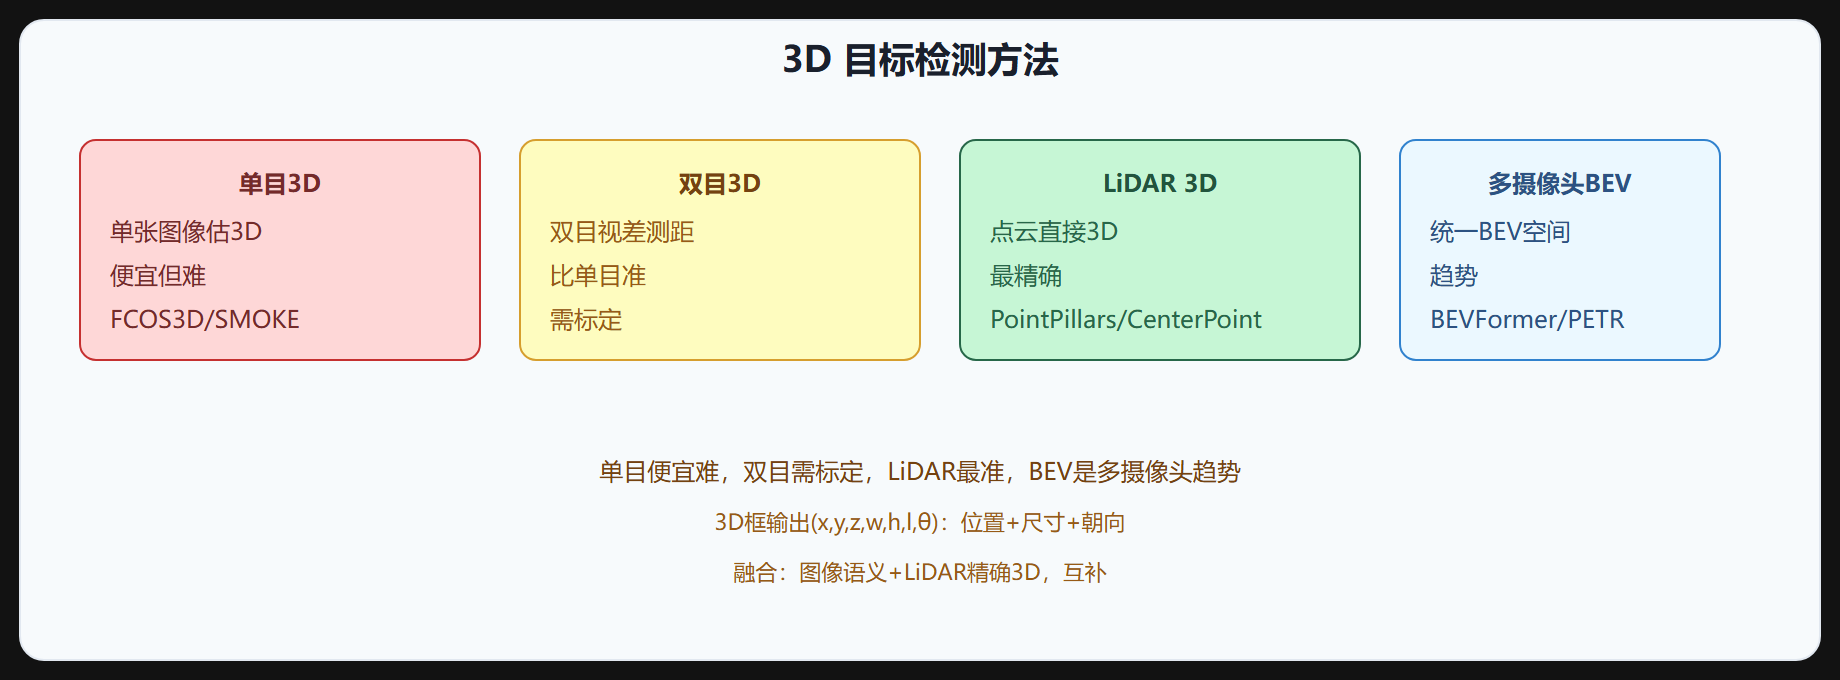
| 方法 | 输入 | 特点 |
|---|---|---|
| 单目 3D | 单张图像 | 便宜但难(需估计距离) |
| 双目 3D | 双目图像 | 视差测距,比单目准 |
| LiDAR 3D | 点云 | 最精确,但贵 |
| 多摄像头 BEV | 多图像 | 统一 BEV,趋势 |
单目 3D 检测
单目难(缺深度信息),靠网络学习几何先验估计距离:
- FCOS3D:anchor-free,预测 3D 框参数
- SMOKE:解耦 2D 投影和 3D 框
- MonoDETR:Transformer 单目 3D
单目 3D 精度有限,远距离误差大。
LiDAR 3D 检测
LiDAR 点云直接有 3D 信息,最精确:
- PointPillars:点云转伪图像,2D 检测
- CenterPoint:anchor-free,预测中心点
- VoxelNet:体素化 3D 卷积
LiDAR 3D 是高精度自动驾驶首选,但 LiDAR 贵。
BEV 检测(趋势)
现代趋势:多摄像头特征统一到 BEV(鸟瞰图)空间,在 BEV 做 3D 检测:
- BEVFormer:Transformer 采多视角特征到 BEV
- PETR:位置嵌入变换
- BEVDet:BEV 视角检测
BEV 让多摄像头像 LiDAR 一样在统一 3D 空间检测,纯视觉 3D 检测突破。
3D 框输出
3D 检测输出 3D 框:
- (x, y, z):3D 中心位置
- (w, h, l):尺寸(宽高长)
- \theta:朝向角
- 类别 + 置信度
融合 3D 检测
最佳方案是融合:图像提供语义(是什么),LiDAR 提供精确 3D(在哪),互补。
⚠️ 单目 3D 难:单张图像缺深度,靠学习估计距离,远距离误差大。高精度自动驾驶用 LiDAR 或 BEV 多摄像头。
💡 关键直觉:3D 检测输出 3D 框(位置+尺寸+朝向),自动驾驶必需。单目便宜难,LiDAR 精确贵,BEV 多摄像头是纯视觉趋势。最佳是融合(图像语义+LiDAR 3D)。
温故知新
- 必要性:2D 框不够,需 3D 框(位置+尺寸+朝向)规划避让。
- 方法:单目(便宜难)、双目(视差测距)、LiDAR(精确贵)、BEV 多摄像头(趋势)。
- 单目:FCOS3D/SMOKE/MonoDETR,靠几何先验估距,远距误差大。
- LiDAR:PointPillars/CenterPoint/VoxelNet,最精确。
- BEV:BEVFormer/PETR/BEVDet,多摄像头统一 BEV,纯视觉 3D 突破。
- 输出:(x,y,z,w,h,l,\theta) + 类别。
- 融合:图像语义 + LiDAR 3D 互补最佳。
下一节讲目标跟踪。
3D 框与 BEV 表示
3D 检测的输出是七自由度框(中心点 xyz、尺寸 whl、朝向角 theta),其中朝向角最容易出错——倒着行驶的车和正常行驶的车,2D 投影几乎一样,只有 3D 朝向能区分,而朝向误差会直接影响轨迹预测和避让规划。所以很多方案直接回归角度而不是尺寸,或者用分类加回归的混合方式(把角度离散成若干区间再回归残差)。
BEV(鸟瞰图)表示是当前的主流思路:把多摄像头特征通过空间变换投影到车体上方俯视视角,再在 BEV 特征上做检测和分割。BEV 的好处是把"多视角拼一个 3D 空间"这个问题统一了——规划模块本来就在 BEV 上工作,感知直接输出 BEV 结果可以免去坐标转换和视角不一致的麻烦。
前视图像 | 侧视图像 |--> 特征提取 -> 空间查询 -> BEV特征 -> 检测头 -> 3D框 后视图像 |
点云处理与稀疏性
激光雷达点云有两个工程难题:稀疏和不规则。扫描线间隔随着距离增大而变宽,远处的目标可能只有几十个点。PointPillars 把点云划分成竖直的柱体,每个柱体提特征后铺成伪图像,直接用 2D 检测网络处理,简单高效;CenterPoint 用中心点热图预测每个物体的中心,再回归 3D 框尺寸和朝向,免去锚框设计。评测 3D 检测时常用 NDS(NuScenes 综合评分),它把检测的 mAP、平移、尺寸、朝向、速度误差加权在一起,比只看 mAP 更接近真实驾驶需求。注意 3D 检测与 2D 检测的一个本质差异:2D 检测的目标是对齐的(图像就是真实投影),而 3D 检测需要预测观测不到的部分,比如被遮挡的侧面的精确长度。因此 3D 检测非常依赖先验——车辆的典型尺寸、静止目标的底面假设(假设目标立在地面上),这些先验极大地约束了解空间,也让数据驱动的模型能学得更稳。
再补一个关于评测的细节:3D 检测的 mAP 对距离敏感,远处目标的框只要角度偏一点,IoU 就会掉到阈值以下被判为误检。因此评估时要按距离分层看——近场(0-30 米)直接决定 AEB 等安全功能,中远场(30-60 米)影响巡航和变道,超远场(60 米以上)主要影响舒适性。量产团队往往给近场更高的权重,因为近场漏检的后果最严重。另外,朝向角误差在评测里常被单独统计,它对后续轨迹预测的影响远大于框的位置误差,是优化 3D 检测时最先要盯的指标。