2.5 目标跟踪 (Object Tracking)
2.5 目标跟踪 (Object Tracking)
本节摘要:检测只给当前帧,跟踪把跨帧目标关联起来。本节讲多目标跟踪——自动驾驶理解目标时序行为的基础。
本节导读
阅读完本节,你应当能够:
- 理解跟踪的必要性
- 知道多目标跟踪流程
- 了解代表算法
概念脉络
为什么需要跟踪
检测每帧独立,不知道"这帧的车 A 是上帧的车 A 吗"。跟踪把跨帧同一目标关联,给每个目标一个 ID,形成时序轨迹,用于:
- 速度估计(位置变化率)
- 行为预测(历史轨迹推未来)
- 稳定输出(避免检测抖动)
多目标跟踪(MOT)
图 2-5 多目标跟踪流程
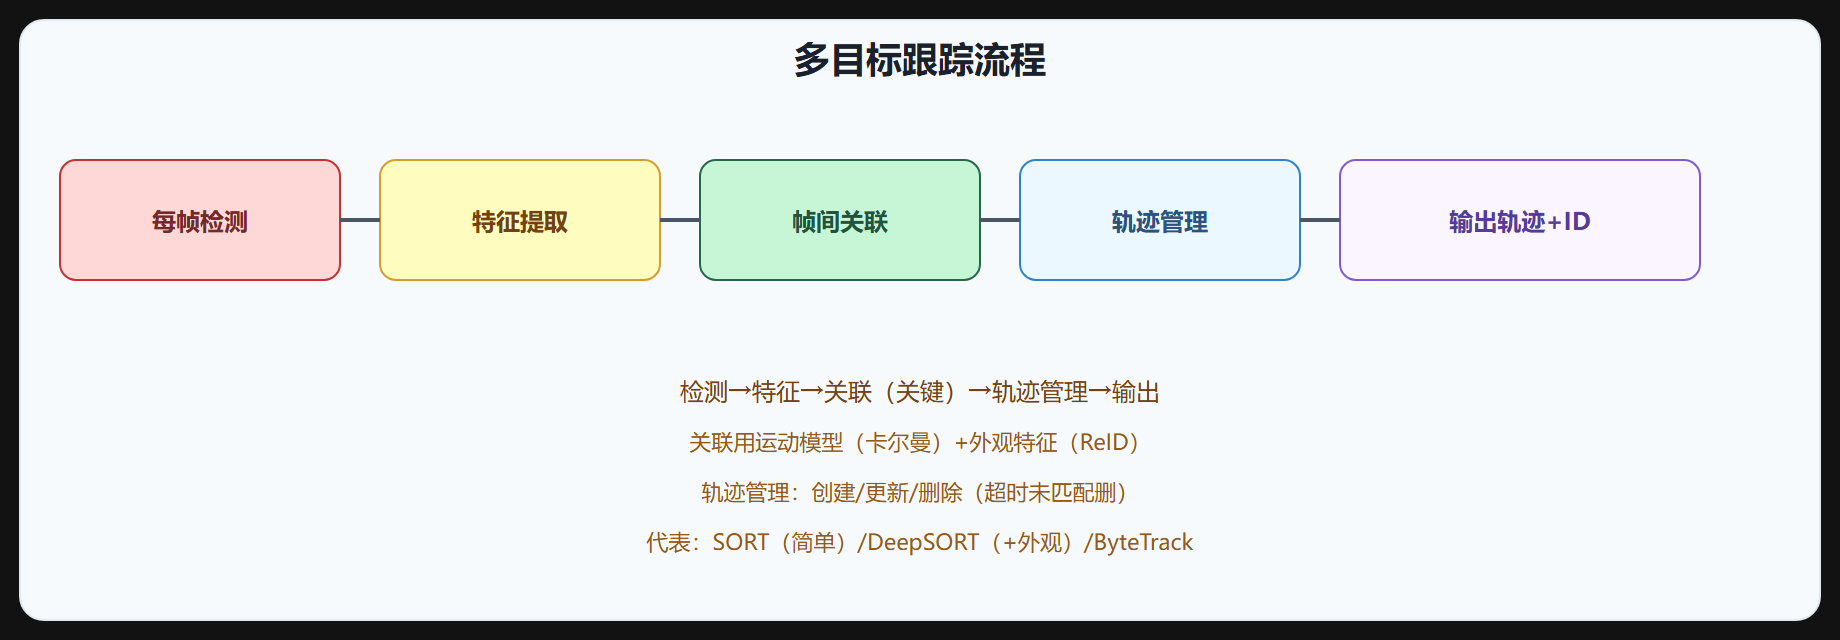
MOT 流程:
- 每帧检测:检测目标
- 特征提取:外观特征(ReID)
- 帧间关联:匹配当前检测与历史轨迹
- 轨迹管理:创建新轨迹、更新、删除丢失
- 输出:带 ID 的轨迹
关联方法
关联是核心,用两种信息:
- 运动模型:卡尔曼滤波预测下帧位置,与检测匹配
- 外观特征:ReID 特征相似度匹配
匈牙利算法做匹配。
代表算法
| 算法 | 特点 |
|---|---|
| SORT | 简单,仅卡尔曼+IoU 匹配 |
| DeepSORT | SORT + 外观 ReID 特征 |
| ByteTrack | 用低分检测,减少漏检 |
| FairMOT | 检测+ReID 联合 |
| MOTR | Transformer 端到端跟踪 |
自动驾驶常用 ByteTrack(高召回)或 DeepSORT(稳定)。
3D 跟踪
自动驾驶多在 3D 空间跟踪(BEV 或点云):
- 3D 卡尔曼滤波
- 3D 框关联
- 多传感器跟踪融合
挑战
- 遮挡:目标被挡后重新出现要重新关联
- ID 跳变:遮挡后 ID 变,轨迹断
- 密集:多目标易错关联
- 实时:30Hz 跟踪
跟踪与预测
跟踪输出历史轨迹,是行为预测(2.8 节)的输入:历史轨迹 → 预测未来路径。
⚠️ ID 跳变:目标遮挡后重新出现,跟踪可能给新 ID,轨迹断。自动驾驶要处理 ID 跳变,或用更长时序记忆。
💡 关键直觉:跟踪把跨帧目标关联给 ID,形成时序轨迹,用于速度估计和行为预测。MOT 流程:检测→特征→关联(卡尔曼+ReID)→轨迹管理。代表 SORT/DeepSORT/ByteTrack。挑战是遮挡和 ID 跳变。
要点速记
- 必要性:跨帧关联给 ID,形成轨迹,用于速度估计/预测/稳定。
- MOT 流程:检测→特征→关联→轨迹管理→输出。
- 关联:运动模型(卡尔曼)+外观特征(ReID),匈牙利匹配。
- 算法:SORT(简单)、DeepSORT(+ReID)、ByteTrack(高召回)、FairMOT、MOTR。
- 3D 跟踪:BEV/点云 3D 卡尔曼,多传感器融合。
- 挑战:遮挡、ID 跳变、密集、实时。
- 与预测:跟踪轨迹是行为预测输入。
下一节讲车道线检测。
卡尔曼滤波在跟踪里的角色
多目标跟踪里,卡尔曼滤波承担"预测加修正"两件事。对每个已有轨迹,用运动模型(通常是匀速模型)预测下一帧的目标状态(位置、速度、框尺寸);拿到检测结果后,用检测修正预测,得到更平滑的估计。预测值还能用来计算关联代价——检测框与预测框的 IoU 或马氏距离越小,越可能是同一个目标。匀速模型在高速公路上够用,但遇到急刹、变道,预测会滞后,这也是 SORT 类方法在复杂场景性能下降的主因。
# 伪代码:卡尔曼预测与更新(SORT 风格) for track in tracks: pred = kf.predict(track) # 匀速模型预测 cost = iou_matrix(pred.boxes, detections) # 关联代价 matches = hungarian(cost) # 匈牙利算法最优匹配 for track, det in matches: kf.update(track, det) # 修正状态
从 MOTA 到 IDF1:怎么评价跟踪
评价多目标跟踪不能用检测的 mAP。主流指标是 MOTA(多目标跟踪准确率),它把三类错误(漏检、误检、ID 跳变)折算成一个分数;还有 IDF1,它统计匹配对的准确率和召回率,更侧重跟踪的 ID 一致性。两者经常互相矛盾:一个系统可能 MOTA 高但 ID 频繁跳变,另一个系统 ID 很稳但漏检多。量产调优时要根据场景定优先级——十字路口场景更看重 IDF1(ID 稳定才好做轨迹预测),高速巡航则更看重 MOTA 的召回。实际工程里还有一个常用技巧:置信度分档关联。ByteTrack 把检测分成高置信度和低置信度两档,先用高置信度检测做匹配,未匹配的轨迹再用低置信度检测兜底。低分检测往往出现在遮挡边缘或目标刚出现的瞬间,兜底这一步能显著减少遮挡导致的轨迹断裂,实现简单、收益大,是跟踪模块里性价比最高的改动之一。
补充一个实际部署中的经验:跟踪模块的输入质量往往比跟踪算法本身更重要。检测的抖动、漏帧、类别误判都会直接传导到跟踪里,所以上线前要先做"检测到跟踪"的联调——给检测输出加最小置信度门槛和类别置信度过滤,在跟踪入口做一帧缓冲去抖。另一方面,跟踪结果的输出频率通常低于检测(检测 30Hz,跟踪 10Hz),中间用运动外推补齐,这样下游规划拿到的目标轨迹始终是连续的。把跟踪当成一个"检测后处理加状态管理"的模块来对待,比孤立调跟踪算法更能解决实际问题。