2.8 运动预测 (Motion Prediction)
2.8 运动预测 (Motion Prediction)
本节摘要:光知道目标在哪不够,还要预测它要去哪。本节讲运动/行为预测——自动驾驶安全决策的关键。
学习目标
阅读完本节,你应当能够:
- 理解预测的必要性
- 知道轨迹和意图预测
- 了解代表模型
概念脉络
为什么需要预测
自动驾驶决策要考虑未来:前车会不会变道?行人会不会过马路?仅靠当前检测不够,需预测他车未来行为,提前规划。
预测类型
图 2-8 运动预测
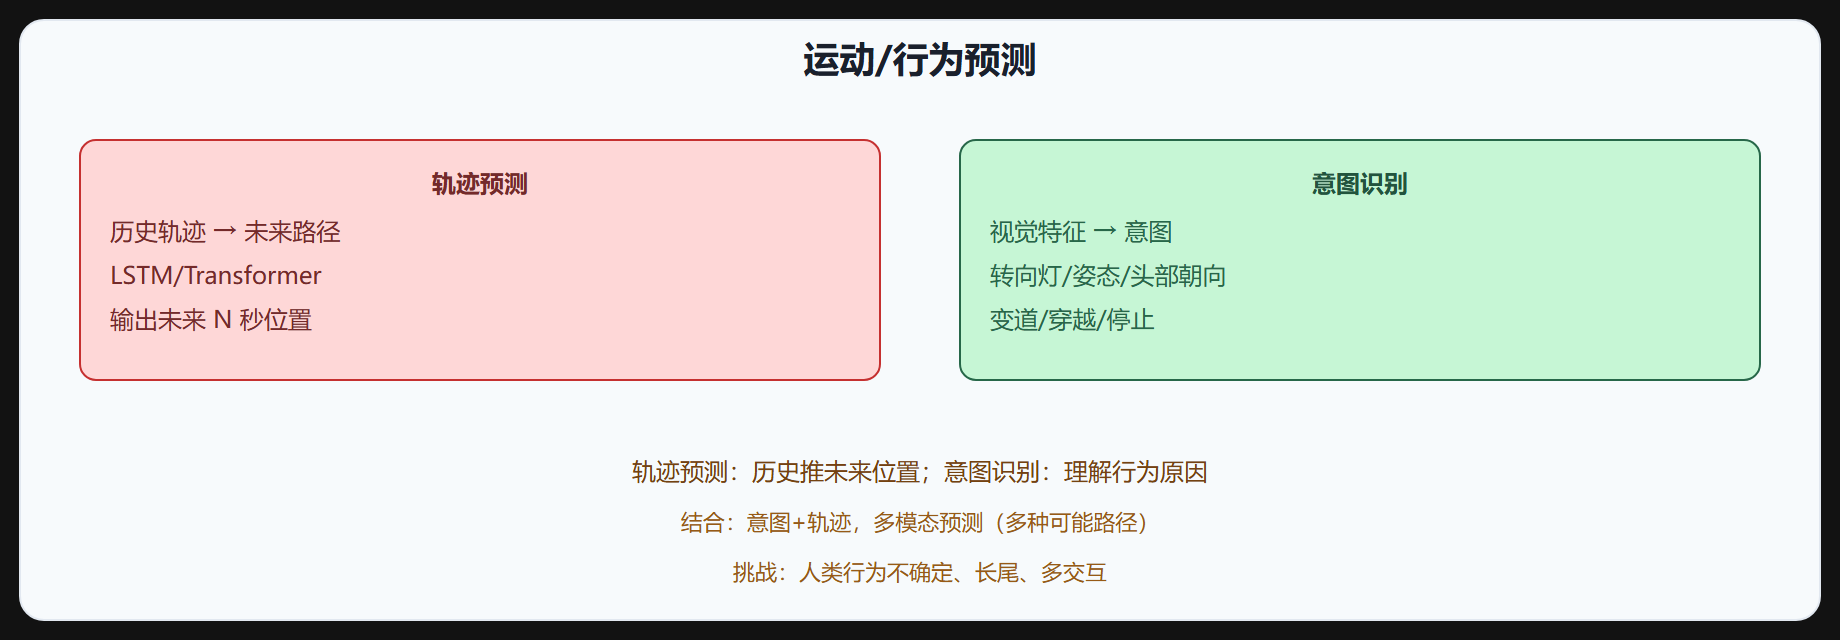
| 预测类型 | 说明 |
|---|---|
| 轨迹预测 | 历史轨迹推未来路径 |
| 意图识别 | 理解行为意图(变道/穿越) |
轨迹预测
轨迹预测用历史轨迹推未来 N 秒位置:
- 输入:历史轨迹(跟踪输出)+ 当前视觉
- 输出:未来 3-5 秒轨迹(多模态,多种可能)
- 模型:LSTM、Transformer、图神经网络
# 简化轨迹预测 trajectory = LSTM(history_trajectory) # 历史推未来 future_positions = trajectory.predict(steps=30) # 未来30帧
意图识别
意图识别比轨迹预测更进一步,理解行为原因:
- 车辆意图:变道(看转向灯)、转弯、停车
- 行人意图:过马路(看头部朝向、姿态)
- 输入:视觉特征(转向灯、姿态)+ 轨迹
- 输出:意图类别
意图识别帮助更准预测(知道要变道,轨迹预测更准)。
多模态预测
人类行为不确定,未来有多种可能。多模态预测输出多条可能轨迹 + 概率:
- 车辆可能直行(0.6)或变道(0.4)
- 行人可能过马路(0.3)或停留(0.7)
决策考虑多种可能,更安全。
代表模型
| 模型 | 特点 |
|---|---|
| Social-LSTM | 社交互动 LSTM |
| Social-GAN | GAN 多模态预测 |
| VectorNet | 向量表示+图网络 |
| LaneGCN | 车道图卷积 |
| DETR3D/DETR-Pred | Transformer 端到端检测+预测 |
挑战
- 不确定性:人类行为随机
- 长尾:罕见危险行为数据少
- 多交互:多目标互相影响
- 实时:30Hz 预测
预测与决策
预测输出给决策规划:
- 预测他车轨迹 → 规划避让
- 预测行人过马路 → 减速
- 多模态预测 → 考虑最坏情况
⚠️ 预测不确定性:人类行为不确定,预测不可能 100% 准。用多模态预测+概率,决策考虑最坏情况,留安全余量。
💡 关键直觉:预测他车未来行为,是安全决策关键。轨迹预测(历史推未来,LSTM/Transformer),意图识别(理解行为原因)。多模态预测输出多种可能+概率。挑战不确定性/长尾/交互。决策考虑最坏情况留余量。
本节速览
- 必要性:预测他车未来,提前规划避让。
- 类型:轨迹预测(历史推未来)、意图识别(行为原因)。
- 轨迹预测:LSTM/Transformer/图网络,输出未来 N 秒位置。
- 意图识别:转向灯/姿态/头部朝向,变道/穿越/停止。
- 多模态:多种可能轨迹+概率,应对不确定性。
- 模型:Social-LSTM、Social-GAN、VectorNet、LaneGCN。
- 挑战:不确定性、长尾、多交互、实时。
- 决策:预测→规划避让,考虑最坏情况留余量。
下一节讲姿态估计。
预测的输入与输出表示
轨迹预测的输入通常包含三部分:目标的历史轨迹(过去 2-3 秒,由跟踪提供)、目标周围的语义环境(车道拓扑、红绿灯状态、其他车的位置)、目标自身意图信号(转向灯、是否在车道中间)。输出是未来 3-8 秒的多条候选轨迹,每条带一个概率。这里的核心矛盾是"多模态"——同一个历史,未来有多种合理走法(直行或变道),模型要一次性输出所有候选并给出合理置信度,而不是取平均(取平均会把"左转和右转"平滑成"直行",是预测的大忌)。
历史轨迹 + 车道图 + 交互目标 -> 编码器(Transformer/图网络) -> 多模态解码器 -> K 条候选轨迹 + 概率 -> 场景解码器(碰撞检查/换道意图) -> 最终评分
交互建模与评估
自车决策最大的不确定性来自其他车对自车动作的反应——两车抢道时,对方的动作依赖自车的动作。图神经网络把场景建成"节点是车或车道、边是相对关系"的图,用消息传递建模交互,是处理这类问题的常用框架。评估预测不能只看平均位移误差(ADE),还要看最终位移误差(FDE)和最差候选命中率;规划端更关心"预测是否覆盖了真实轨迹"以及"概率最高的那条是否安全"。一套好的预测系统,最终目标不是猜中一切,而是让规划在任何候选出现时都有安全预案。